Perplexity、AppleでAIを速く動かす技術を公開
Perplexity Open Sources Lily: A Rust + Metal Inference Engine for Qwen3.6-35B-A3B on Apple Silicon
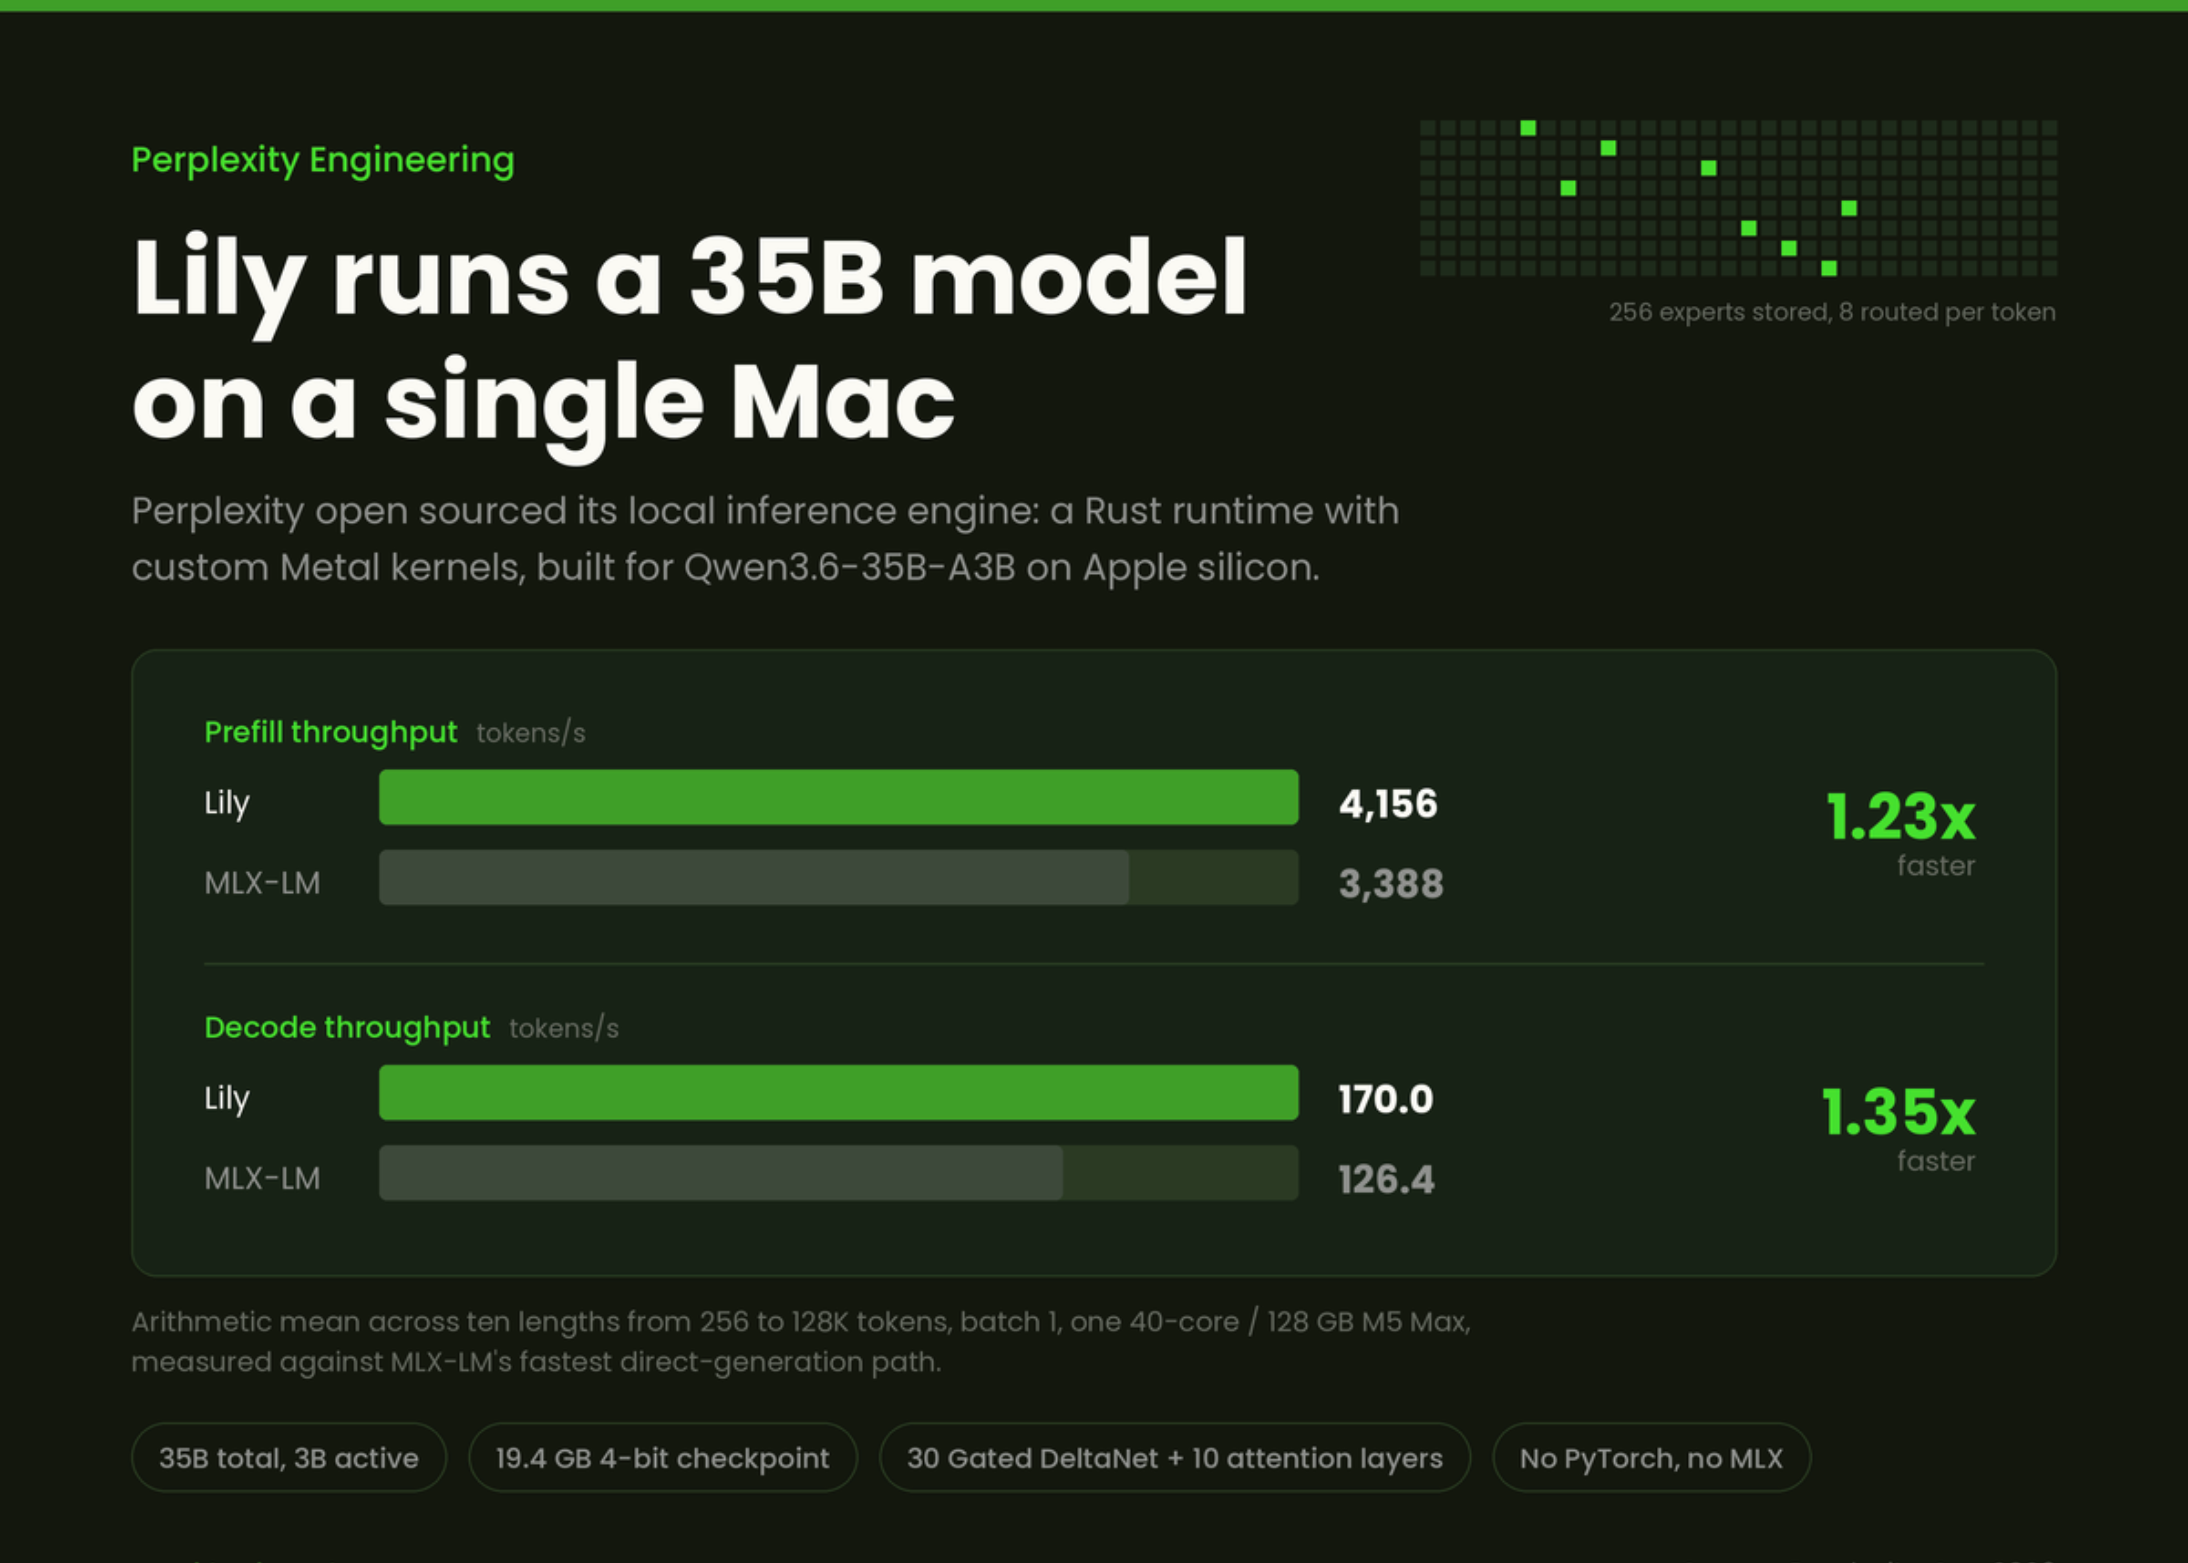
Perplexityが、Apple製品でAIを速く動かす技術「Lily」を公開。Macユーザーは高性能なAIをよりスムーズに利用可能になります。
Perplexityは、Perplexity ComputerのHybrid Computeを支えるローカル推論エンジンであるLilyをオープンソース化しました。 これはシングルプロセスランタイムです。Rustレイヤーがチェックポイントをロードし、生成ループを駆動し、OpenAI互換のchat-completions APIがトークンをストリームし、手書きのMetalカーネルがモデルを実行します。PyTorchもMLXも実行パスにはありません。Lilyは、Qwen3.6-35B-A3Bという一つのモデルを、一つのハードウェアファミリーで動かすことに意図的に特化しており、その特化こそがパフォーマンスの根拠となっています。デプロイ可能か?はい。スタンドアロンのデモはpplx-gardenリポジトリで公開されています。これは、最小限のOpenAI互換HTTP APIを通じて、貪欲なテキスト生成を提供するRustとMetalによる推論サーバーです。4-bitチェックポイントは19.4 GBであるため、32 GB以上のユニファイドメモリを搭載したApple silicon Macが現実的な最低要件です。Perplexityが出荷しているHybrid Compute製品では、macOS 15+、最低24 GB、最高のパフォーマンスには32 GBを推奨しています。なぜそもそも特化するのか?デフォルトのMacスタックはMLXとMLX-LMであり、これらにはすでにグループ化されたエキスパートワーク、融合された再帰Metalカーネル、GQA対応のアテンションを備えたQwenの実装が含まれています。しかし、その操作はアーキテクチャ間で再利用可能でなければなりません。Lilyはそれを諦め、モデル構造、実行計画、カーネル選択を一つのランタイムにまとめています。 3つのワークロード形状。Qwen3.6-35B-A3Bは350億のパラメータを保存し、トークンあたり約30億をアクティブ化します。ルーターは256のエキスパートをスコアリングし、8つを選択します。これに加えて、すべてのトークンを見る共有エキスパートが1つあります。また、グループ化されたクエリ・アテンション(16のクエリヘッド、2つのKVヘッド)を使用する10のフルアテンションレイヤーと、30のGated DeltaNetレイヤーを組み合わせています。これにより、不均一なエキスパートグループ、成長するKVキャッシュに対するアテンション、固定サイズの再帰という3つのパターンが生まれます。 Prefill: 重みをパックしたままにし、ルーティングをGPU上で行う。チェックポイントはグループワイズアフィン4-bit量子化を使用しており、64個の重みグループごとにbfloat16のスケールとバイアスを共有し、約70 GBのbfloat16の重みが19.4 GBに圧縮されています。Metal 4のテンソル操作はbfloat16を消費するため、重みは
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。