ノキア、AIの判断を正確にする技術公開
Nokia Open-Sources AnyJev: A Training-Free Layer That Turns Any Open LLM Into a Calibrated Decision Model
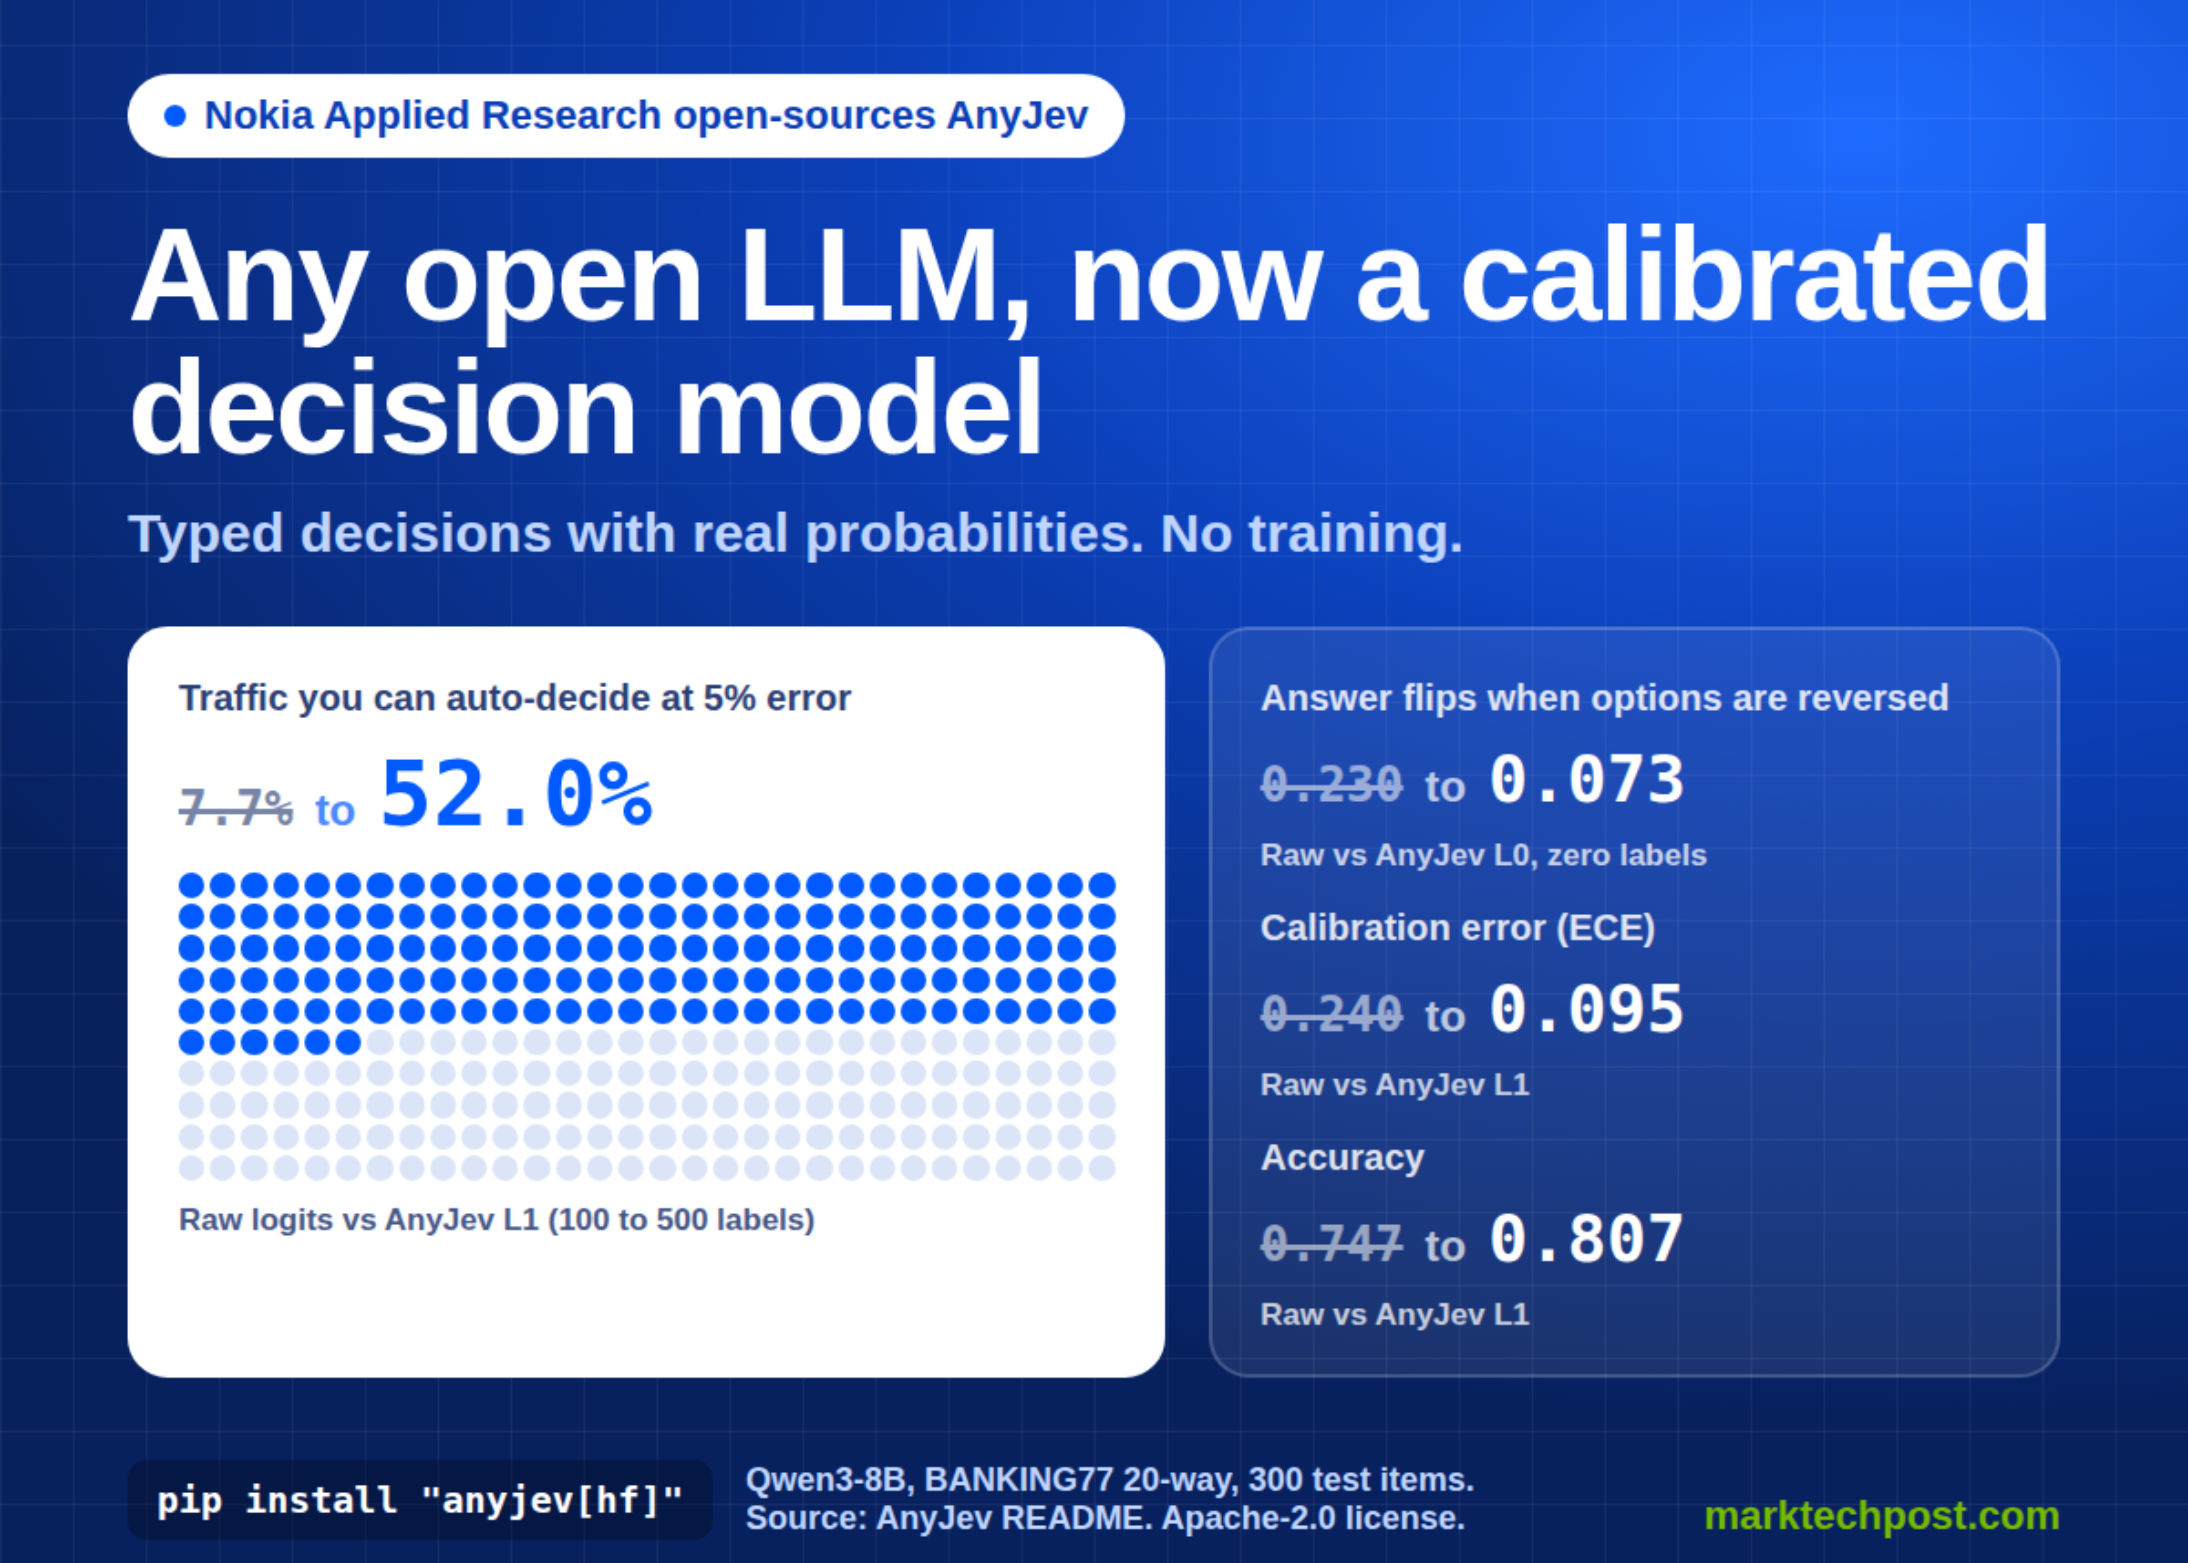
ノキアが、既存の文章を書くAI(LLM)を訓練なしで、より正確な判断ができるようにする技術「AnyJev」を公開。AIの判断ミスを減らし、実用性を高めます。
Nokiaの応用研究チームは、オープンなLLMを意思決定モデルに変えるPythonライブラリであるAnyJevをオープンソース化しました。これは訓練を必要としません。文章を生成するのではなく、固定された選択肢の中から1つの答えを選ぶという一般的な実運用タスクを対象としています。展開可能か?はい、PyPIからインストールでき、Apache-2.0ライセンスで提供され、共有プレフィックススコアリングを備えたtransformersおよびvLLMバックエンドをサポートしています。AnyJevとは?AnyJevはそのインターフェースをJevから借用しています。Jevは、TypeSafe AIが2026年9月に発表したSystem One意思決定モデルです(当社の記事)。AnyJevに型付けされた質問を与えると、しきい値を設定できる確率とともに決定が返されます。その確率は、モデルの次のトークン分布から読み取られます。何も生成、解析、訓練されることはありません。このライブラリは3つの質問タイプをサポートしています。選択肢質問はK個のオプションから1つを選びます。名詞質問ははい/いいえです。スコア質問は、答えをいくつかの順序付けられたビン(区画)の1つに配置します。直接Logitsを読み取る際の問題点多くのオープンプロジェクトは、すでに次のトークンをオプションラベルに制限し、スコアを読み取っています。Nokiaの研究チームは、このショートカットには2つの欠陥があると指摘しています。第一に、オプションの順序が変更されると答えが変わる可能性があります。第二に、確率はキャリブレーションされていません。レベルドキュメントは2つの原因を挙げています。1つ目は事前バイアスです。モデルは入力に関わらず、「Yes」のような特定のラベルを「No」よりも好む傾向があります。2つ目は位置バイアスです。モデルはオプションリスト内の特定の位置を好む傾向があります。AnyJevの仕組み:L0とL1すべての決定にはレベルフィールドが含まれます。L0(ラベルなし、デフォルトでオン)は2つの修正を適用します。循環シフト。K個のオプションを持つ質問の場合、リストはK回のローテーションで表示され、すべてのオプションがすべての位置に一度現れます。結果は対数空間で幾何平均として結合されます。位置バイアスがlogit空間で加法である場合、これはそれを正確に除去します。事前補正。デフォルトでは、AnyJevはバッチキャリブレーションを使用します。これは、実際の入力で予測された分布の実行平均を保持し、その強度で割り出します。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。