音声で算数を解くAIが登場
Kyutai Releases Voice of Reason: A Speech-Native Model that Solves Spoken Math with Reinforcement Learning
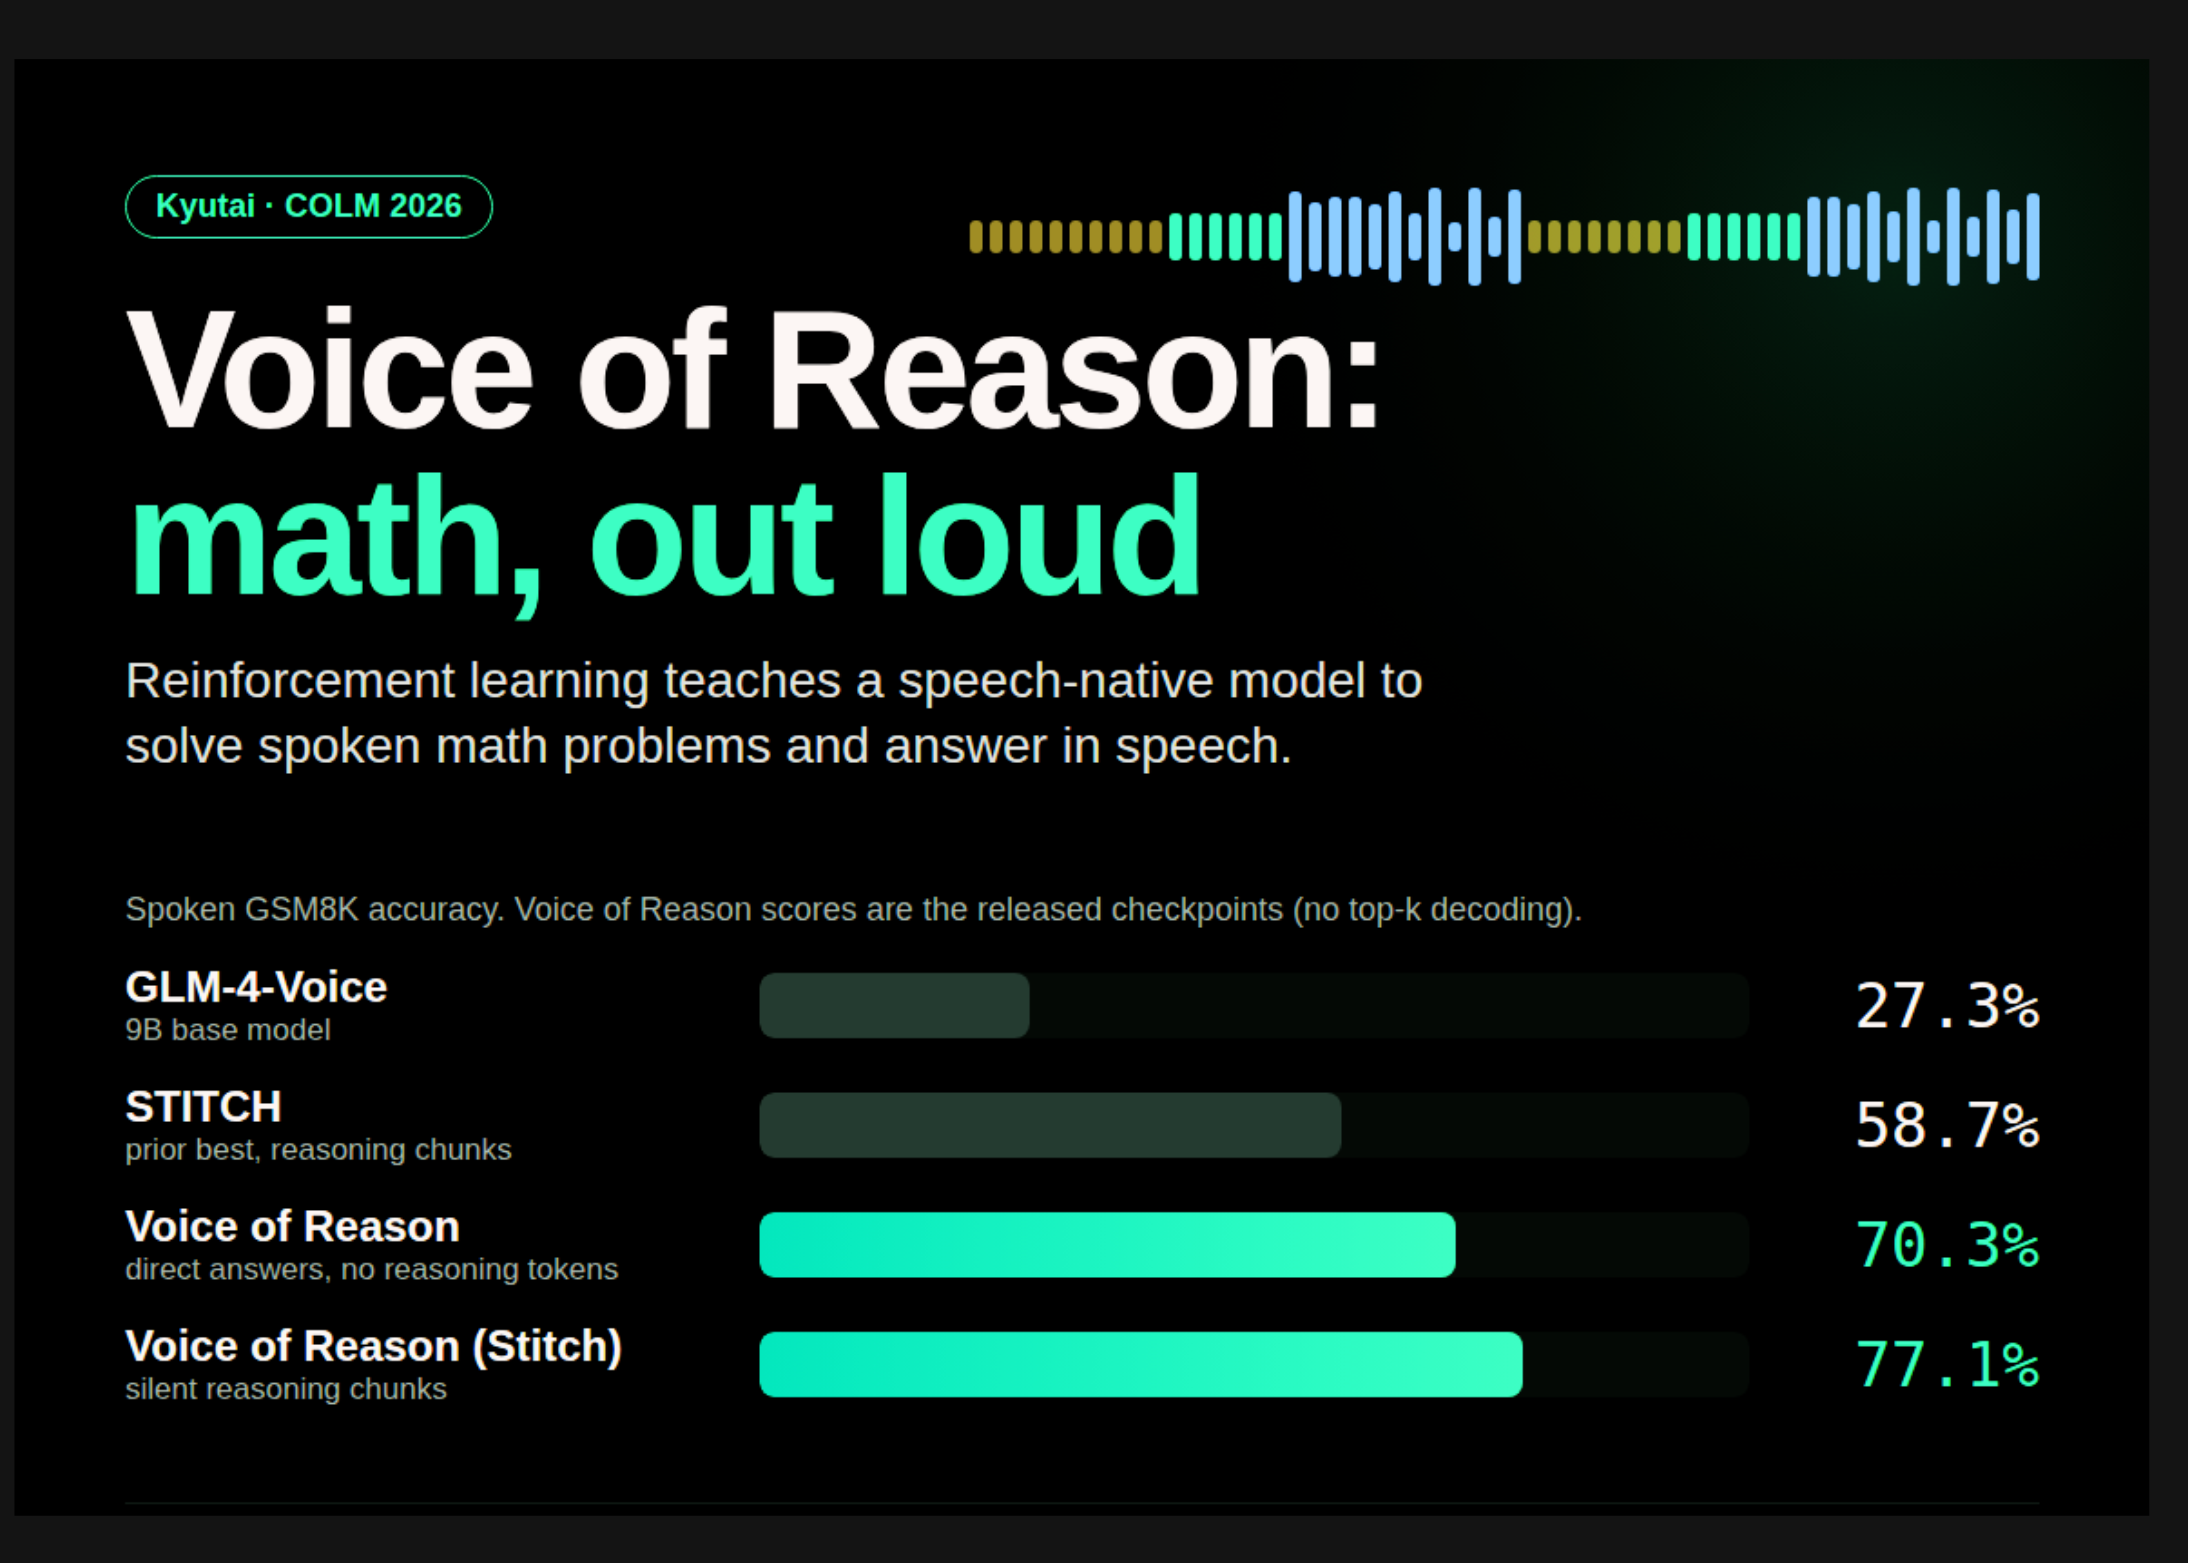
Kyutaiが、音声だけで算数を解くAI「Voice of Reason」を公開。文字変換なしで直接考えるため、会話のように自然に算数を解決できる可能性を秘めています。
Kyutaiは、声に出して数学の問題を解く2つのオープンウェイトの音声対音声モデル「Voice of Reason」をリリースしました。どちらのモデルもGLM-4-Voice-9Bをベースにしており、supervised fine-tuning (SFT)とreinforcement learning (RL)が追加されています。文字起こしステップや、別途テキストLLMを介するプロセスはありません。音声によるGSM8Kのテストでは、ベースモデルの精度が27.3%だったのに対し、77.1%に向上しました。これは展開可能でしょうか?はい、セルフホスティング向けに可能です。Kyutaiは両方のBF16チェックポイントを1つのH100で実行しました。また、その音声トークナイザーとデコーダーのためにGLM-4-Voiceリポジトリも必要です。ウェイトはGLM-4-Voiceライセンスを継承しており、Hugging Faceの推論プロバイダーはまだこれらをホストしていません。なぜ音声モデルは数学で遅れているのかカスケード型パイプライン(音声からテキスト、テキストLLM、テキストから音声)は、推論において依然として優位です。しかし、各ステージでレイテンシが増加し、パイプラインは声のトーンのようなパラ言語的な手がかりを失います。音声ネイティブモデルは、対話性を維持するために定期的に音声を生成する必要があります。これにより、モデルが利用できる隠れた推論トークンの数が制限されます。ベースのGLM-4-VoiceはGSM8Kで27.3%のスコアです。以前のSTITCHメソッドは、推論チャンクを追加することでこれを58.7%に引き上げました。研究チームは、彼らの研究を音声ネイティブモデルにおける数学推論へのRLの最初の適用と呼んでいます。トレーニングの仕組みGLM-4-Voiceは、13個のテキストトークン、次に26個のオーディオトークンを繰り返して出力をインターリーブします。ステージ1 SFT:トレーニングにはOrca-Mathから150,616問の問題が使用されます。Qwen3-235Bが各問題を音声用に書き換えました。KyutaiのDSM TTSがそれらを多くの声で音声化しました。SFTだけでGLM-4-Voiceは27.3%から61.7%に向上します。ステージ2 RL:各発話された質問に対して、モデルは温度0.9で4つの返答をサンプリングします。Qwen3-235B-A22B-2507という評価者が、デコードされたテキストを二値報酬でスコアリングします。評価者は参照回答を見ることはありません。100件の手動チェックケースでは、人間と88%の確率で一致しました。報酬は各グループ内で中央値化され、グループ相対的なREINFORCE目標を形成します。これはGRPOに関連していますが、PPOクリッピングとKL正則化を削除しています。トレーニングは16台のH100 GPUで実行され、1,500回のRL更新が行われました。2つの設計上の選択が
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。