Pythonで科学データ分析を効率化
Scientific Data Analysis with LabPlot in Python: Signal Processing, Spectral Peak Fitting, Visualization, and Batch Automation
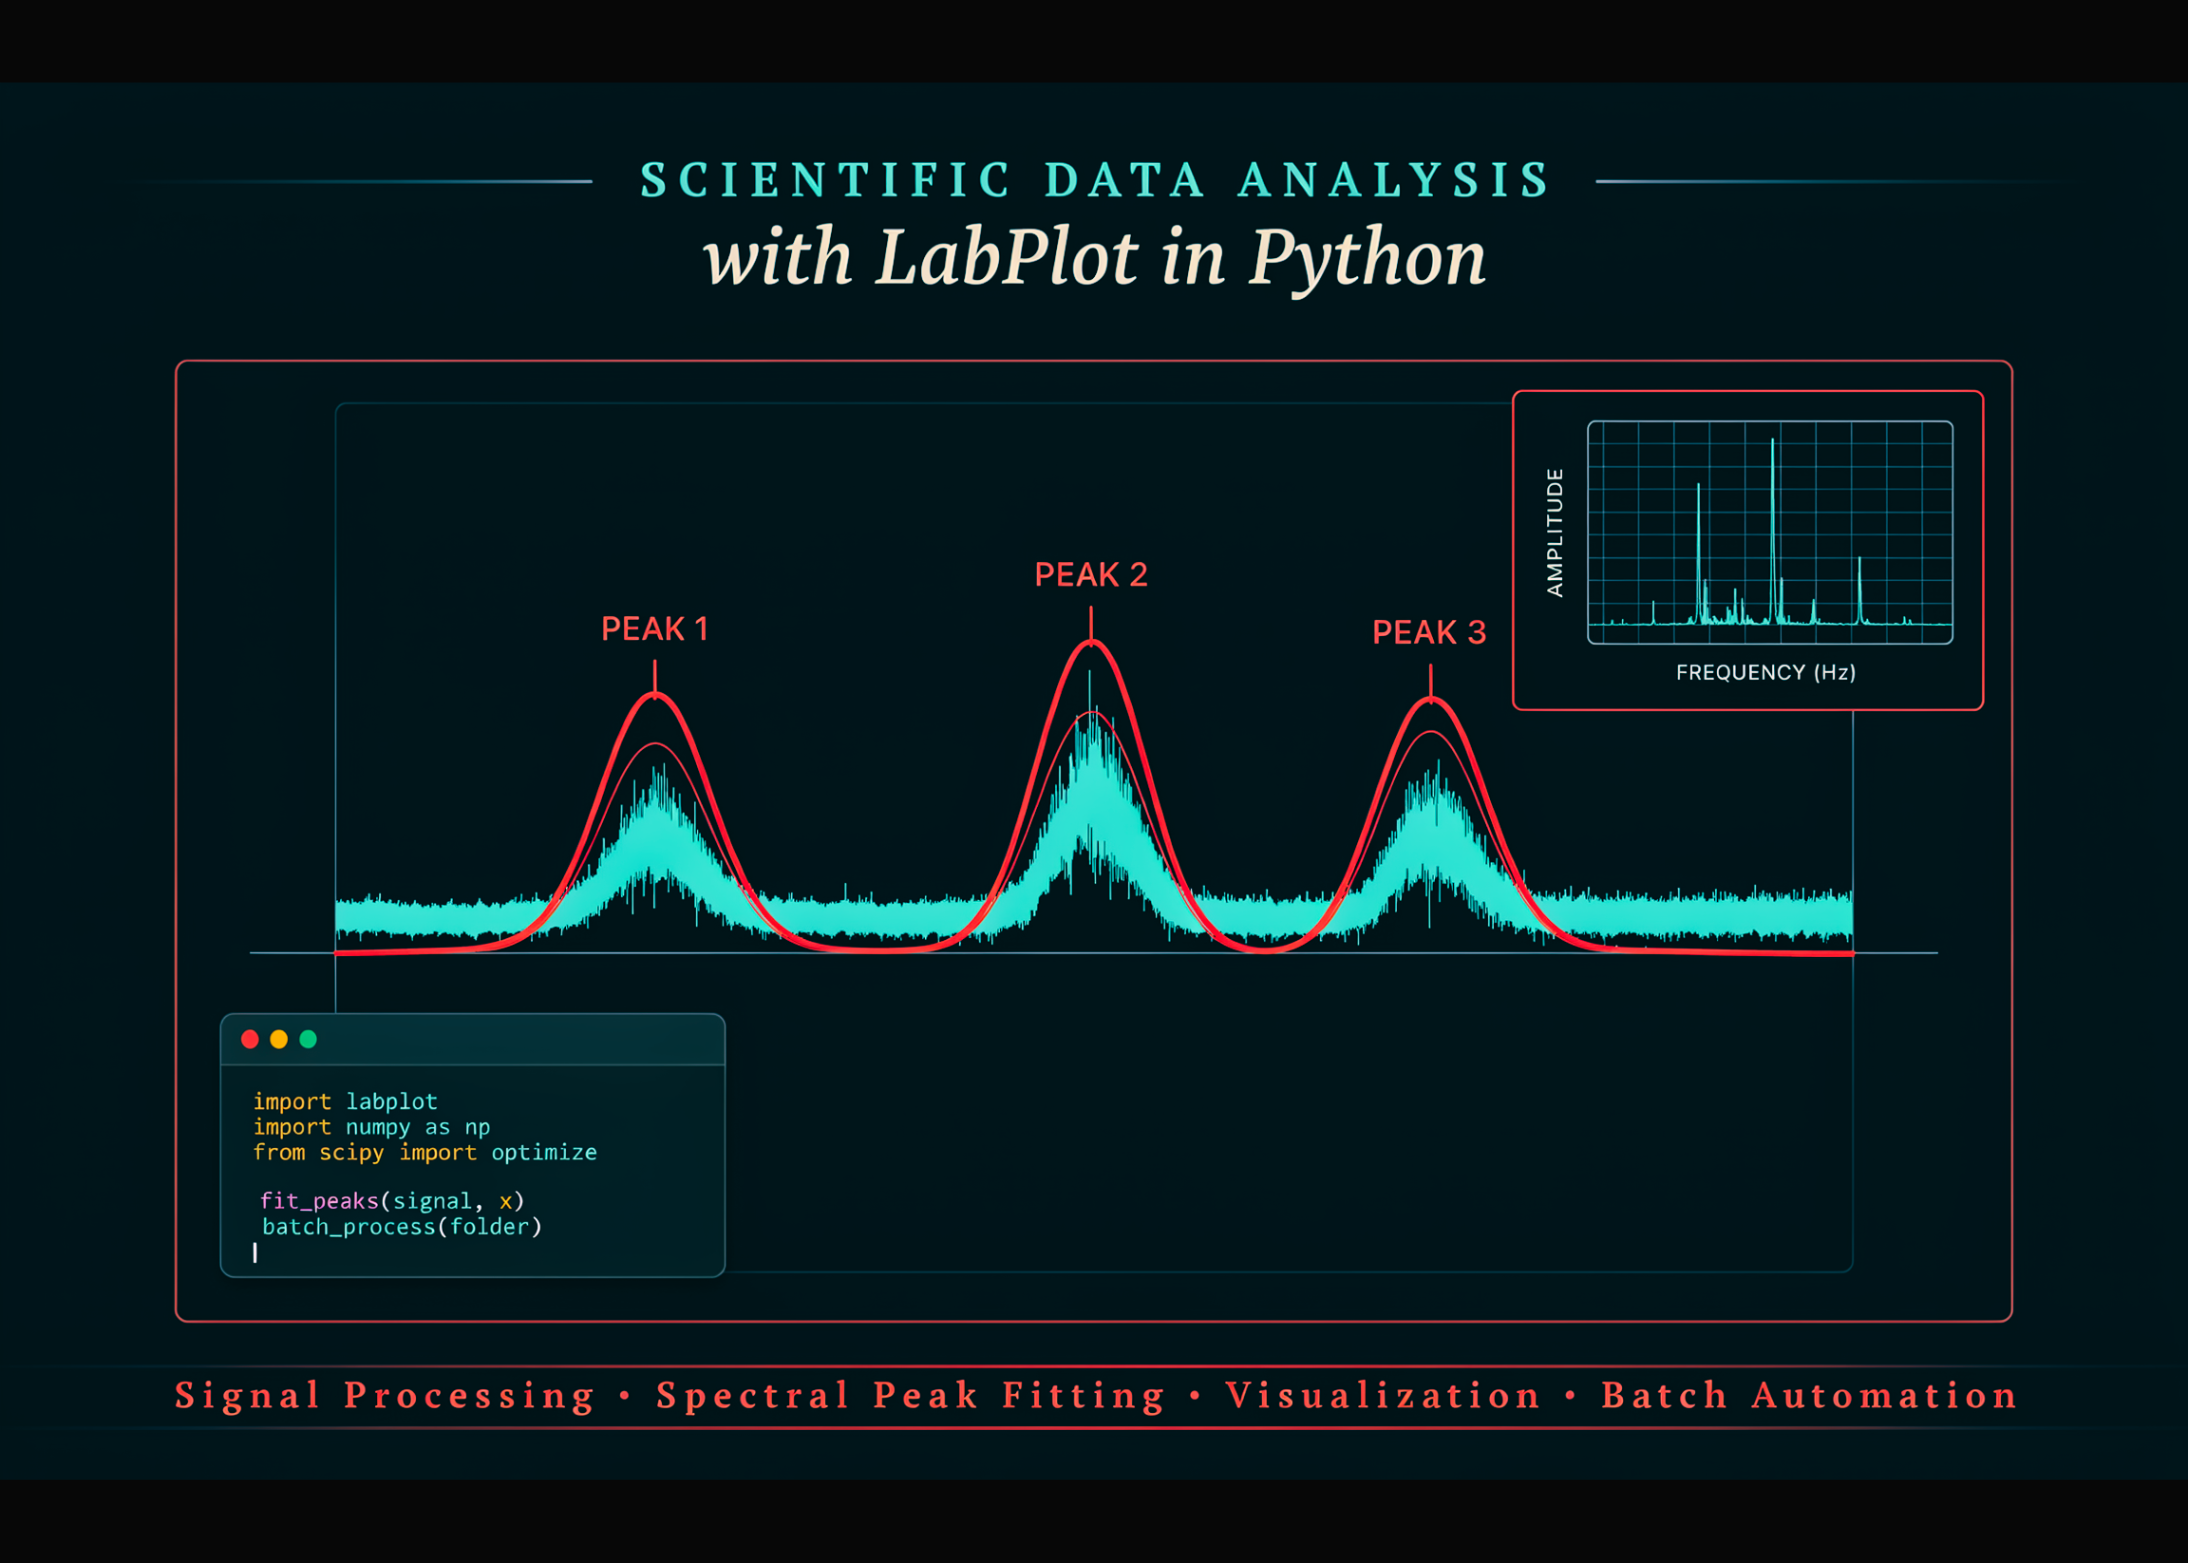
Pythonで科学データ分析の作業を効率化する手法が公開され、複雑なデータをより簡単に、そして大量に処理できるようになり研究を加速させます。
このチュートリアルでは、LabPlotのaspect tree、analysis kernels、plotting system、project modelの構造と用語を維持しながら、PythonでLabPlotにインスパイアされた科学データ分析ワークフローを探求します。 構築するのは、表形式データのインポート、記述統計の計算、信号の平滑化と微分、フーリエ解析とフィルタリングの実行、ピークの検出、曲線の積分、データの削減、詳細な統計診断を伴う非線形モデルのフィッティングを行うための再利用可能なコンポーネントです。 次に、これらのツールを現実的な分光法の例に適用します。周期的な干渉の除去、重複するピークの特定、multi-Gaussianモデルのフィッティング、残差の検査、テーマ付きワークシートによる結果の視覚化、図のエクスポート、LabPlot互換の.lml形式ファイルでのプロジェクトデータの保存です。 最後に、同じワークフローをバッチ処理に拡張し、複数の温度依存スペクトルを分析し、結果として得られる測定値全体で二次的な傾向をフィッティングできるようにします。 Copy Code Copied Use a different Browser import os, sys, gzip, bz2, lzma, time, math, textwrap, warnings import xml.etree.ElementTree as ET from dataclasses import dataclass, field from enum import Enum import numpy as np, pandas as pd, matplotlib, matplotlib.pyplot as plt from matplotlib.ticker import AutoMinorLocator import scipy from scipy import signal, stats, optimize warnings.filterwarnings("ignore", category=RuntimeWarning) np.random.seed(20260815) IN_COLAB = "google.colab" in sys.modules OUT = "/content/labplot_out" if IN_COLAB else os.path.join(os.getcwd(), "labplot_out") os.makedirs(OUT, exist_ok=True) try: from pylabplot import *; HAVE_SDK = True except Exception: HAVE_SDK = False banner = lambda t: print("\n" + "=" * 76 + f"\n {t}\n" + "=" * 76) banner("environment") print(f" numpy {np.__version__} | scipy {scipy.__version__} | mpl {matplotlib.__version__} | " f"colab={IN_COLAB} | pylabplot={'yes' if HAVE_SDK else 'no -> emulation'}\n -> {OUT}") class PlotDesignation(Enum): NoDesignation = 0; X = 1; Y
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。