AI利用料9割減、応答15倍速に
Meet Redis LangCache: A Managed Semantic Cache That Cuts LLM API Costs by Up to 90% and Returns Cache Hits Up to 15x Faster
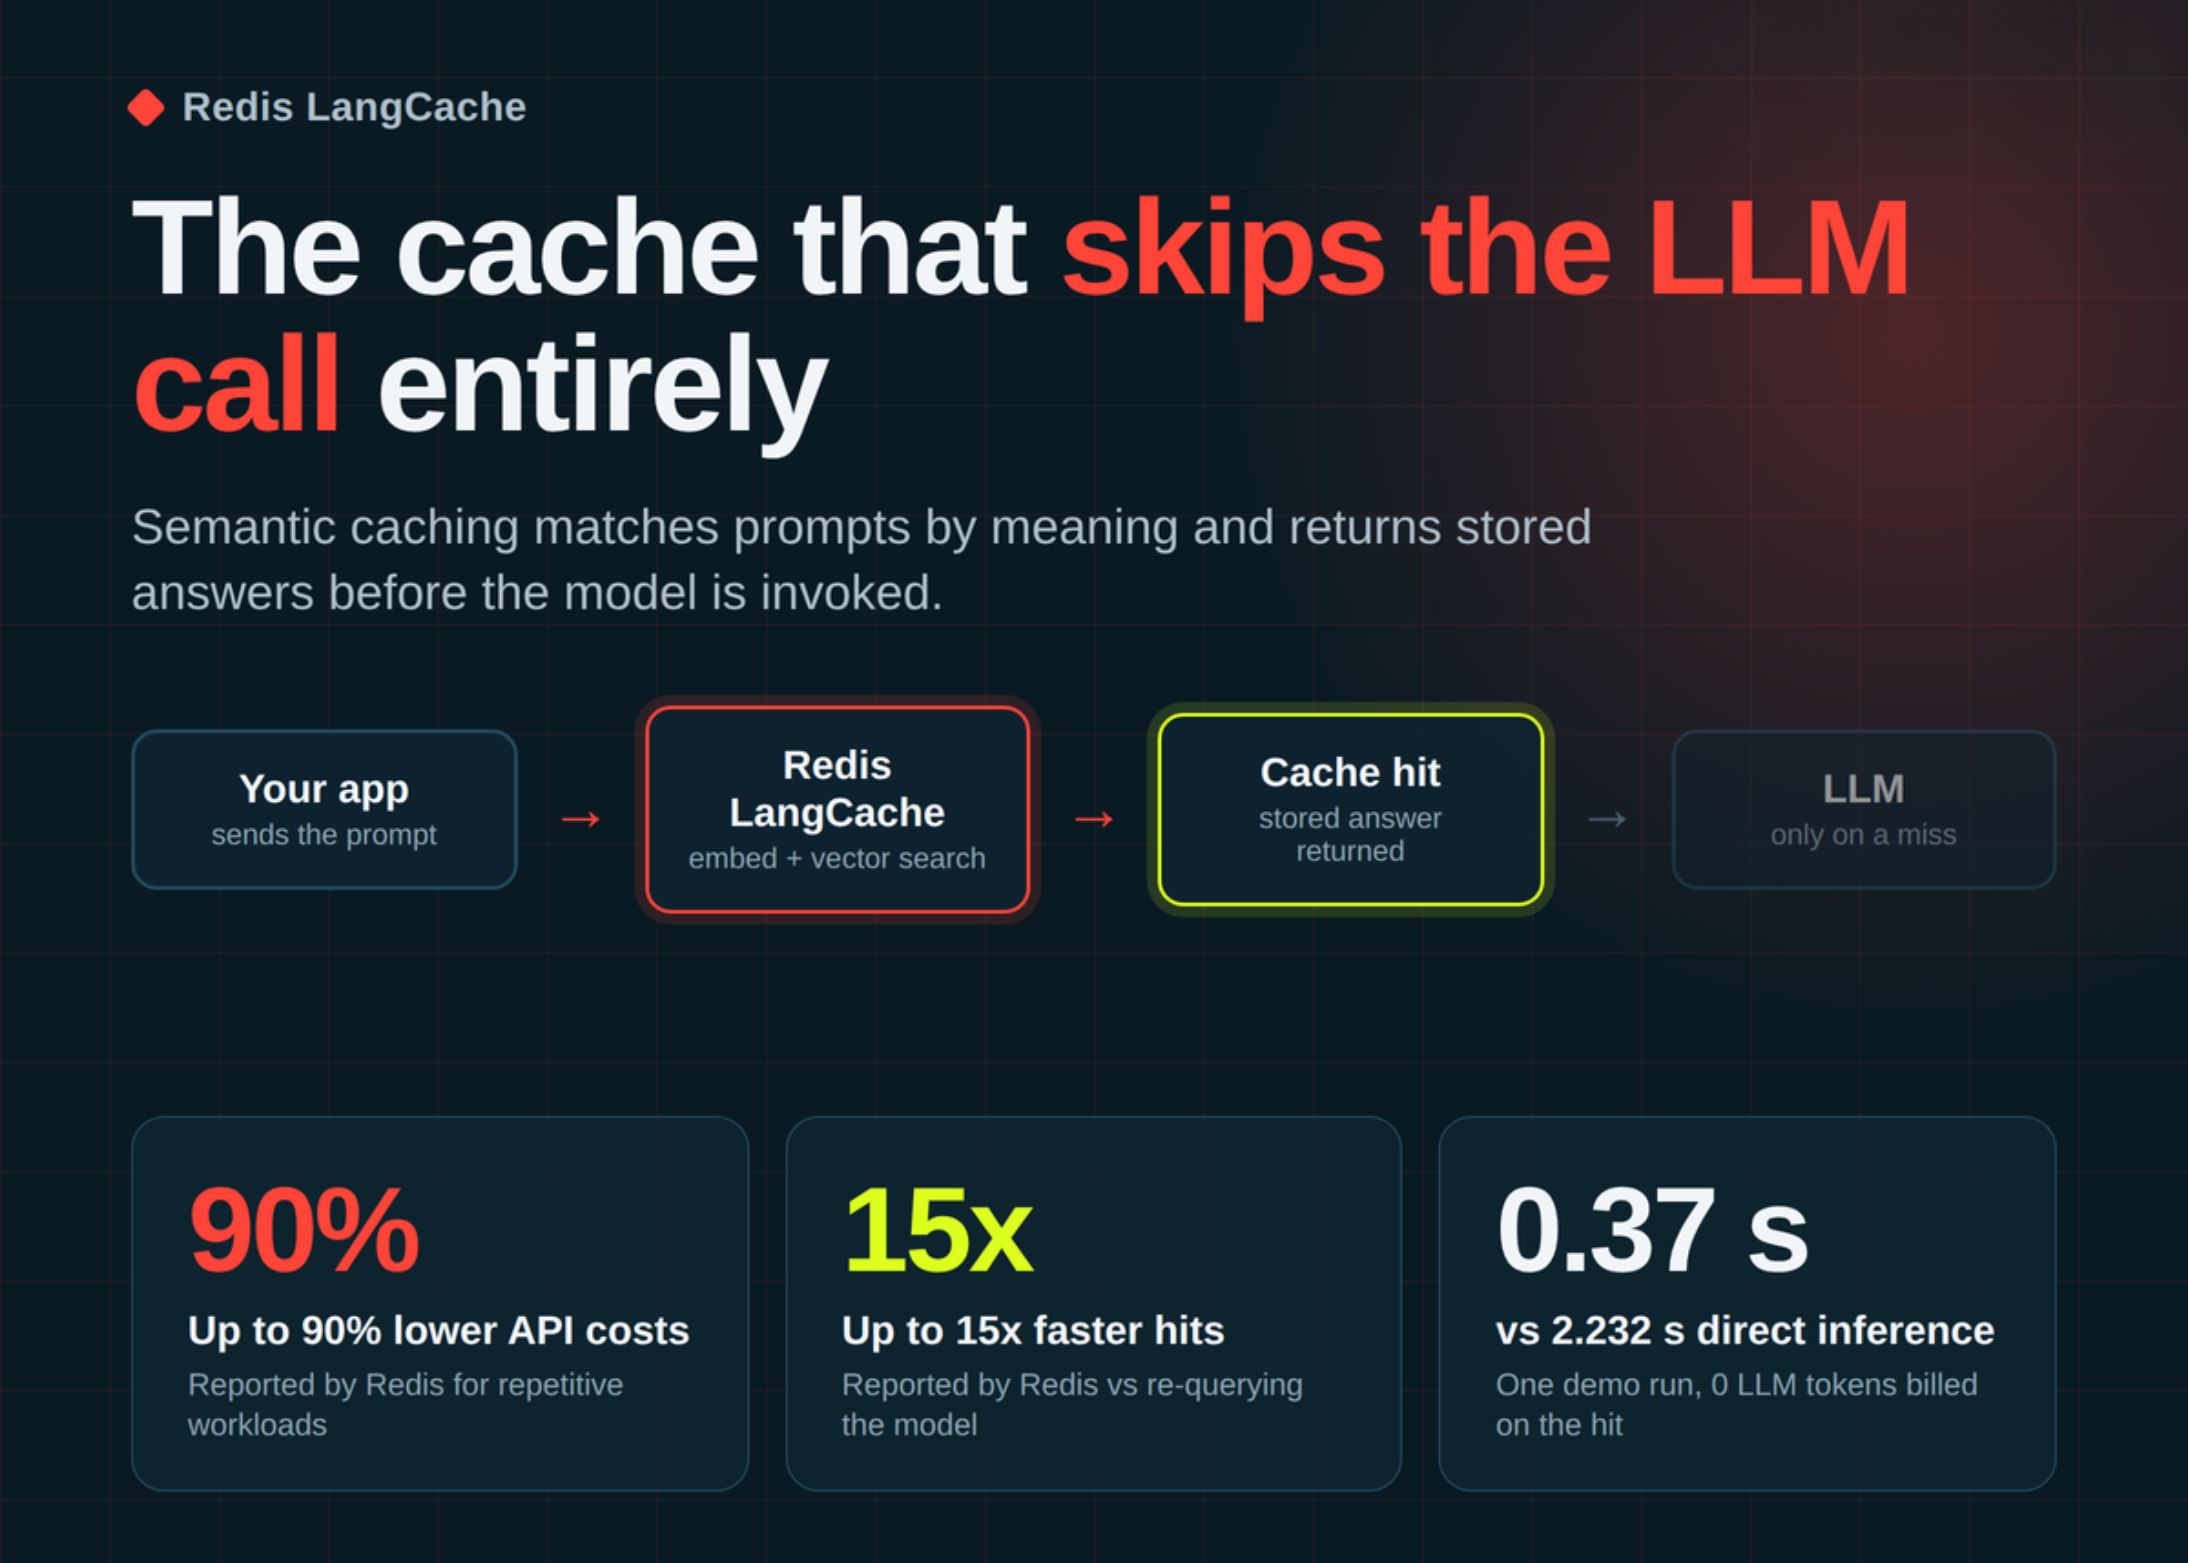
Redis LangCacheは、AIへの質問の意味を理解し、過去の回答を再利用することで、AIの利用料を最大90%削減し、応答速度を最大15倍に向上させます。
実用的なLLMアプリケーションは、これまで誰も質問したことのない質問を受けることはめったにありません。サポートアシスタントやRAGパイプラインは、毎日何千回も同じ意図の質問に対応しますが、それぞれの表現は異なり、ほとんどのシステムはすべての表現を新規の、完全に課金されるリクエストとして扱います。Redis LangCacheは、アプリケーションとモデルの間に位置するフルマネージドのsemantic cachingサービスです。これは、入ってくるプロンプトを、正確なテキストではなく意味によって以前に回答されたものと照合し、十分に一致するものがあれば保存された応答を返します。Redisは、モデルに再クエリするよりもAPIコストを最大90%削減し、cache-hit応答を最大15倍高速化すると報告しています。デプロイ可能か?はい。LangCacheは本日よりRedis Cloudでパブリックプレビューとして利用可能で、REST APIとPythonおよびJavaScript SDKを介してアクセスできます。Redisは、プレビュー期間中に機能や動作が変更される可能性があると述べています。問題点:言い換えも完全なLLM呼び出しになる。カスタマーサポートアシスタントへの3つのリクエストを考えてみましょう:「月額プランを購入後、返金は受けられますか?」「月額サブスクリプションは返金可能ですか?」「プランをキャンセルしてお金を取り戻せますか?」言い回しは異なりますが、質問と回答は同じです。semantic cacheがない場合、それぞれのバージョンが完全な生成をトリガーします。入力トークンが処理され、出力トークンがデコードされ、ユーザーは待機します。prefix cachingは、そのコストの一部しか削減しません。リクエストがシステムプロンプトやコンテキストを共有する場合、エンジンはそのprefixのために計算されたKV statesを再利用しますが、リクエストは依然としてLLMに到達し、新しいトークンは処理され、完全な回答はデコードされます。prefix-cacheのヒットは、回避されたものではなく、より安価な生成呼び出しです。LangCacheの仕組み。LangCacheはキャッシュをモデルの外に移動させ、生成された応答自体を保存します。そのアーキテクチャは2つの呼び出しループです。モデルを呼び出す前に、アプリはプロンプトをPOST /v1/caches/{cacheId}/entries/searchに送信します。LangCacheはプロンプトのembeddingを生成し、sに対してvector searchを実行します。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。