動画生成AIの処理を高速化
Nunchux AI Introduces VC-Attention: A Training-Free Low-Bit Attention Kernel That Speeds Up Video Diffusion Transformers
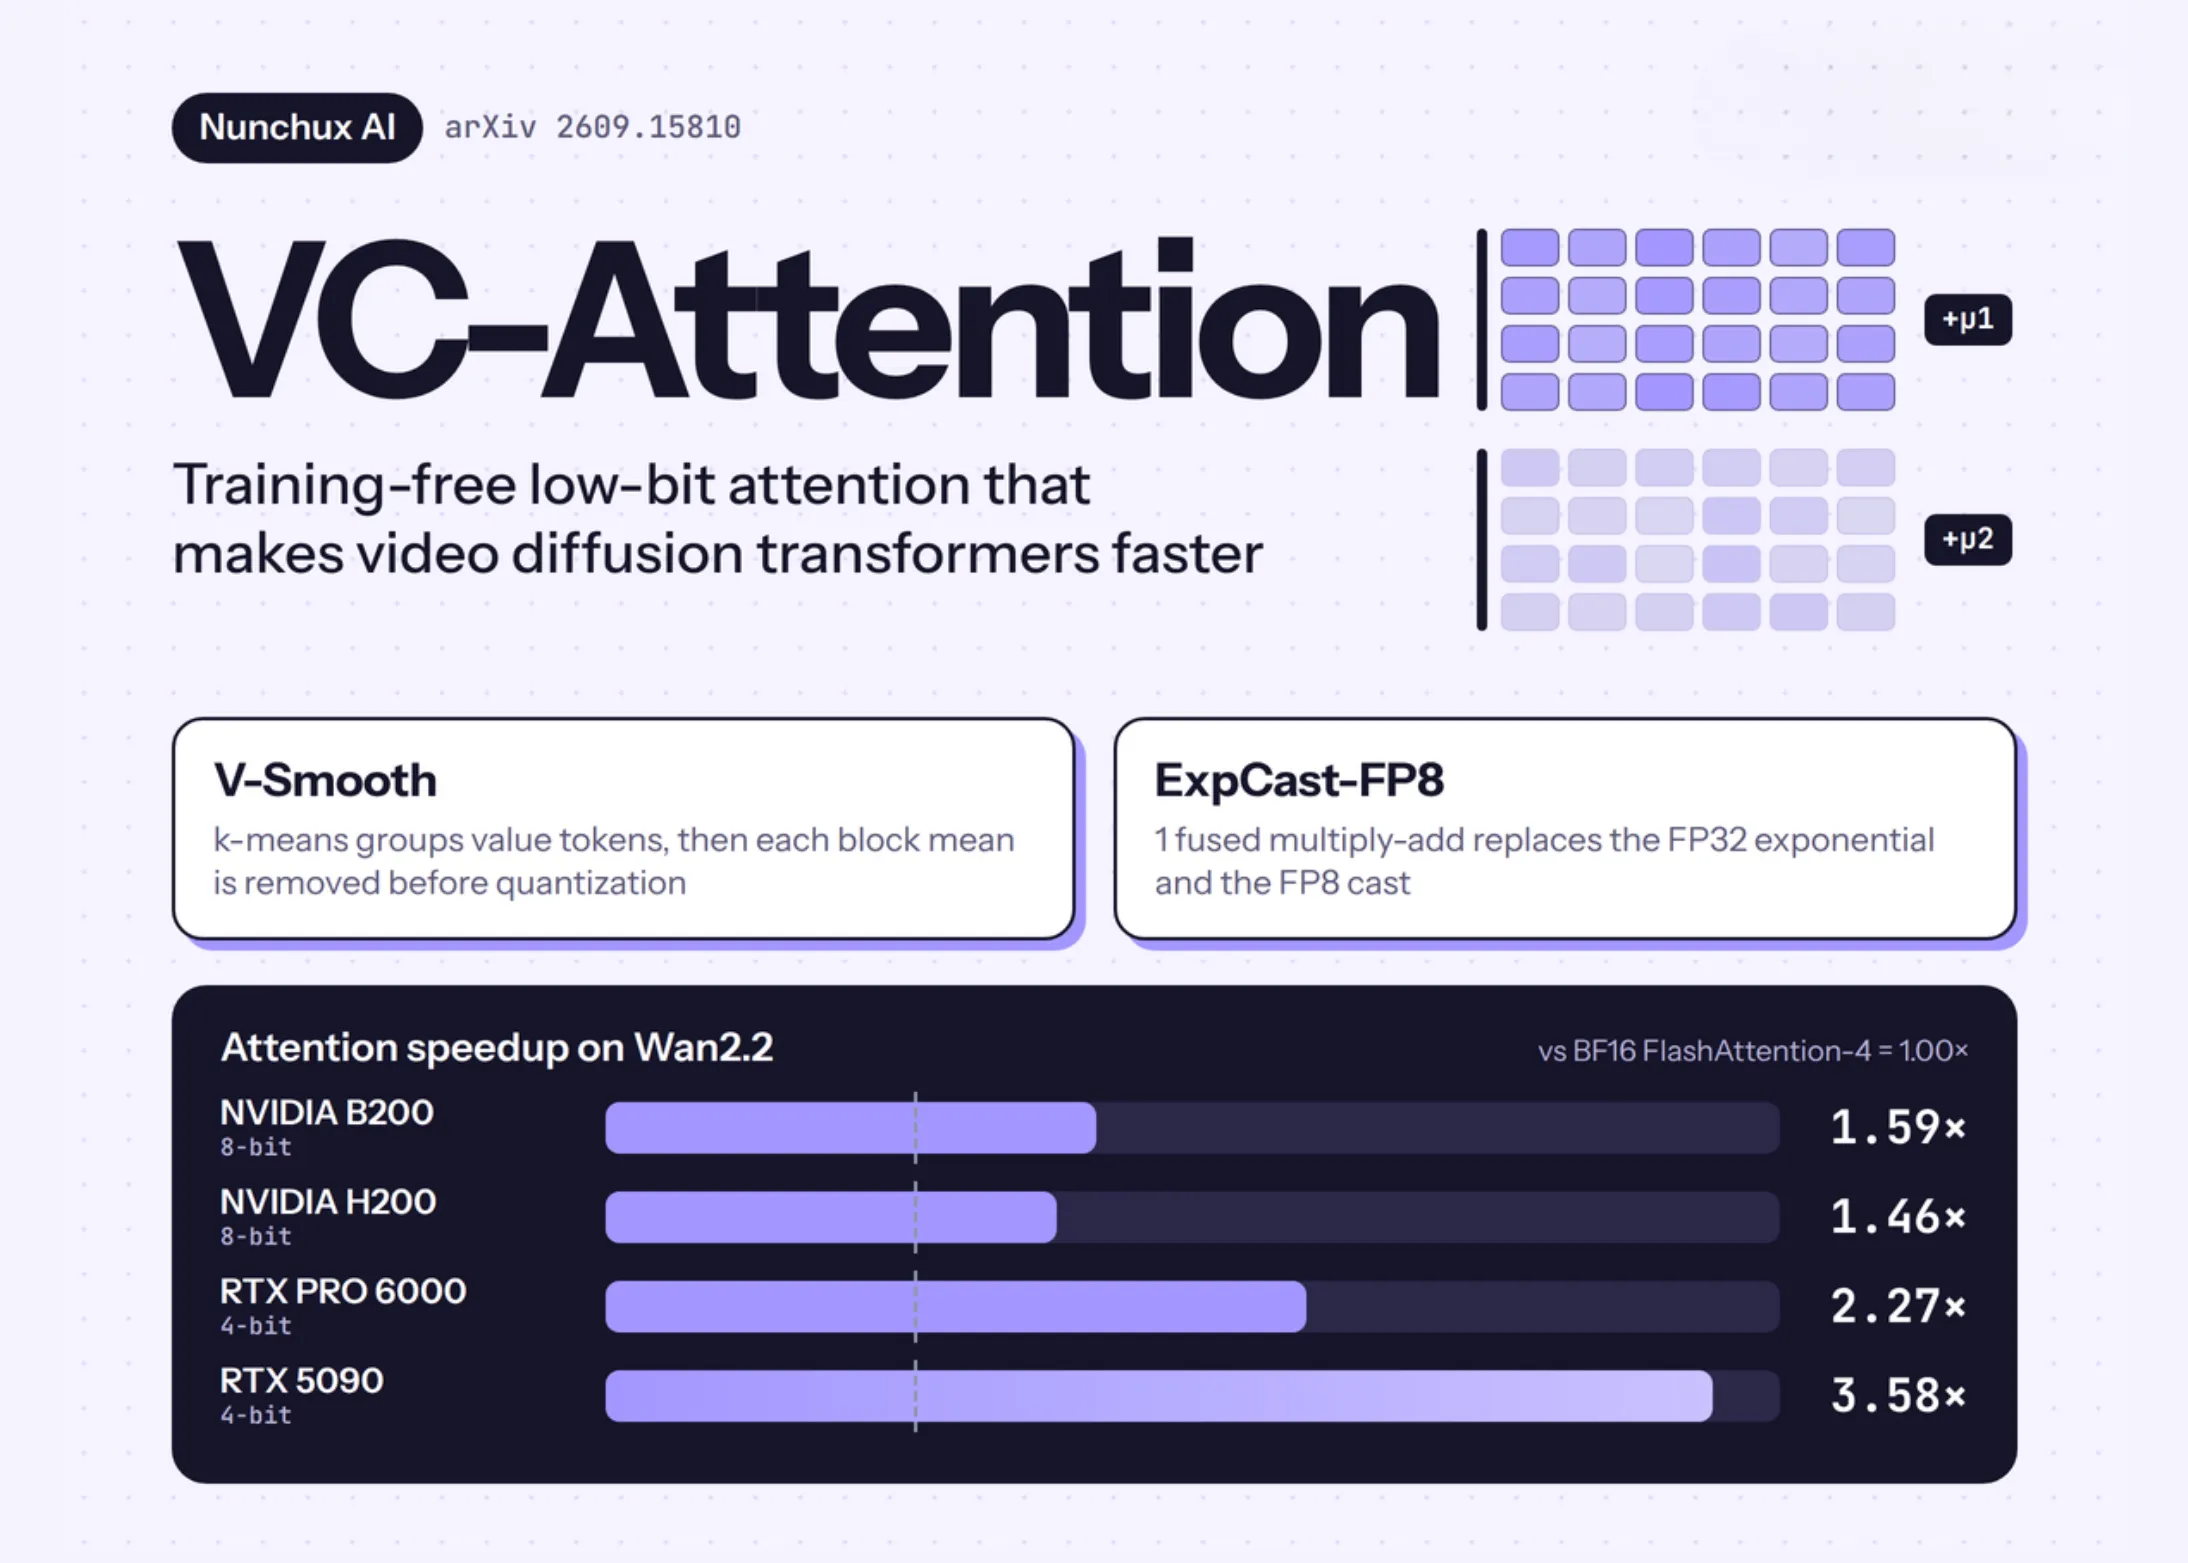
Nunchux AIが動画を作るAIの処理を最大64%以上速くする新技術「VC-Attention」を発表。これにより動画生成が効率的になります。
Nunchux AIは、video Diffusion Transformers (DiTs) 向けに構築された、学習不要の低ビット attention kernel である VC-Attention をリリースしました。これは、値の量子化誤差と遅い softmax ステージという2つの問題を同時に解決します。 ஏன்Attentionがなぜ動画のボトルネックなのか Video DiTsは、クリップを1つの時空間トークンシーケンスに平坦化し、すべての層で完全なself-attentionを実行します。5秒間の720p Wan2.2-14Bクリップは約7万トークンに及びます。RTX 5090では、attentionが生成時間の64%以上を占めます。研究チームは、単一のB200上でMiniMax-H3の各ノイズ除去ステップの約3分の2がattentionであると述べています。 低ビットのTensor Coresは、2つの行列積であるQKとPVを高速化します。しかし、2つの障害が残っています。第一に、SageAttention2のような以前の方法はクエリとキーを平滑化します。QKの平滑化と回転の後、Wan2.2では出力誤差の82%を値の項が占めます。第二に、積の間のsoftmaxは依然としてFP32で実行されます。B200とH200では、その指数関数とFP8へのキャストがパイプラインで最も長いステージとなります。 V-Smooth: 値の外れ値を修正する 値の外れ値は少数のトークンに存在し、そのチャネルはヘッド、レイヤー、ステップ間で変化します。Hadamard rotationはトークンノルムを保持するため、それらを除去しません。Vを回転させても値の誤差はわずか0.2%しか変化しません。V-Smoothは異なるアプローチを取ります。 Group: オンラインの k-means がバッチごと、ヘッドごとに値トークンをクラスタリングします。キーと値は一緒に並べ替えられるため、非因果的な attention 出力は変更されません。 Demean: 各128トークンのハードウェアブロックは、その平均値を減算します。残差のみが量子化され、8ビットのper-channel E4M3または4ビットのNVFP4を使用します。 Restore: 行和オンライン softmax が既に保持しているものを使用して、平均値が元に戻されます。2回目のパスや追加のバッファは必要ありません。 100個のWan2.2ヘッドで平均すると、ブロック平均はシーケンス順でブロックエネルギーの8%を除去します。DeltaQuantの静的キューブ下では12%、ソート後では36%を除去します。各平均は値要素あたり0.125ビットのコストです。グループ化はノイズ除去ステップの最初の25%のみで実行されます。この並べ替えは4つの隣接するステップで再利用されます。Aver
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。