アンソロピック、新AI発表 性能向上
Anthropic Releases Claude Fable 5.1 and Claude Mythos 5.1: 52.6% on Terminal-Bench-Science and 75% Cheaper Cache Reads
アンソロピックが新AI「Claude Fable 5.1」などを発表。科学問題解決能力が大幅向上し、記憶参照費用が75%削減され、賢いAIを安価に利用可能に。
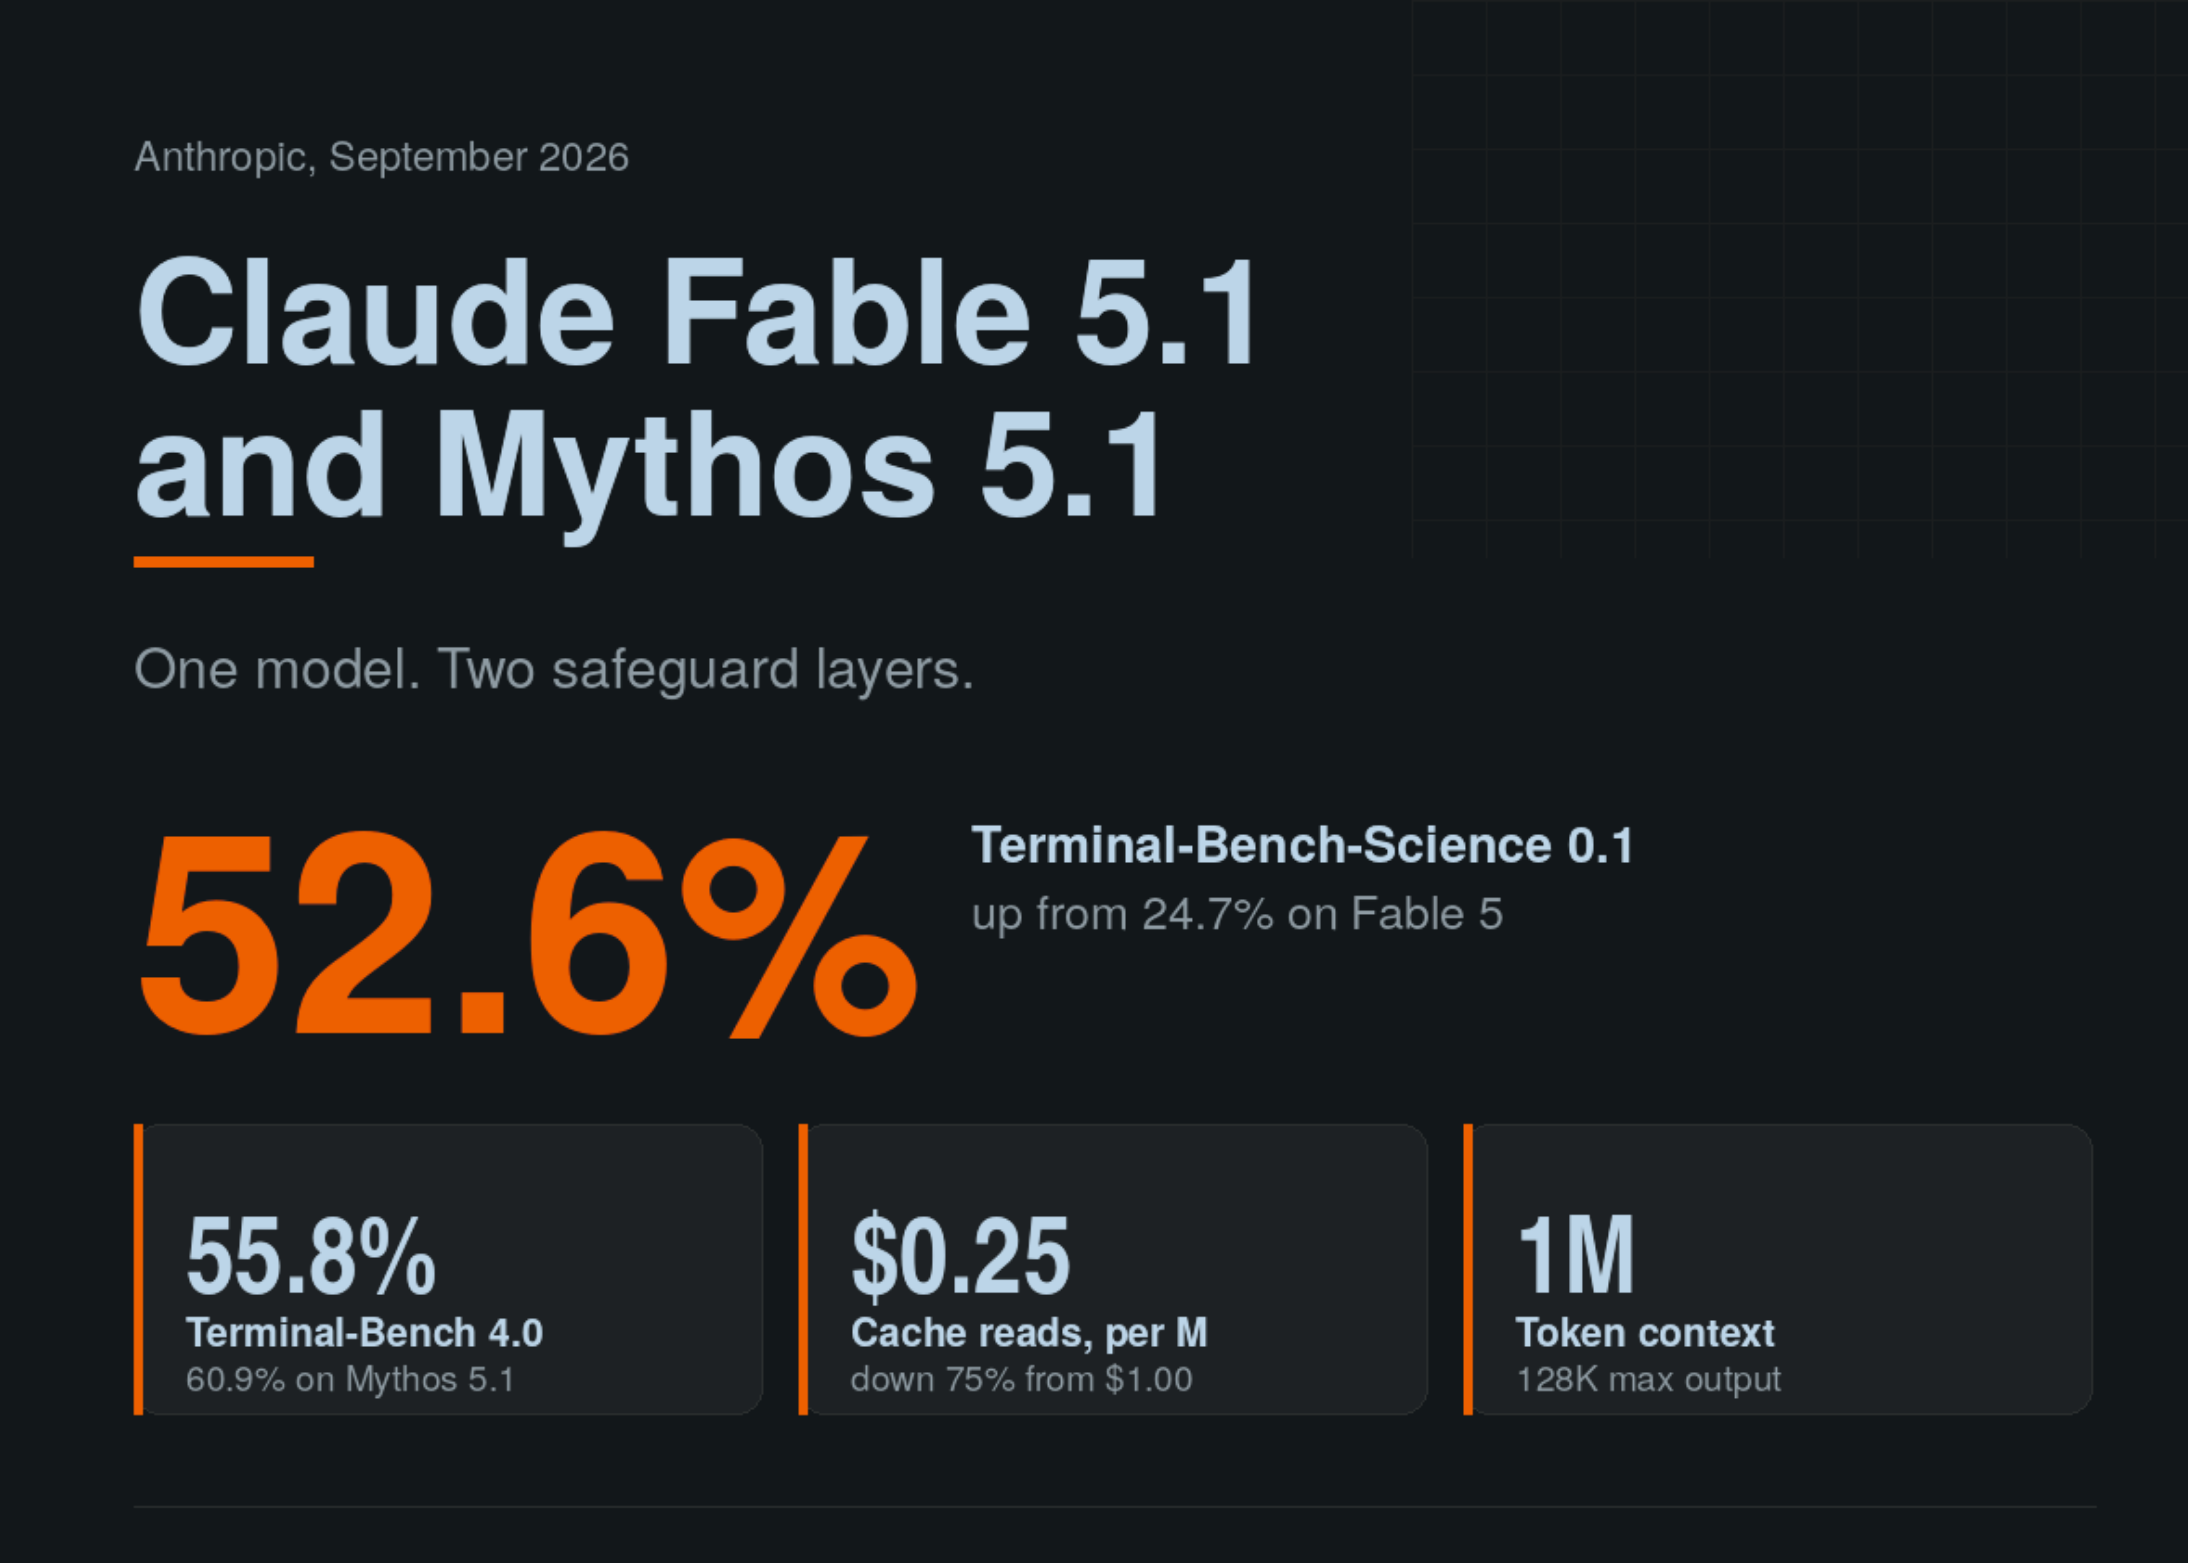
Anthropicは、2026年6月にFable 5シリーズが出荷されてから3ヶ月後、Claude Fable 5.1とClaude Mythos 5.1をリリースしました。<br>この2つのモデルは、異なるセーフガードレイヤーの背後にある同じ基盤モデルです。Fable 5.1はclaude-fable-5-1として一般提供されていますが、Mythos 5.1は厳選された組織に限定されています。<br>両モデルとも、1Mトークンのコンテキストウィンドウと128Kの最大出力トークンを持ち、適応的思考が常にオンになっています。<br>主要な能力数値はTerminal-Bench-Science 0.1で52.6%であり、Fable 5の24.7%、Opus 5の29.0%と比較して大幅に向上しています。<br>主要な商業数値は、キャッシュリード(cache reads)が75%削減され、100万トークンあたり1.00ドルから0.25ドルになりました。Anthropicは、これにより通常のワークロードで約25%、エージェント的なワークロードでは最大45%のコスト削減になると見積もっています。<br>基本となる入力および出力の料金は、100万トークンあたり10ドルと50ドルで変更ありません。<br>展開可能か?はい、Claude Fable 5.1はClaude API、Amazon Bedrock、AWS上のClaude Platform、Google Cloud、およびMicrosoft Foundryでclaude-fable-5-1として一般提供されています。<br>Claude Mythos 5.1はそうではありません。Project Glasswing内の厳選された米国の組織に限定されています。<br>ベンチマークの数値:エージェント的な科学研究ベンチマークであるTerminal-Bench-Science 0.1では、Fable 5.1が52.6%を記録し、Opus 5の29.0%、Fable 5の24.7%、GPT-5.6 Solの22.4%を上回りました。<br>Anthropicは、モデルあたりの標準誤差が3.5から4.5ポイントであると報告しているため、順位ではなく誤差範囲に注意して扱ってください。<br>Terminal-Bench 4.0では、Fable 5.1が55.8%、Mythos 5.1が60.9%に達しました。<br>2つの同一モデル間のギャップは、セーフガード介入のコストであり、これは異例なほど正直な開示です。<br>その他のベンチマーク:CursorBench 3.2.0で73.4%、Humanity’s Last Examでツールなしで60.9%、ツールありで65.0%、AutomationBenchで31.4%、OSWorld 2.0で厳密な評価で41.7%、GDPval-AA v2で1853を記録しました。<br>コスト削減の由来:基本となる入力および出力の料金は変更ありません。<br>キャッシュリードは75%削減され、100万トークンあたり1.00ドルから0.25ドルになりました。これは、他のすべてのClaudeモデルの0.1に対して、基本入力の0.025倍に相当します。<br>Anthropicは、およそ2
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。