AIモデル提供サービス開始
Prime Intellect Launches Prime Inference: Serverless and Reserved Serving for Frontier Open Models
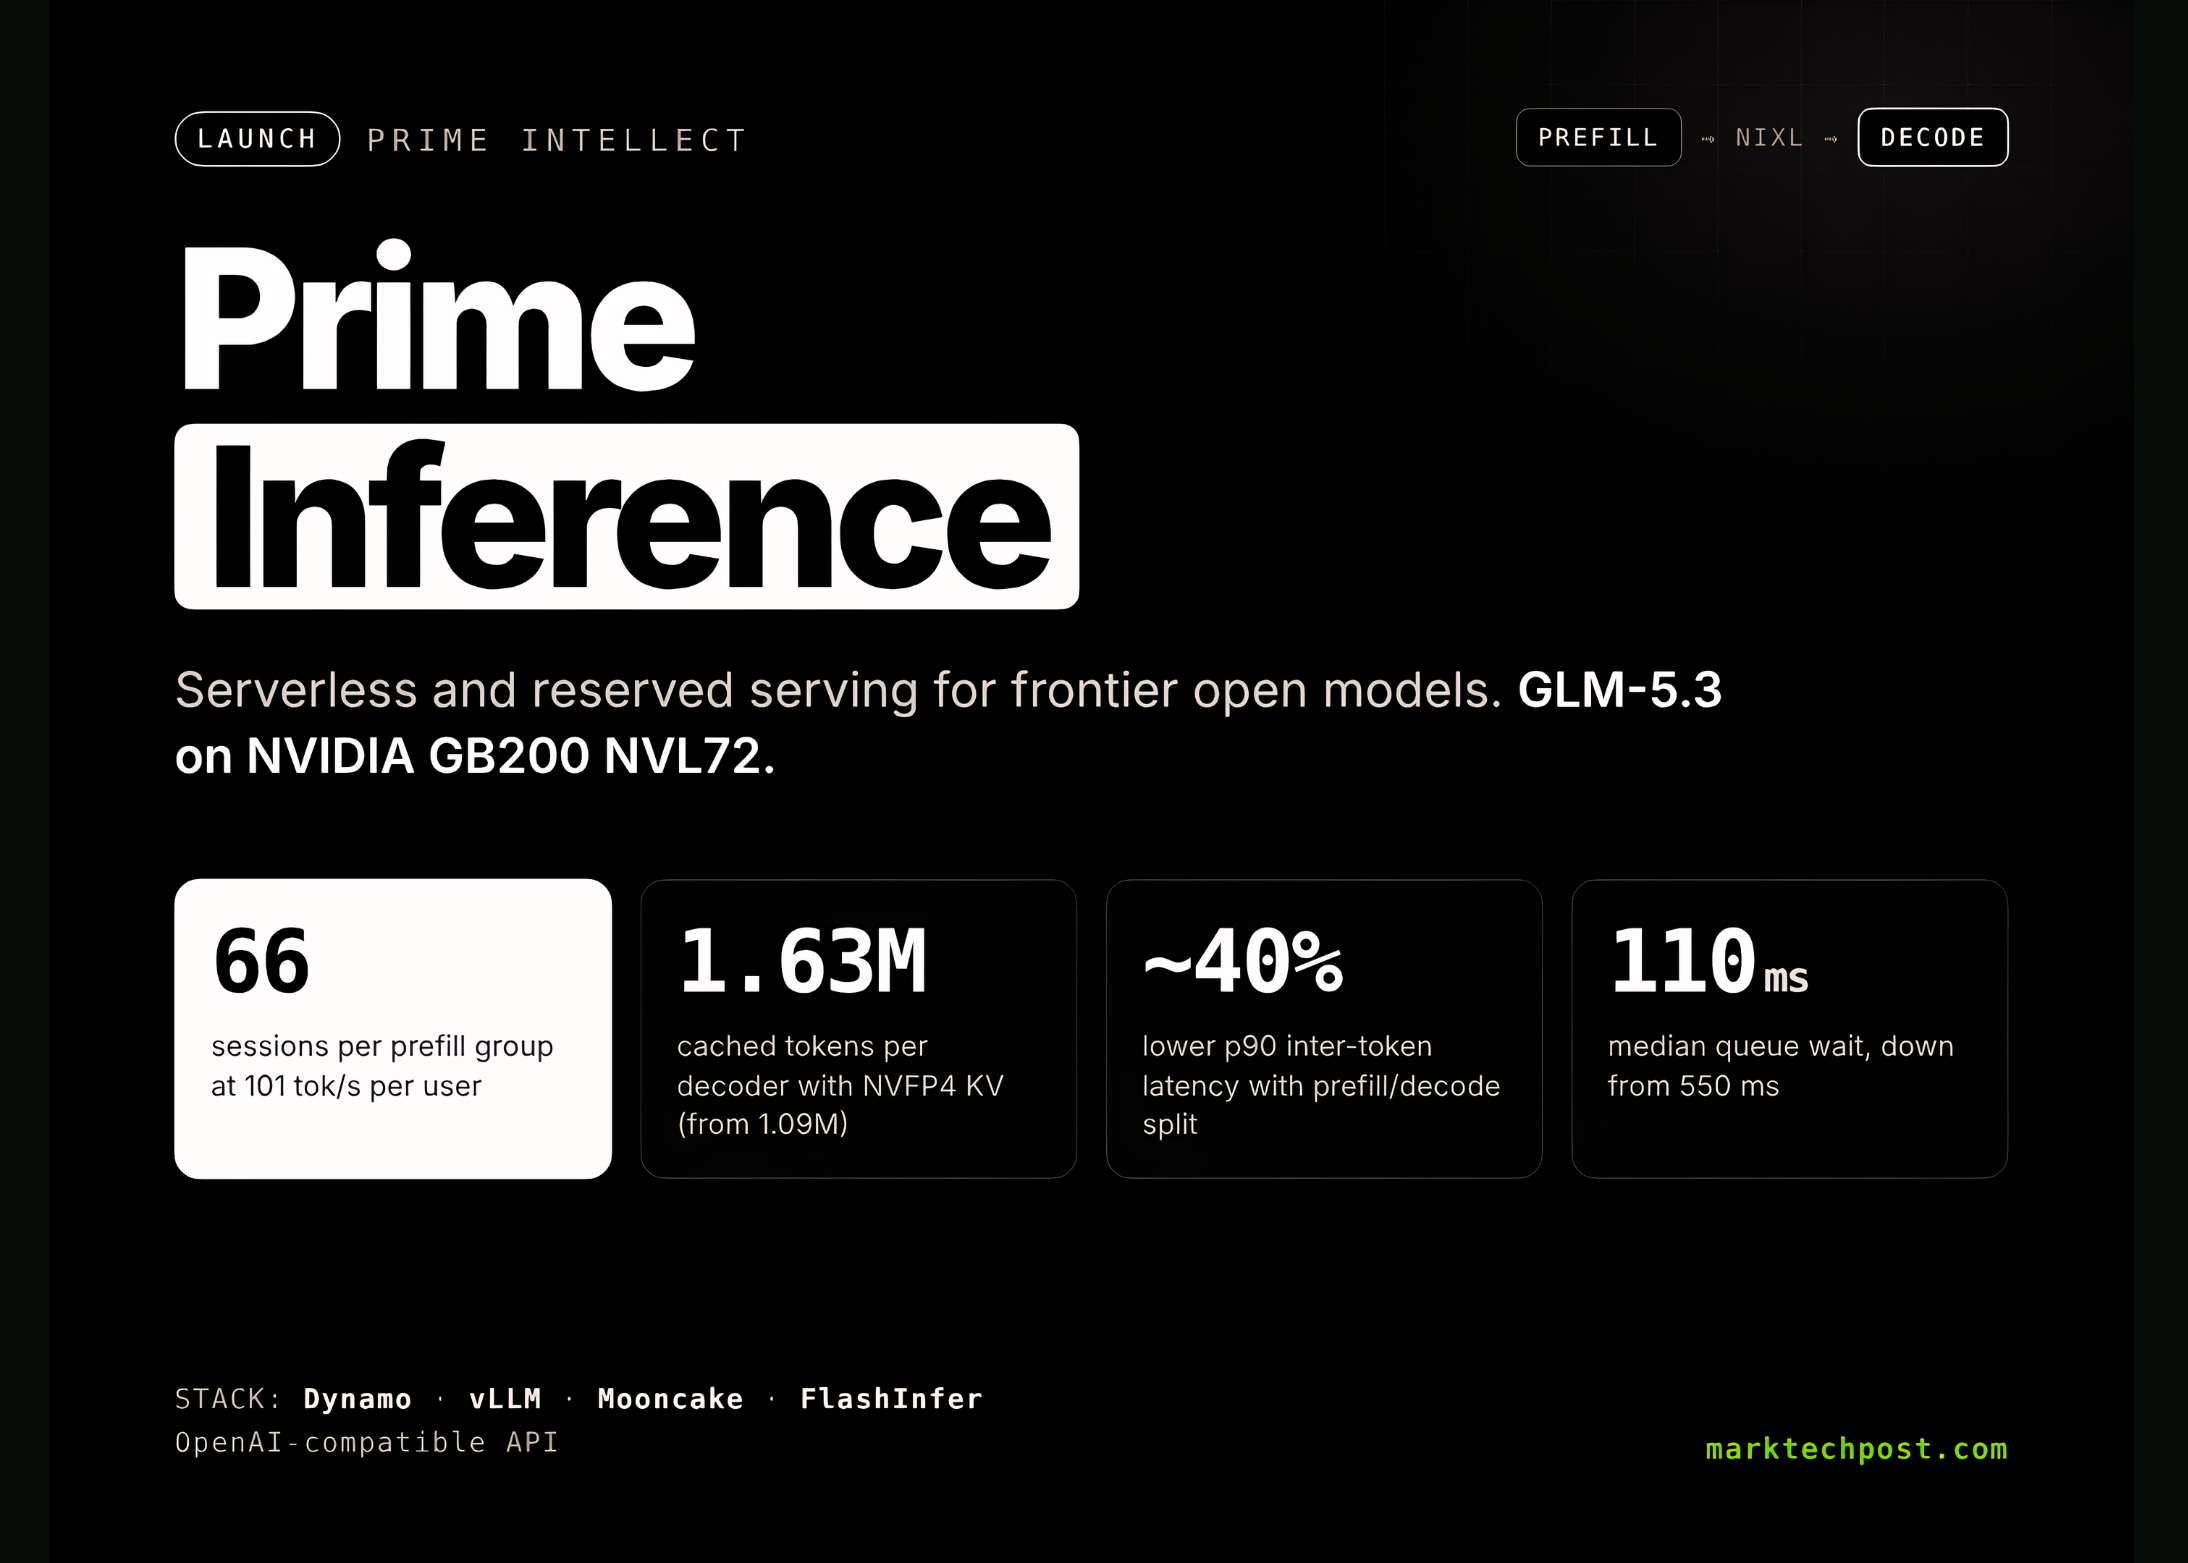
Prime Intellectが、オープンなAIモデルを動かすための新しいサービス「Prime Inference」を開始し、AI開発者がモデルをより速く、安定して利用できるようになります。
Prime Intellectは、最先端のオープンソースモデル向けの提供プラットフォームであるPrime Inferenceを立ち上げました。これは、複数のデータセンターにわたるPrime独自のGPU上で、サーバーレスエンドポイントと予約済み容量を提供します。公開前には、内部で1日あたり約1兆トークンを処理していました。このトラフィックは、RLロールアウト、合成データ生成、評価、および長時間実行されるコーディングエージェントからのものでした。Prime Inferenceとは何か?Prime Inferenceは、Prime Intellectのオープンなトレーニングスタックの提供レイヤーです。同社はすでにprime-rl、verifier、sandboxなどの後処理ツールを出荷しています。提供(Serving)はそのループを閉じます。デプロイされたモデルは、トレーニングにフィードバックできる本番トレースを生成します。Primeは、そのGLM-5.3エンドポイントがOpenRouterで最速の1つにランク付けされていると報告しています。また、ツール呼び出しエラー率がほぼゼロであり、ローンチ以来100%の稼働時間を達成していると述べています。2つのモード:変動する需要に対応するサーバーレスエンドポイントと、継続的なワークロードに対応する予約済み容量。OpenAI互換:任意のOpenAI SDKをhttps://api.pinference.ai/api/v1(docs)にポイントするだけです。稼働時間:データセンター間での自動フェイルオーバーにより、健全なデプロイメントにトラフィックがルーティングされます。ハードウェア:現在はNVIDIA Blackwell、Vera Rubinは近日登場予定とされています。請求:チームレベルの使用状況追跡を含む統合された請求。モデルごとの価格はまだドキュメントに完全に公開されていません。提供スタックの仕組みスタックはNVIDIA Dynamo、vLLM、Mooncake、FlashInferを組み合わせています。これはInferactとNVIDIAと共同で構築され、修正はアップストリームに貢献されています。ターゲットワークロードはエージェント型です。一般的なエージェントのターンでは、140Kトークンのプロンプトに約6Kトークンが追加されます。Primeはこの組み合わせをSemiAnalysis AgentXでベンチマークし、コールドアライバルを注入しました。プリフィル/デコードの分離:プリフィルとデコードは別々のGPUグループで実行されます。Dynamoがルーティングを処理し、vLLMが各グループでモデルを実行します。デコーダーはNIXLを介して計算されたKVをプルします。Primeは、テストでp90トークン間レイテンシが約40%低いと報告しています。キャッシュ対応ルーティング:DynamoのKV対応ルーターは、キャッシュされたプレフィックスの重複とキューに入れられたものを比較検討します。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。