AIモデルが小型化し高性能を維持
PrismML Releases Ternary Bonsai 2 27B: A 5.9 GB Apache 2.0 Model Retaining 98.2% of Qwen3.8 27B Performance
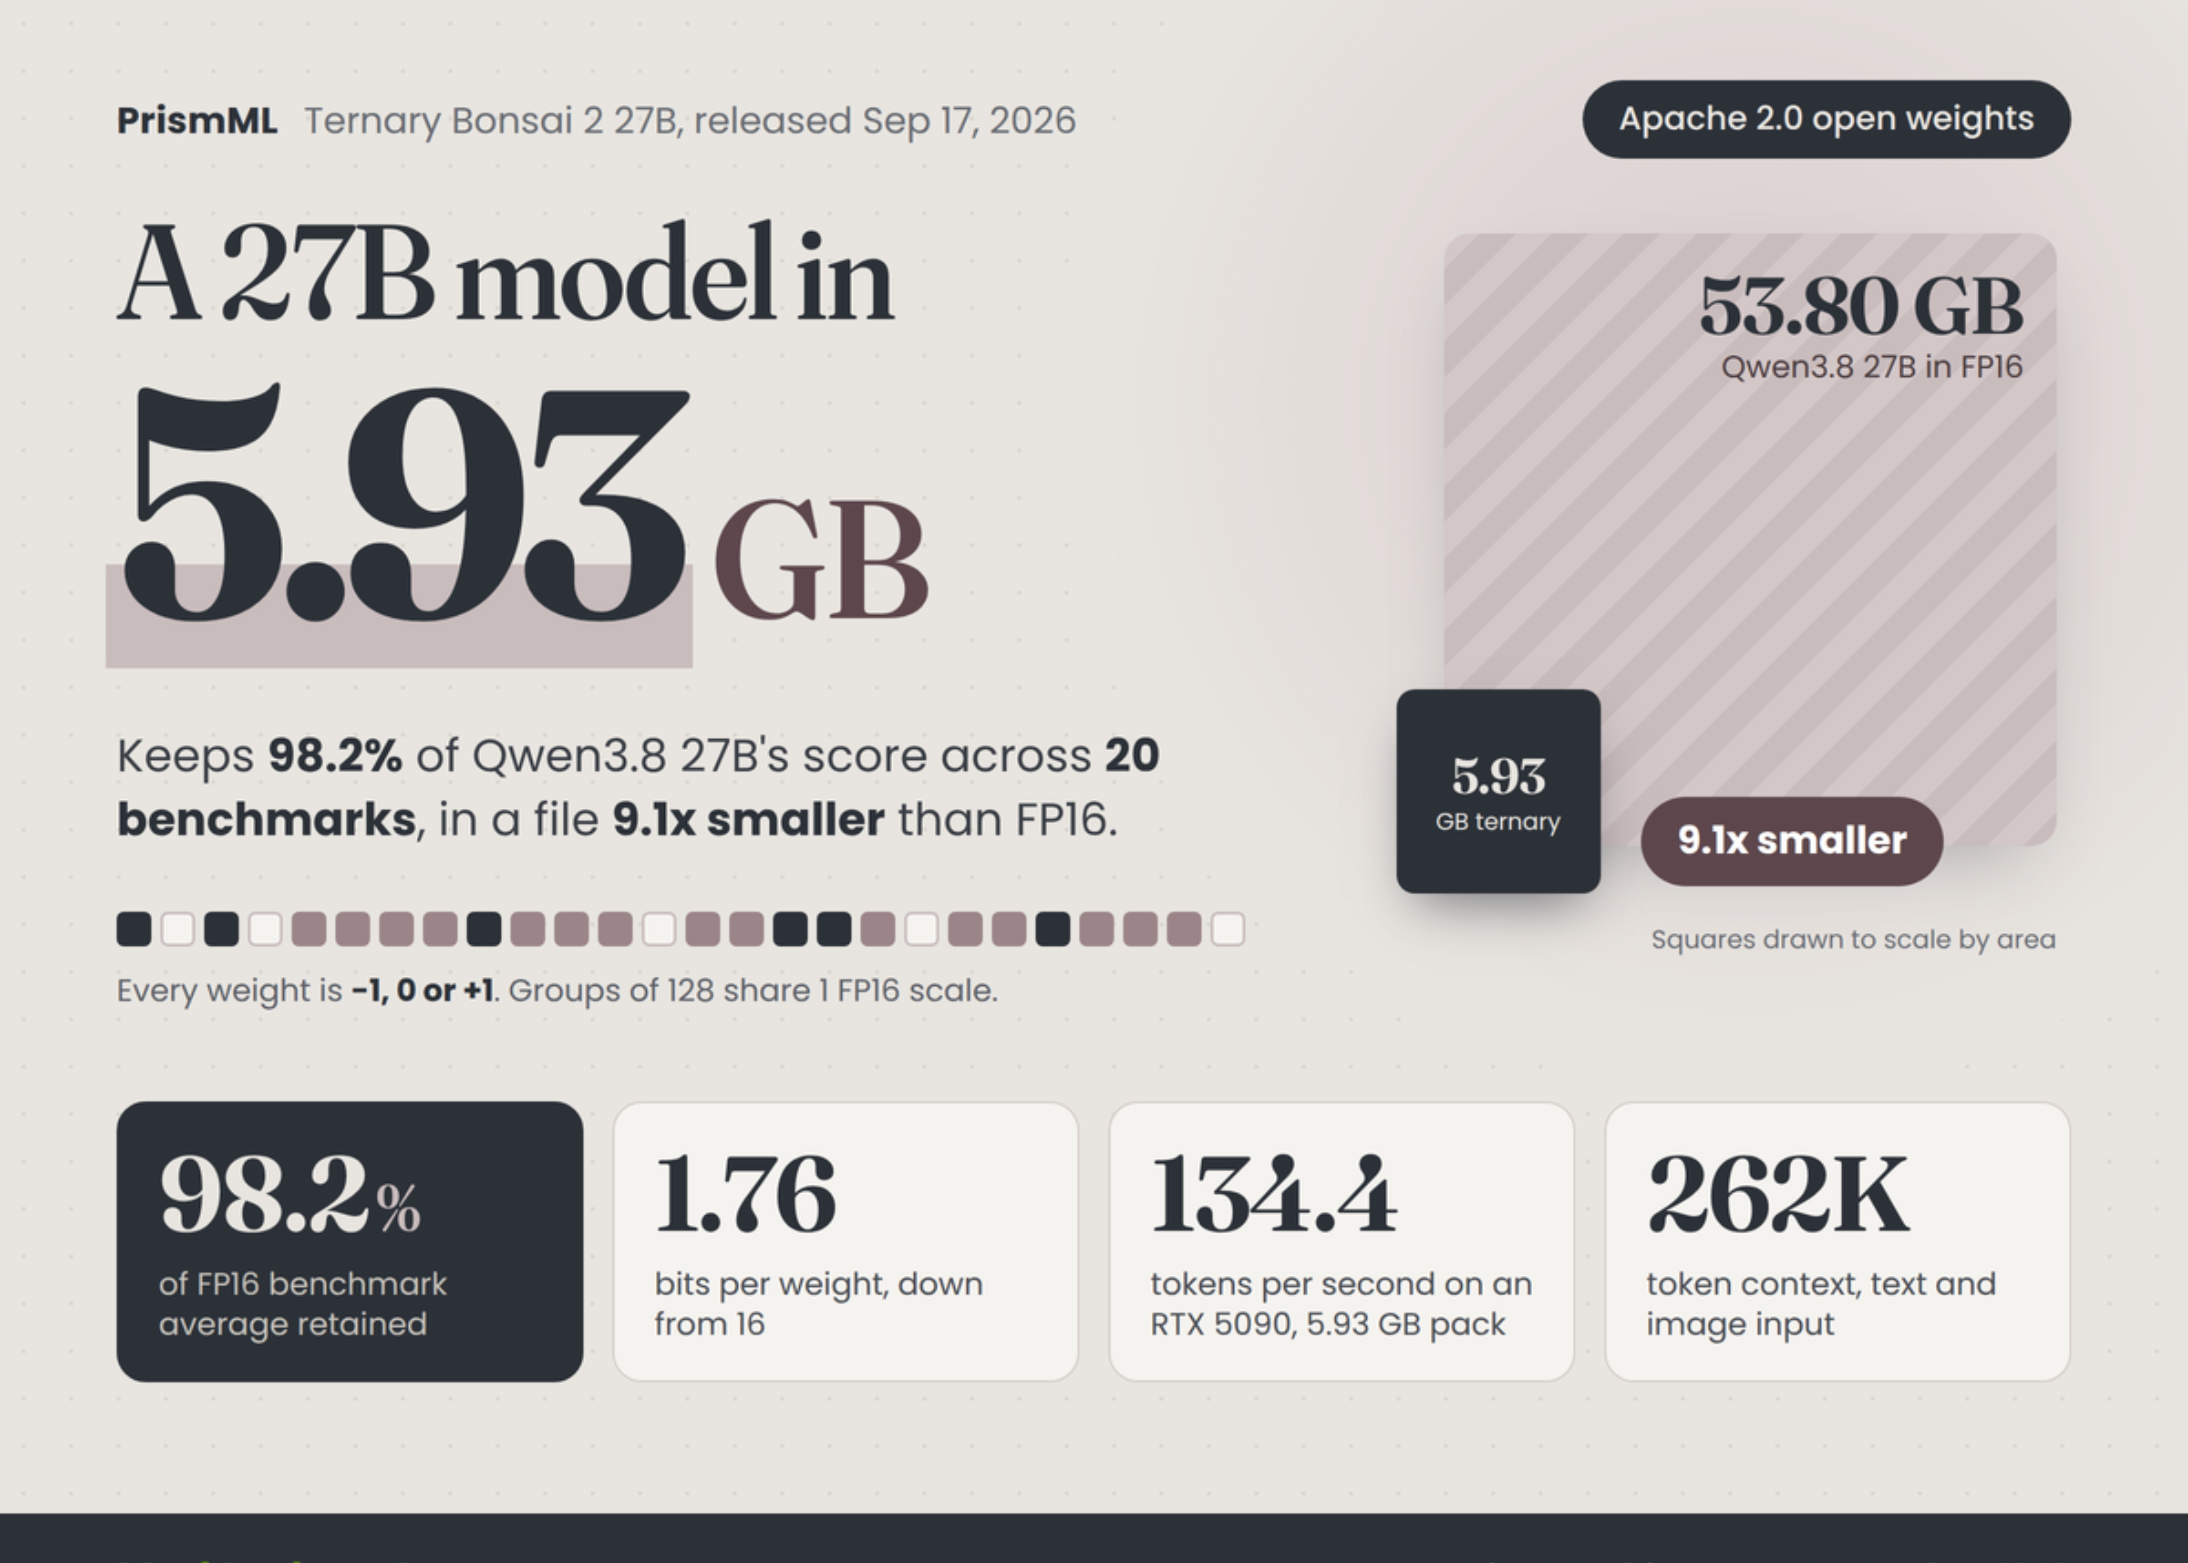
PrismMLが、元のAIモデルの98.2%の性能を保ち、サイズを約10分の1の5.9GBに減らした「Ternary Bonsai 2 27B」を公開。少ない計算資源で高性能AIが使えるため重要です。
PrismMLは、Qwen3.8 27Bの三値重み版であるTernary Bonsai 2 27Bをリリースしました。この言語モデルは5.93 GBを占め、FP16版の53.80 GBと比較して大幅に小さいです。PrismMLは、20のベンチマークにおいて親モデルの平均性能の98.2%を維持していると報告しています。このモデルはテキストと画像を認識し、262Kトークンのコンテキストをサポートします。PrismMLは、RTX 5090上でClineコーディングエージェントやコンピューター利用を駆動するデモを行っています。これは、三値化バージョンが約95%の性能を維持した最初のBonsai 27Bから2ヶ月後に登場しました。展開可能か?はい。Apache 2.0ライセンスの重みは、今日、16 GBのノートパソコンや単一の24 GB GPUで動作します。PrismMLのllama.cppフォーク、またはそのMLXランタイムが必要です。Ternary Bonsai 2 27Bとは?このモデルはQwen3.8 27Bのアーキテクチャをそのまま維持しています。27.36Bのパラメータを持っています。これは、24.35Bの言語バックボーン、embeddingsとLM headに2.54B、そして0.47Bのvision towerに分かれます。バックボーンはハイブリッドアテンションを使用しており、約75%がlinear-attention層、25%がfull-attention層です。三値重みは、embeddings、attention projections、MLP projections、およびLM headをカバーしています。26.2Mパラメータ、つまり0.0976%のみが高精度を維持しています。これらは、recurrent state pathとnormalization weightsです。GGUFでは、vision towerは0.63 GBのファイルとして個別に提供され、画像入力の場合にのみロードされます。三値形式はどのように機能するのか?各重みは-1、0、+1の3つの値のいずれかを取ります。128個の重みの各グループは、1つのFP16スケールを共有します。三値はlog2(3)、つまり約1.585ビットを運びます。128個の重みごとに16スケールビットを追加すると、重みあたり1.71ビットになります。高精度テンソルを数えると、モデルは1.72ビットになります。実際のカーネルにはパックされたレイアウトが必要なため、ホワイトペーパーでは2つのGGUFパッキングについて説明しています。PTQ1_0は、重みあたり1.76ビットで5.93 GBにtritsを密にパックします。PQ2_0は、各tritを2ビットスロットに7.25 GBで格納し、これはアンパックがより安価です。重みは回転基底にも格納されます。PrismMLは、三値割り当ての前にブロックサイズ1,024のブロックワイズHadamard回転を適用します。ランタイムは、各muの前にアクティベーションに一致する変換を適用します。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。