AIが長い作業で情報を忘れない工夫
Context Engineering Inside the Harness: 4 Mechanisms That Beat Context Overflow and Goal Loss on Long-Horizon Tasks
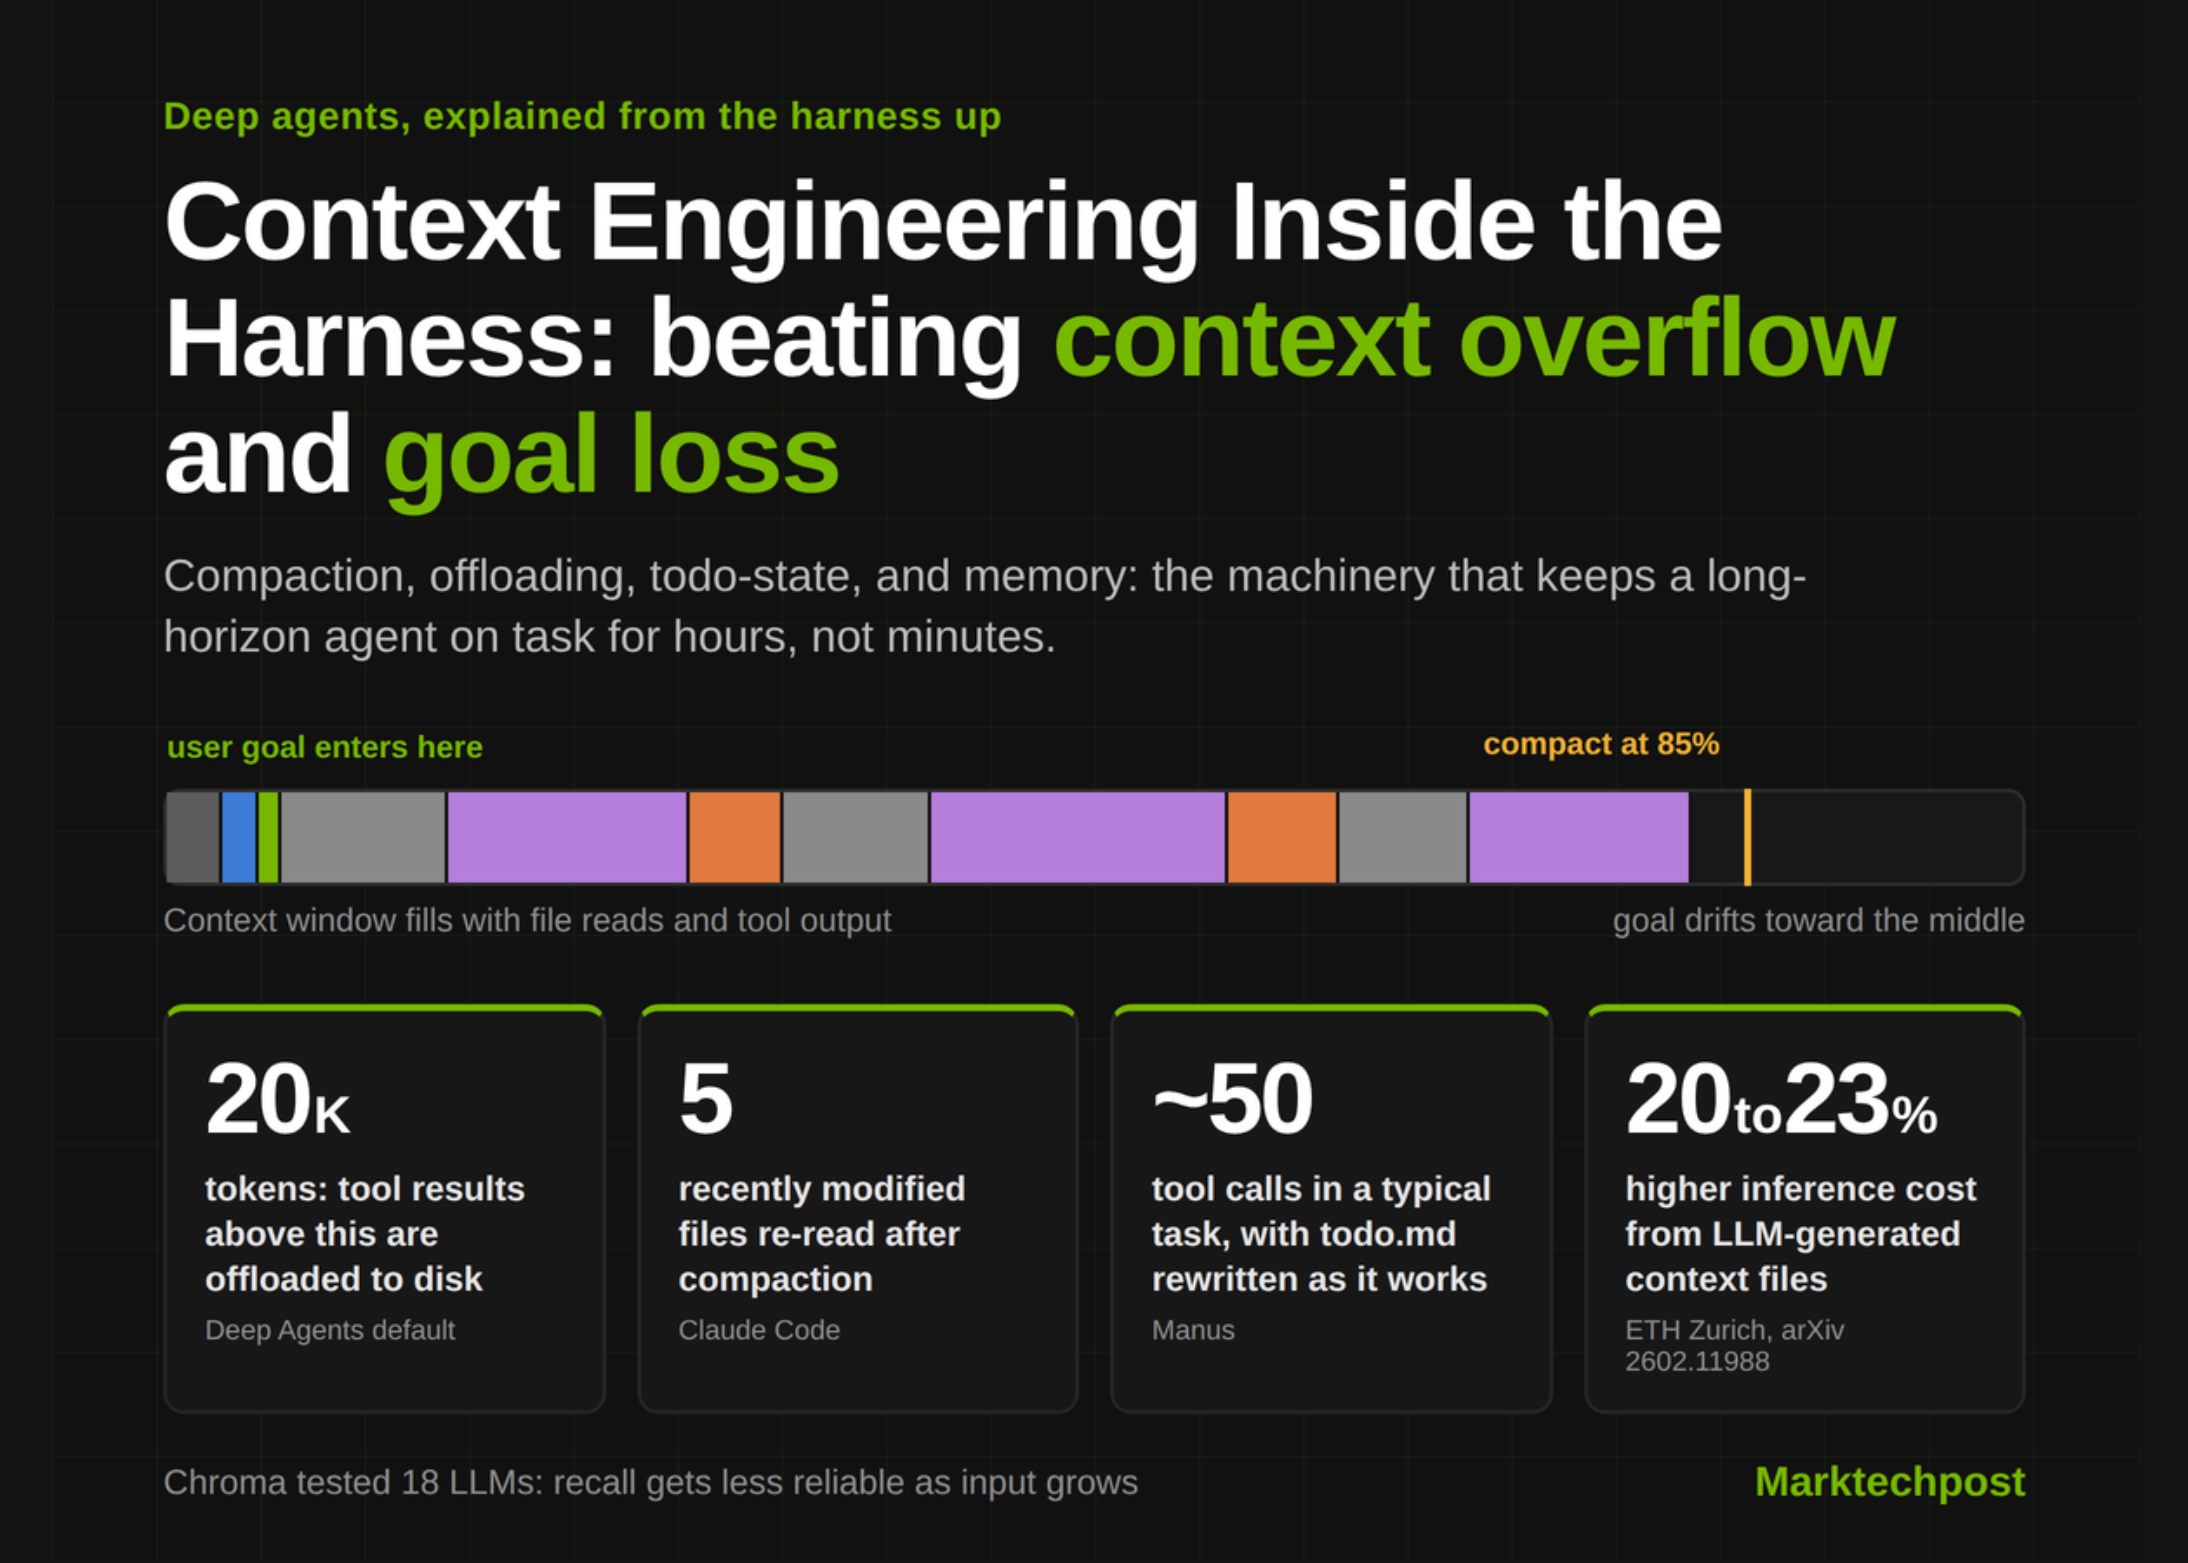
AIが長い作業で情報を忘れず、目的を見失わないようにする「ハーネス」という仕組みが重要です。大きな情報窓(コンテキストウィンドウ)だけでは不十分で、情報整理の工夫がAIの能力を大きく向上させます。
エージェントは、最も単純な形では、LLMがツールをループで呼び出すものです。このループは短い作業には機能します。しかし、1時間かかり、200回のツール呼び出しを要するタスクを与えると、2つの予測可能な方法で破綻します。AWS Samplesの自律型クラウドコーディングエージェント向け設計ガイドは、それらを直接的に挙げています。浅いエージェントは、context overflowに苦しみ、注意散漫になり(goal loss)、長期間にわたって状態を維持できません。これを解決する層はモデルではありません。それは「ハーネス」であり、AWSはモデル以外のすべてを管理するものと説明しています。この記事では、その層を掘り下げます。Compaction、memory strategy、context budgeting、そしてtodo-stateが、浅いループを深いエージェントに変える仕組みです。LangChain Deep Agents、Claude Code、Manus、OpenAI Codex、そしてAmazon Bedrock AgentCoreがそれぞれをどのように実装しているか、そして実際に提供している閾値とともに見ていきます。なぜ大きなウィンドウが解決策にならないのか
明白な解決策は、より大きなcontext windowです。しかし、証拠によれば、それは期待されるほど役立ちません。ChromaのContext Rotレポートは、GPT-4.1、Claude 4、Gemini 2.5、Qwen3を含む18のLLMを評価し、入力長が長くなるにつれて、単純な検索タスクでさえパフォーマンスがますます信頼できなくなることを発見しました。Anthropicのcontext engineeringガイドは、そのメカニズムを説明しています。attentionはn個のトークンに対してn²のペアワイズな関係を作成するため、追加されるすべてのトークンが有限の「attention budget」を使い果たします。コンテキストは、バケツではなく、収穫逓減の法則が働くリソースです。エージェントのループにとって、これは聞こえるよりも悪い状況です。Manusは、典型的なタスクには約50回のツール呼び出しが必要であり、入力と出力のトークン比が100:1に近いと報告しています。各観測結果はコンテキストに入り、そこに留まります。元の指示はウィンドウの中央に漂流し、まさにその場所で想起能力が低下します。Goal lossはモデルのバグだけではありません。それは、十分に長いタスクにおいて、管理されていないコンテキストの予想される結果なのです。
メカニズム1:Context budgetingとoffloading
ハーネスの最初の仕事は、何がウィンドウに全く入らないかを決定することです。D
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。