モデルtldr-ai2026-10-06
AIモデルd1が画像も理解
Announcing d1 with vision
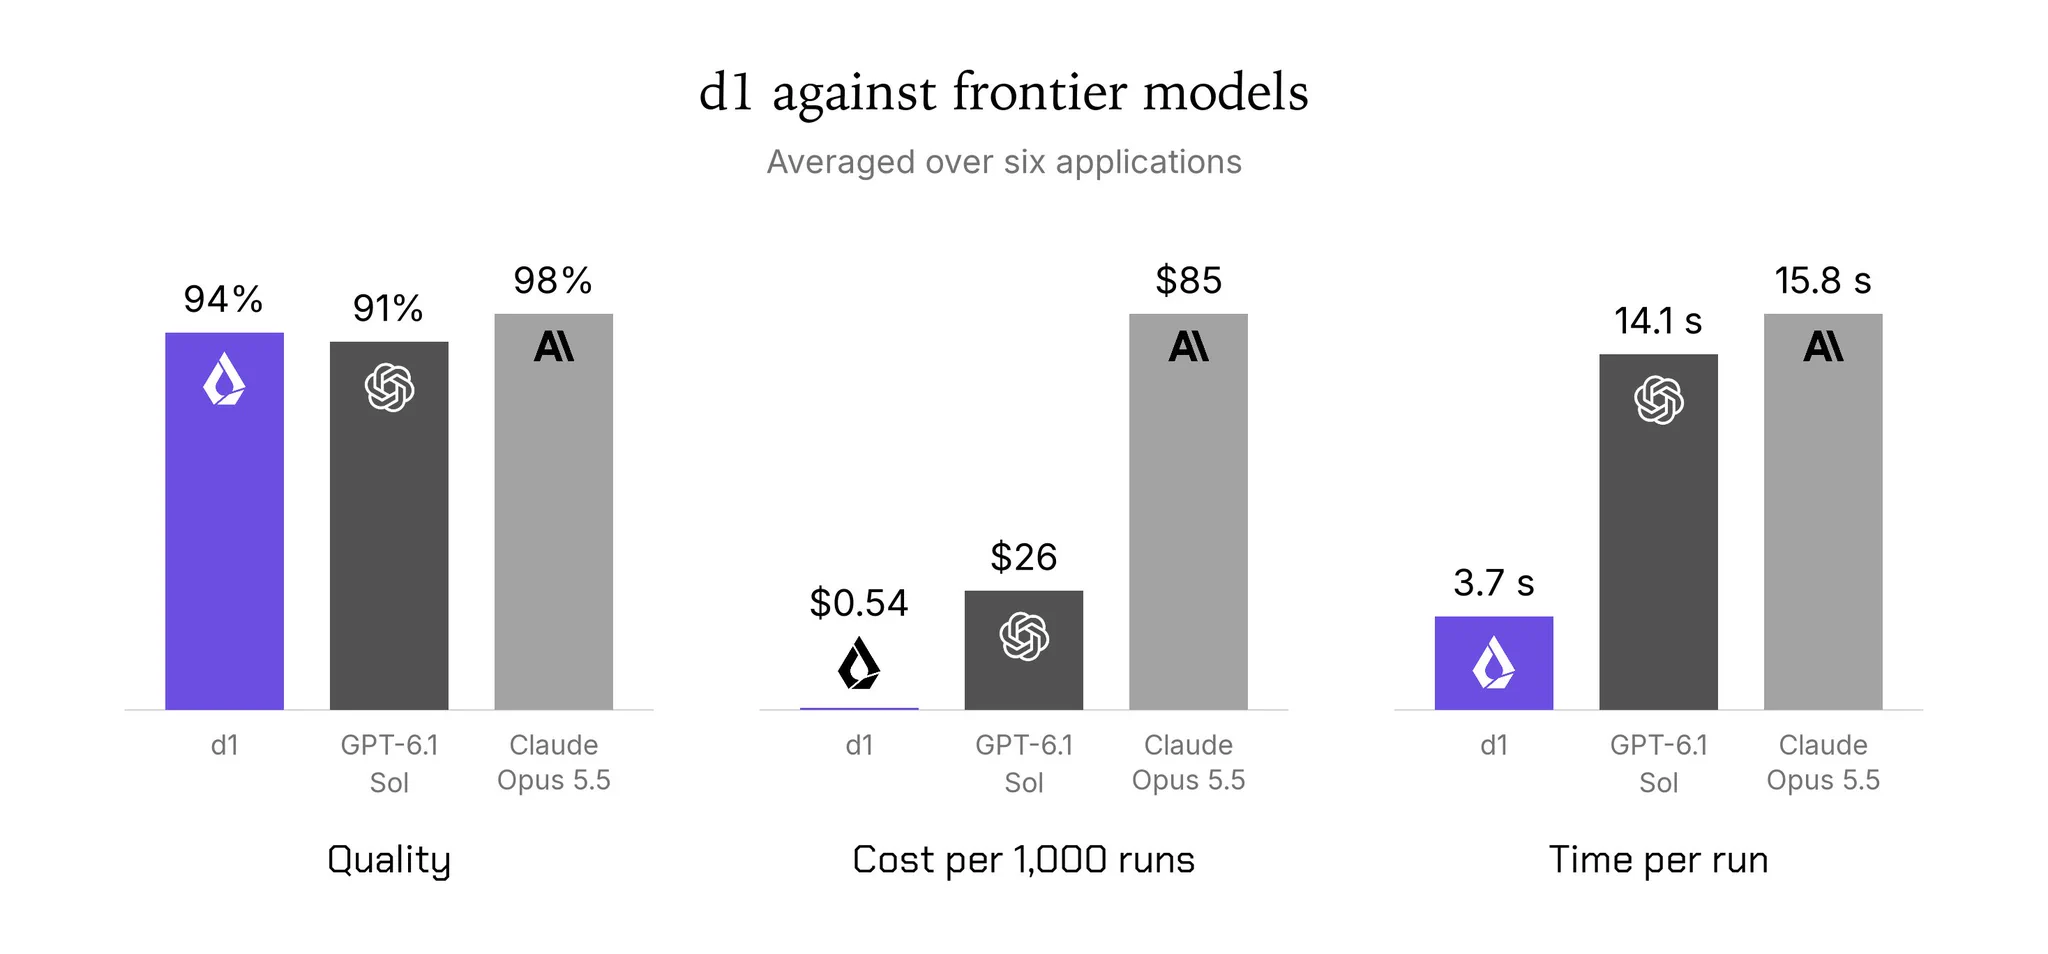
Liquid AIのd1モデルが画像とテキストに対応。競合AIより最大200倍安く、高速に判断できるため、素早い意思決定に貢献します。
Liquid AIの意思決定モデルであるd1は、入力として画像、テキスト、またはその両方をサポートするようになりました。このモデルは、GPT-6.1 SolやClaude Opus 5.5よりも19倍から200倍安価であり、あらゆるタスクで著しく高速に回答します。トークンを生成することなく、1回のforward passでyes/no、選択、またはスコアに関する質問に対する確率を出力します。テキストの意思決定は200から300ミリ秒で行われます。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。