アリババ、考えて話すAI公開
Alibaba Qwen Releases Qwen-Audio-3.1-Realtime: A Full-Duplex Voice Model Trained to Think, Act, and Decide When to Speak
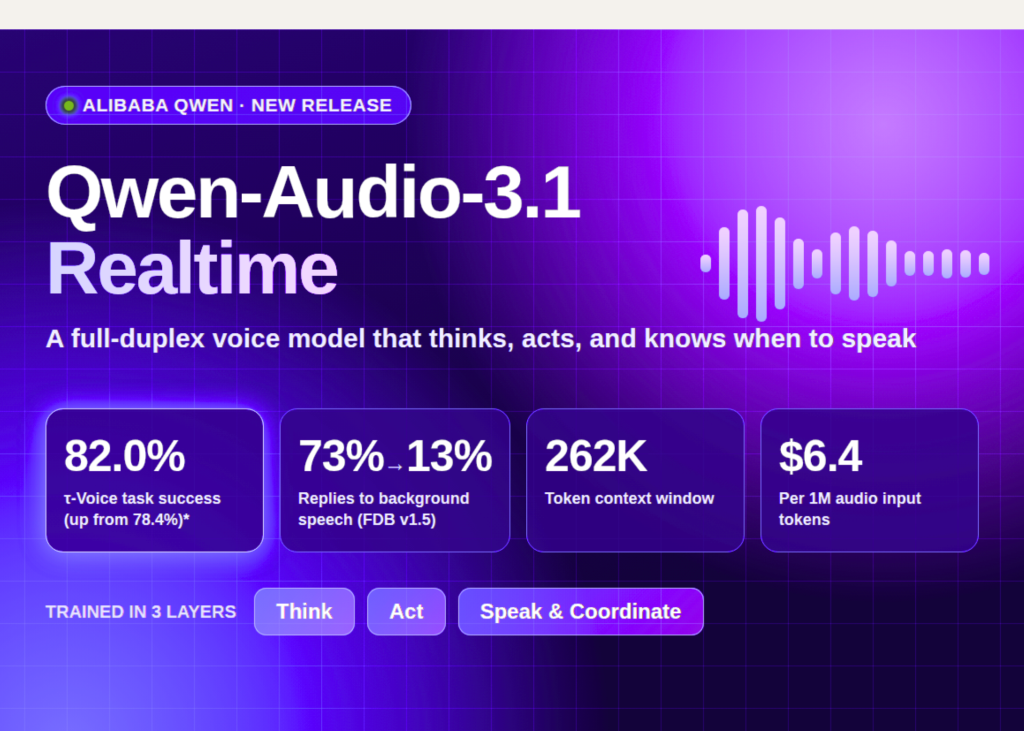
アリババが、まるで人間のように考えて話すタイミングを決めるAIを公開し、利用料を最大95%も値下げ。より自然な会話AIが手頃になります。
アリババのQwenチームは、ASR、TTS、リアルタイムインタラクションにわたる5つのモデルからなるオーディオスタックであるQwen-Audio-3.1をリリースしました。主要モデルはQwen-Audio-3.1-Realtimeで、ツールを呼び出す音声エージェント向けに構築された全二重音声モデルです。Qwenは価格も引き下げ、Realtimeで約85%、TTSで約70%、ASRで最大95%の値下げを行いました。 展開可能か?はい、マネージドAPIとして利用できます。qwen-audio-3.1-realtime-plusはWebSocket経由でQwenCloudにて稼働中です。オープンウェイトは発表されていません。 QwenCloudで提供されるもの モデルページには、テキストとオーディオの両方が入力および出力としてリストされています。コンテキストは262Kトークンで、最大入力は245K、最大出力は16Kです。デフォルトの制限は1分あたり60リクエスト、100Kトークンです。価格は、オーディオ入力100万トークンあたり6.4ドル、テキスト入力100万トークンあたり0.8ドルです。テキストおよびオーディオ出力は100万トークンあたり24ドルかかりますが、出力テキストは課金されません。主な機能には、function calling、web search、structured outputs、context cache、fine-tuningが含まれます。 コンパニオンモデルであるQwen-Audio-3.1-ASR-Flash-Filetransは、オフラインの長尺オーディオ転写を対象としています。ホットワード、話者分離、句読点、多言語および中国語方言の認識をサポートしています。費用は入力100万トークンあたり0.15ドル、出力100万トークンあたり0.47ドルです。 アーキテクチャ:1つの音声の背後にある2つのモデル このシステムは、同じAudio EncoderとLLM設計を持つ2つのモデルで動作します。全二重決定モデルは、聞き続けるか、話すか、停止するか、再開するかを予測します。音声テキスト変換モデルは、応答内容をテキストとして書き出します。その後、コンテキストを認識する音声レンダラーがそのテキストをストリーミング音声に変換します。これは、会話履歴、音声キュー、音響コンテキストに基づいて調整されます。 トレーニングは、「Think(考える)」「Act(行動する)」「Speak and Coordinate(話す・調整する)」の3つのレイヤーに編成されています。 Think:M²-OPD Core-Cocktail SFTは、数百万時間規模のペアデータを使用して、オーディオモデルをそのソーステキストLLMに再固定します。これに続いて、マルチモダリティOPDが行われます。Text Teacherと凍結されたAudio Referenceが、学生(モデル)自身の軌跡の各トークンを評価します。これは、事前に書かれた回答の模倣ではなく、オンポリシー蒸留です。共感のためのドメインエキスパート。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。