Linkupが軽量な言葉AIを公開
Linkup Research Releases SPARSEUP: A 149M-Parameter Open-Source Sparse Embedding Model
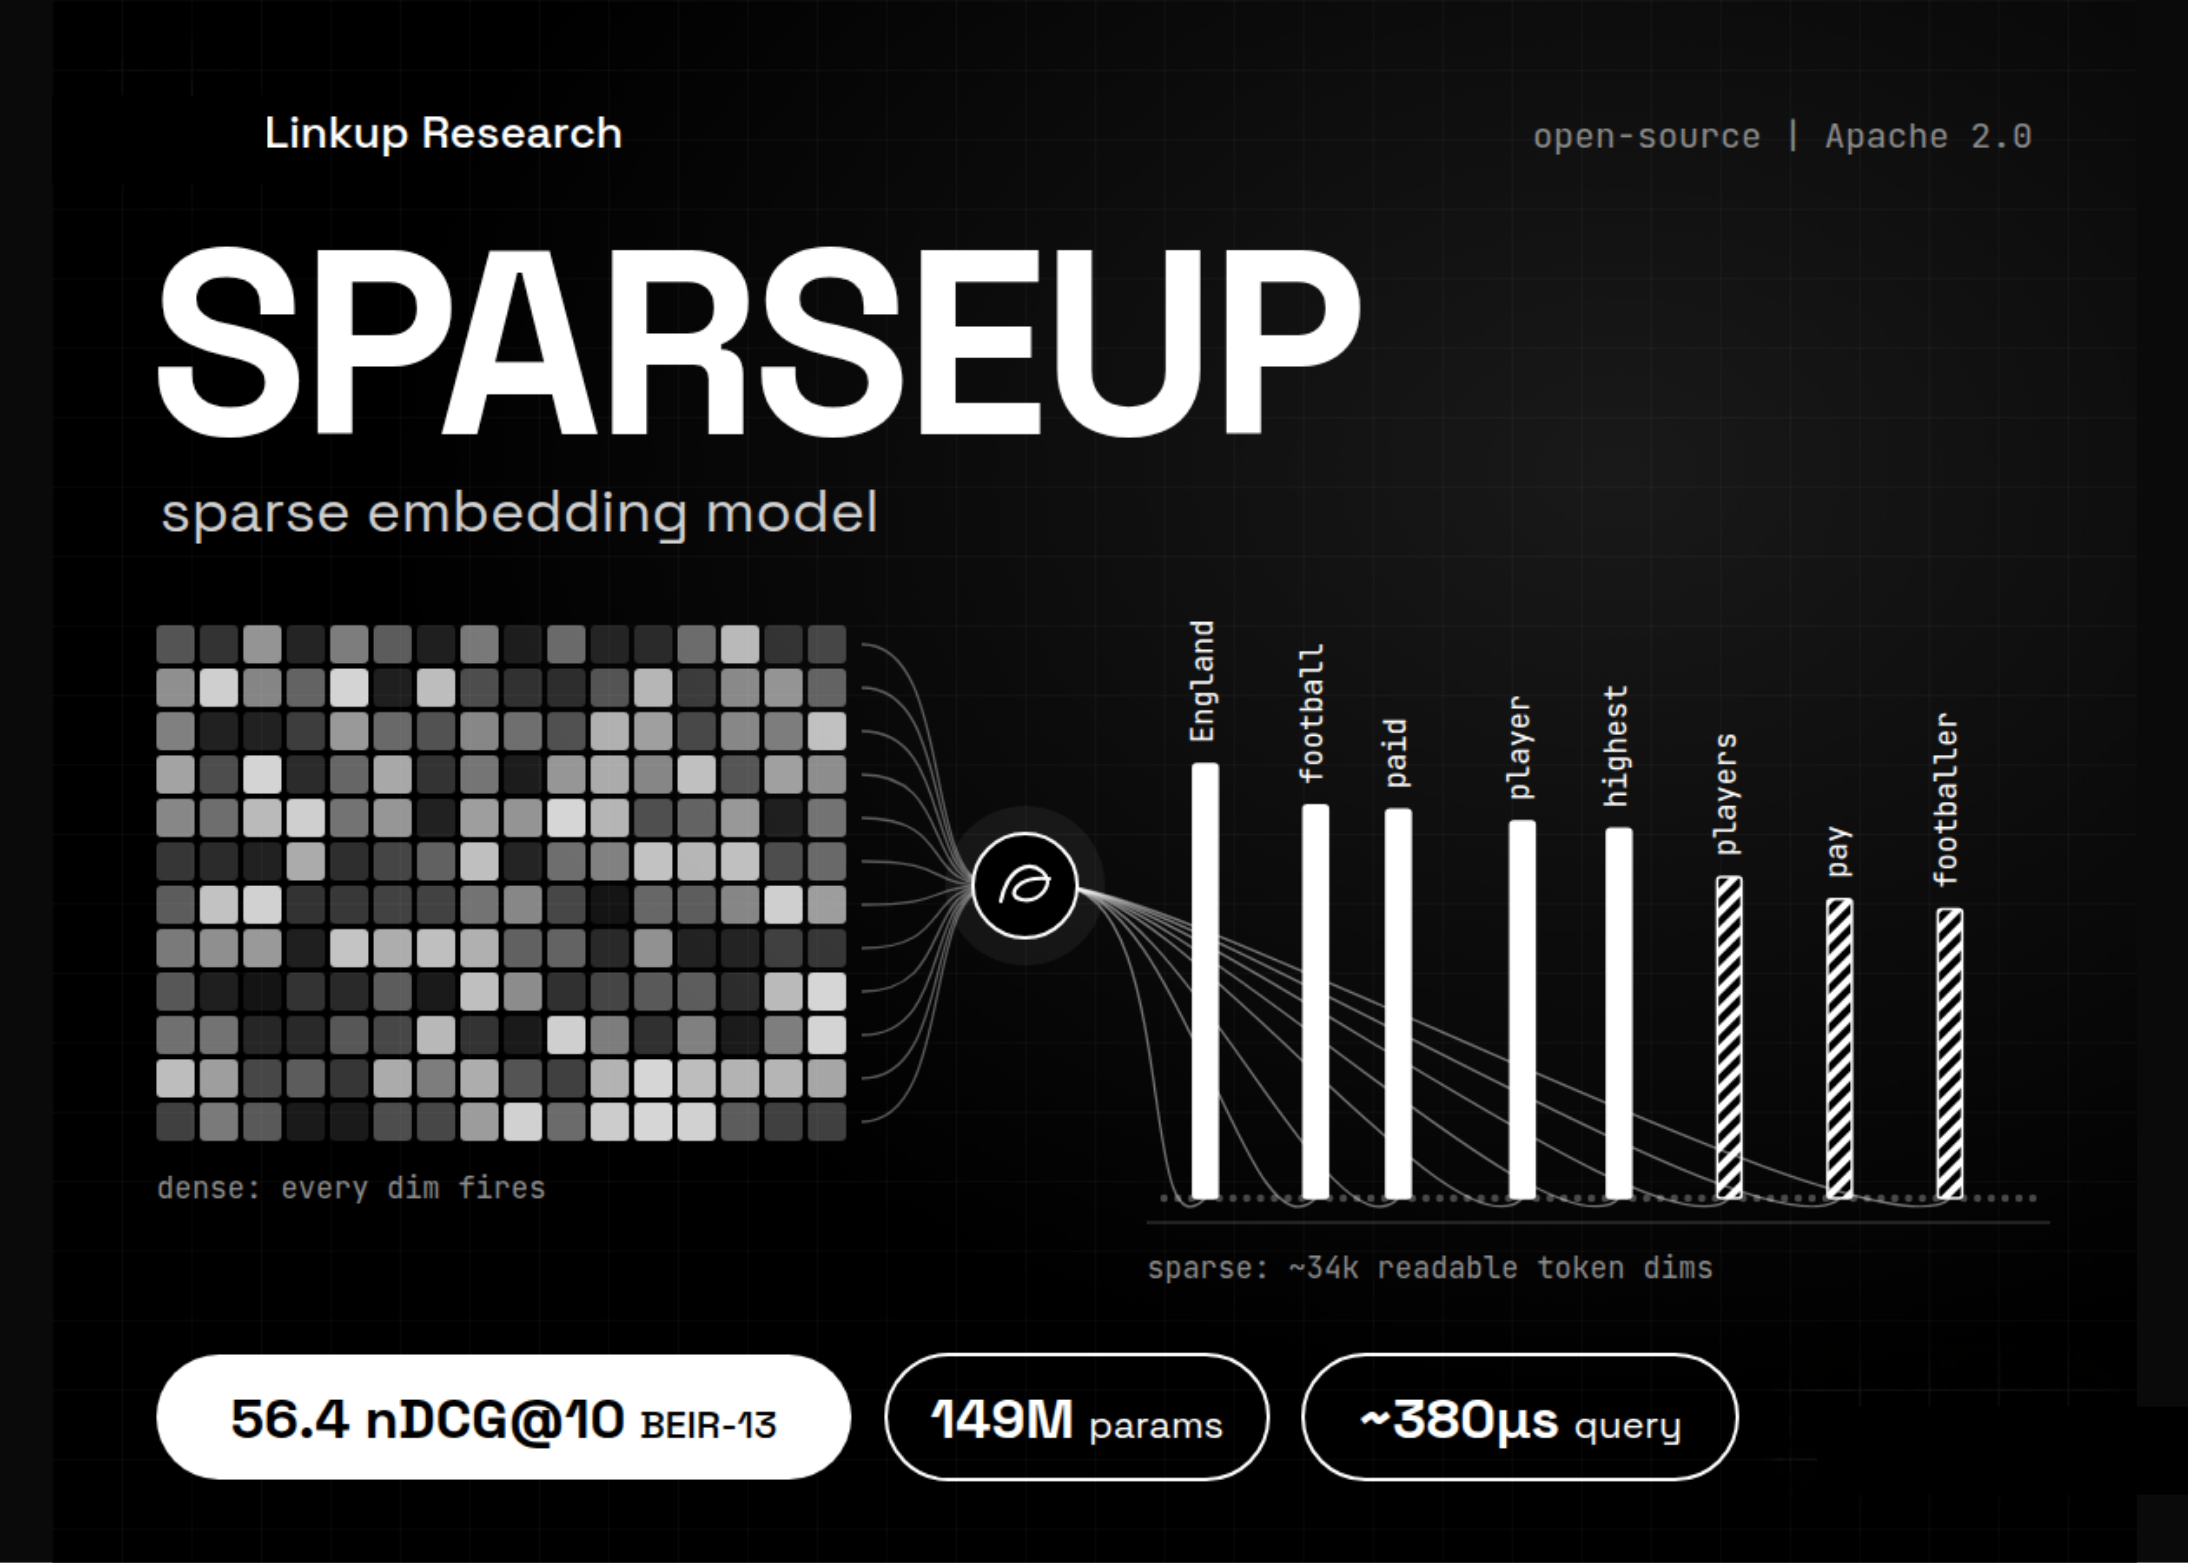
Linkupが、特定の言葉に注目して文章を理解する軽量AI「SPARSEUP」を公開。150M以下で最高の性能を持ち、文章検索の精度向上に役立ちます。
Linkup research teamは、オープンソースの学習済みsparse embedding modelであるSPARSEUPをリリースしました。このモデルは149MパラメータのModernBERTバックボーン上で動作し、Apache 2.0ライセンスで提供されます。Linkup teamは、BEIR-13において平均56.4のnDCG@10を報告しています。彼らはこれを、150Mパラメータ以下で知られている中で最も強力な公開されているvocabulary-based sparse encoderであると述べています。デプロイ可能でしょうか?はい。重みはHugging FaceでApache 2.0ライセンスの下で公開されています。このモデルは、trust_remote_code=Trueを設定することで、TransformersまたはSentence Transformersを通じてロードできます。なぜSparse Modelなのか、そしてなぜ今なのか。ほとんどのオープンな検索モデルはdense(密な)ものです。つまり、テキストごとに1つのベクトルを生成します。一方、sparseモデルは、語彙(vocabulary)に対する重みを出力します。各次元は実際のトークンに対応するため、ベクトルはinverted indexesに適合し、人間が読み取ることができます。また、稀な単語ともうまく一致する傾向があります。きっかけは、LightOnのDenseOnとLateOnのリリースでした。LightOnは、オープンデータ、学習レシピ、denseモデル、およびlate-interactionモデルを公開しました。SPARSEUPは、欠けていたsparseの枠を埋めるものです。同じバックボーンファミリーとfine-tuningデータを使用しているため、これら3つの検索スタイルすべてを並べて比較できます。SPARSEUPの構築方法。学習はLateOn-unsupervisedから開始されます。このチェックポイントにはMLM headがなかったため、チームはModernBERTのオリジナルのものを移植しました。fine-tuningでは、LightOnのfine-tuning mixtureをcontrastive learningのみで使用しました。各クエリは、50のプールからサンプリングされた7つのhard negativesと、in-batch negativesを取得します。cross-encoder distillationはなく、学習は単一のH100で実行可能です。このバックボーン上のバニラのSPLADEは、stopwordsでいっぱいの巨大なバッグを生成しました。Linkupはこれを3つの変更で修正しました。Logit shifting: エンコーダーはlog(1 + ReLU(x - 15))を計算します。ModernBERTのMLM logitsが高すぎたため、ログが飽和し、初期化時にバッグがdenseになっていました。Per-position top-k: 各入力トークンは、max poolingの前に、その最も強い12のvocabulary次元のみを保持します。これにより、トークンごとの拡張が制限され、合計ベクトルサイズは制限されません。Case folding: バイトレベルのBPEは、heat、Heat、Ġheat、およびĠHeatを別々のIDとして保存します。SPARSEUP
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。