コード作成AI、高性能化
Cognition Releases SWE-2: A Kimi K3 Post-Trained Coding Model That Matches Fable 5.1 on FrontierCode at 64% Lower Cost
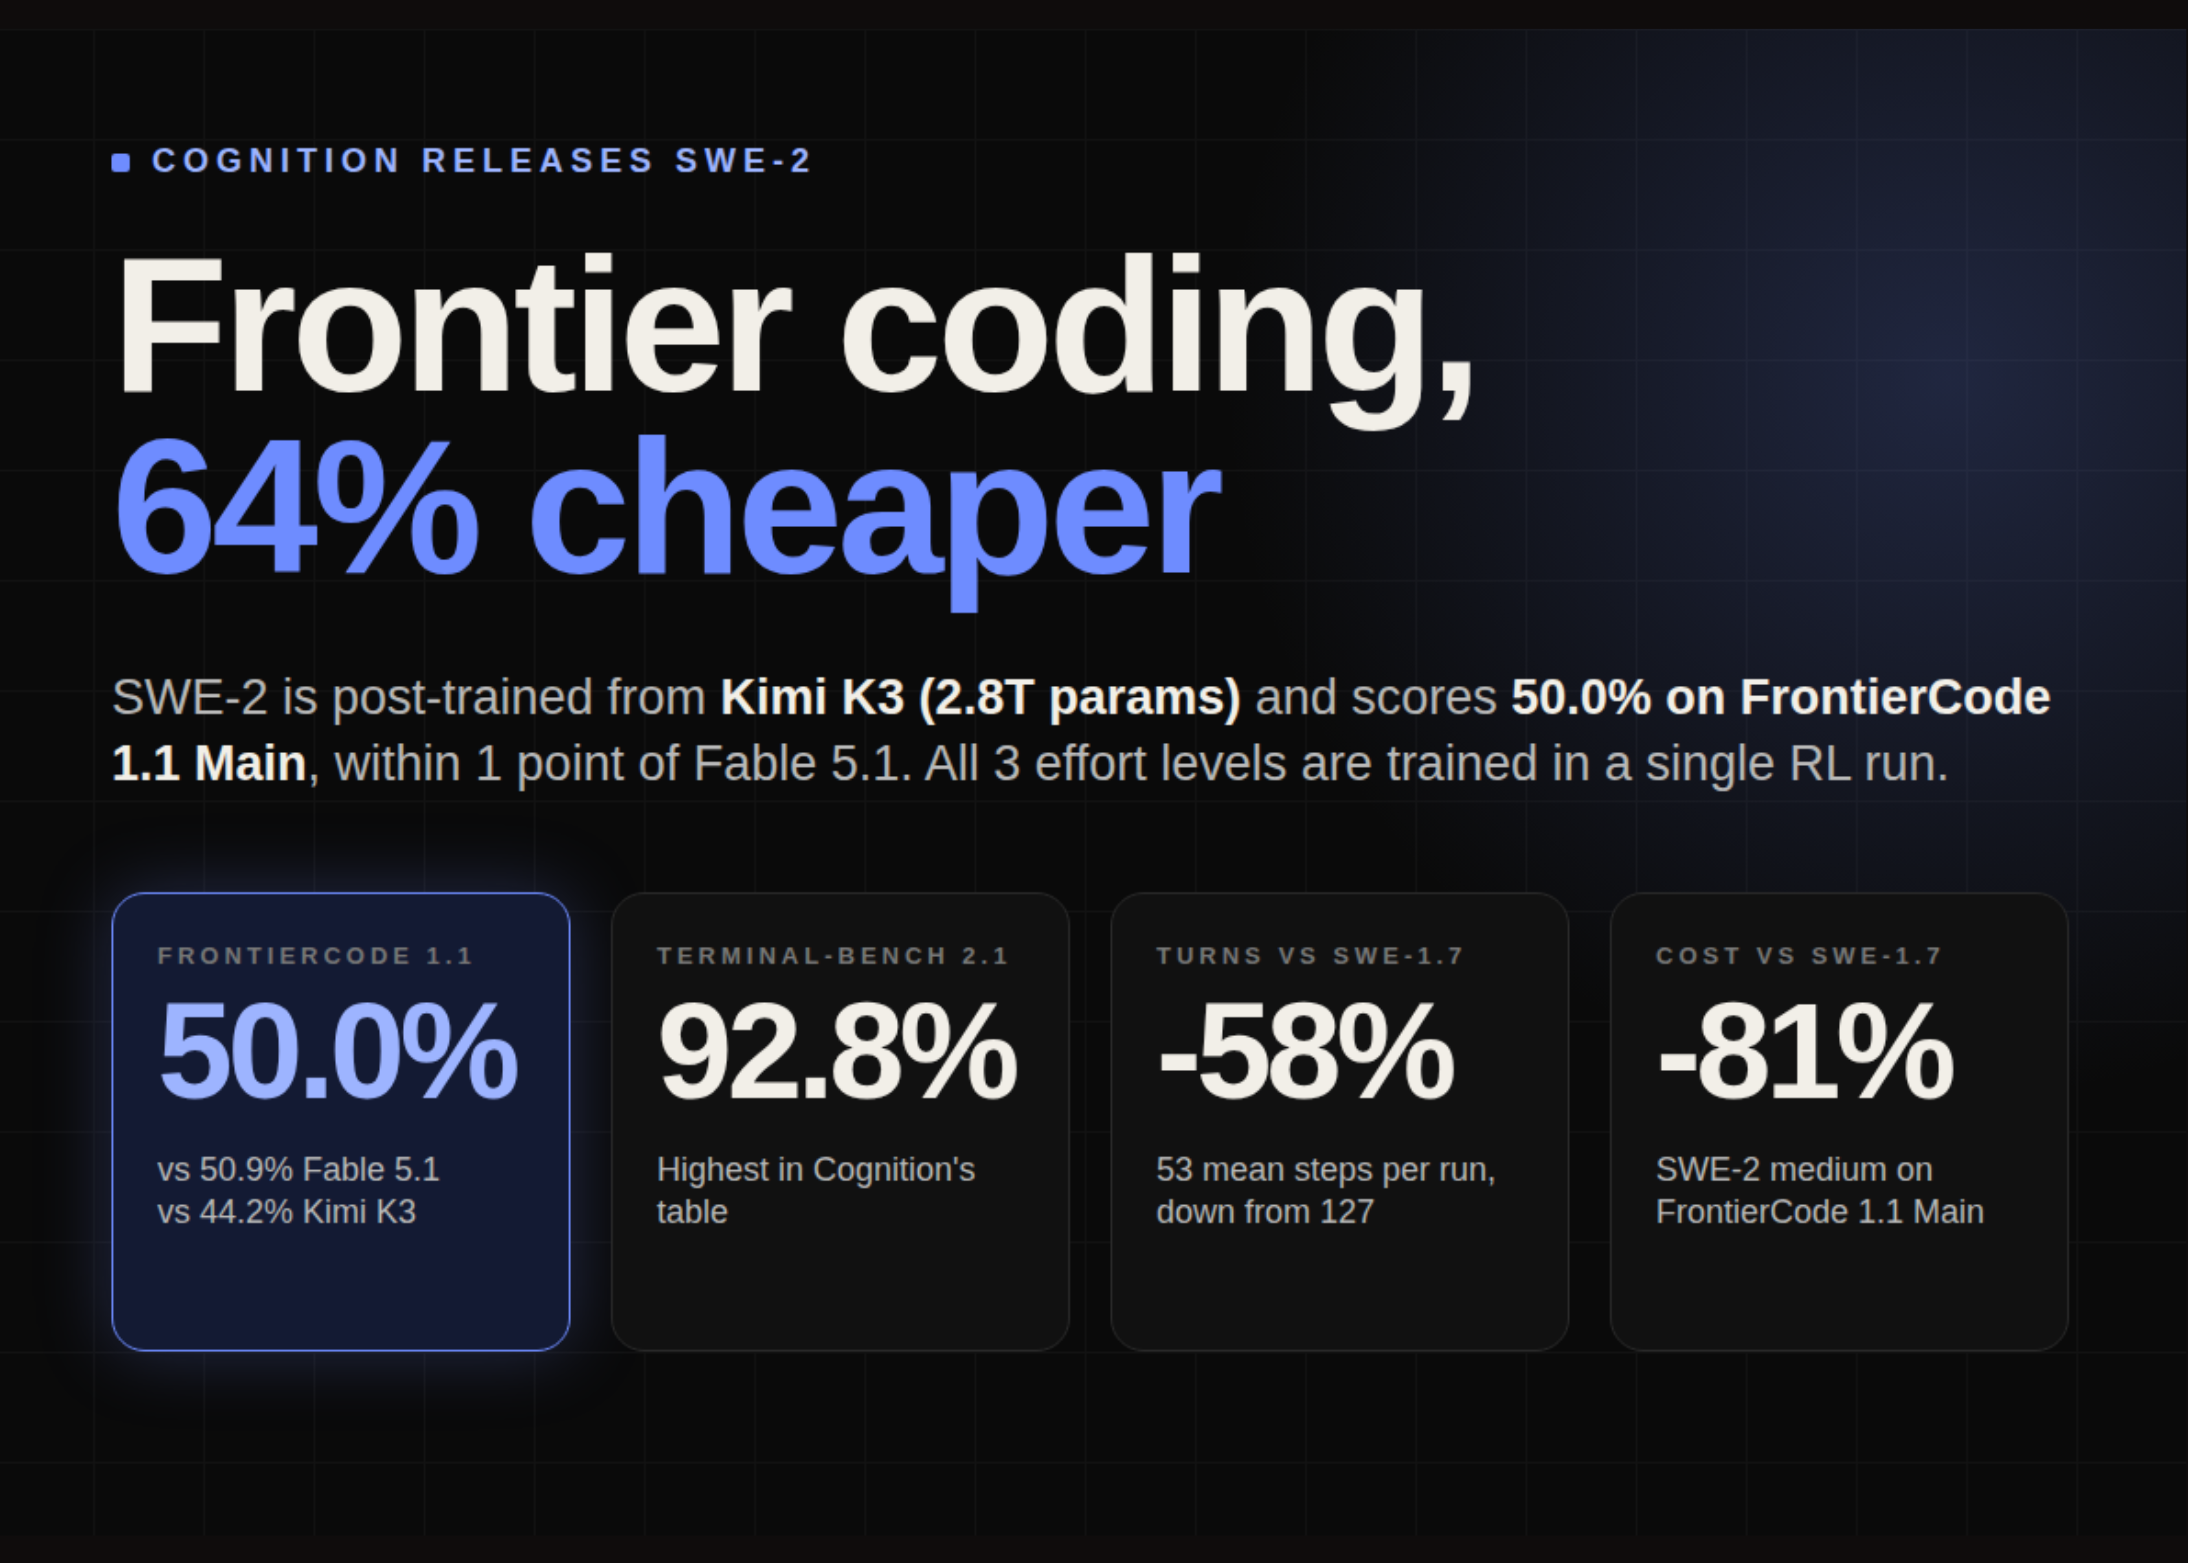
Cognitionが新しいコード作成AI「SWE-2」を発表。他の高性能AIと同等の成果を64%低い費用で実現し、AIによるコード作成の効率を大きく高めます。
Devinというコード作成AIを手がける企業Cognitionは、これまでで最も高性能なコード作成モデル「SWE-2」をリリースしました。SWE-2は、Moonshot AIの2.8兆パラメータのオープンモデルであるKimi K3から、強化学習(reinforcement learning)を用いて後学習されています。Cognitionの報告によると、FrontierCode 1.1 Mainで50.0%のスコアを達成し、Fable 5.1に1ポイント差まで迫りながら、コストは64%低いとのことです。また、SWE-2はCognition初の、推論の努力レベルを選択できるモデルであり、これらはすべて1回のRL実行で学習されました。 展開可能か?独自のインフラストラクチャでは不可能です。SWE-2はオープンウェイトを持たず、スタンドアロンのAPIもありません。現在、Devin: DesktopとCLI内でしか動作せず、Devin WebとFusionも順次展開される予定です。 SWE-2とは SWE-2は、Kimi K2.7から後学習されたSWE-1.7のインフラストラクチャとレシピに基づいて構築されています。今回は、CognitionがRLを数兆パラメータの領域にスケールアップし、約3倍のパラメータを持つ基盤モデルを使用しました。Cognitionによると、RLはK3の上でもまだかなりの改善余地を見つけ、多くのベンチマークで5〜6ポイントの向上をもたらしたとのことです。主な変更点は、3つの努力レベルすべてを1回の実行で学習するRLアルゴリズムです。各レベルには独自のコストペナルティがあるため、コストとパフォーマンスのフロンティア全体が一度に移動します。 ベンチマーク結果 Cognitionは以下の表を公開しました。公開されている結果がある場合はそれを使用し、そうでない場合は各モデルが独自のハーネスで最善の努力で実行されます。 ベンチマーク SWE-2 Kimi K3 Grok 4.6 Fable 5.1 GPT-5.6 Sol GPT-6 Astra SWE-1.7 FrontierCode 1.1 Main 50.0% 44.2% 48.0% 50.9% 47.5% 53.3% 42.0% DeepSWE 1.1 73.0% 68.5% 67.5% 67.4% 72.7% 74.1% 37.7% Terminal-Bench 2.1 92.8% 88.3% 88.4% 91.4% 88.8% 89.9% 81.5% Terminal-Bench 4 27.3% 21.5% 20.3% 55.8% 37.3% 57.9% 7.6% SWE-2はTerminal-Bench 2.1でトップに立ち、すべての項目でその基盤であるK3を上回っています。Cognitionは、GPT-6 Astraに数ポイント差まで迫り、コストは4分の1であると述べています。明確な弱点はTerminal-Bench 4で、SWE-2はFable 5.1とGPT-6 Astraに約30ポイント差で遅れをとっています。FrontierCodeはCognition独自のベンチマークであり、競合するすべての数値はCognitionから提供されています。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。