多機能AIで情報探しと回答生成
Building a Multimodal RAG Pipeline with NVIDIA NeMo Retriever, Hosted NIMs, LanceDB, Reranking, and Grounded Generation
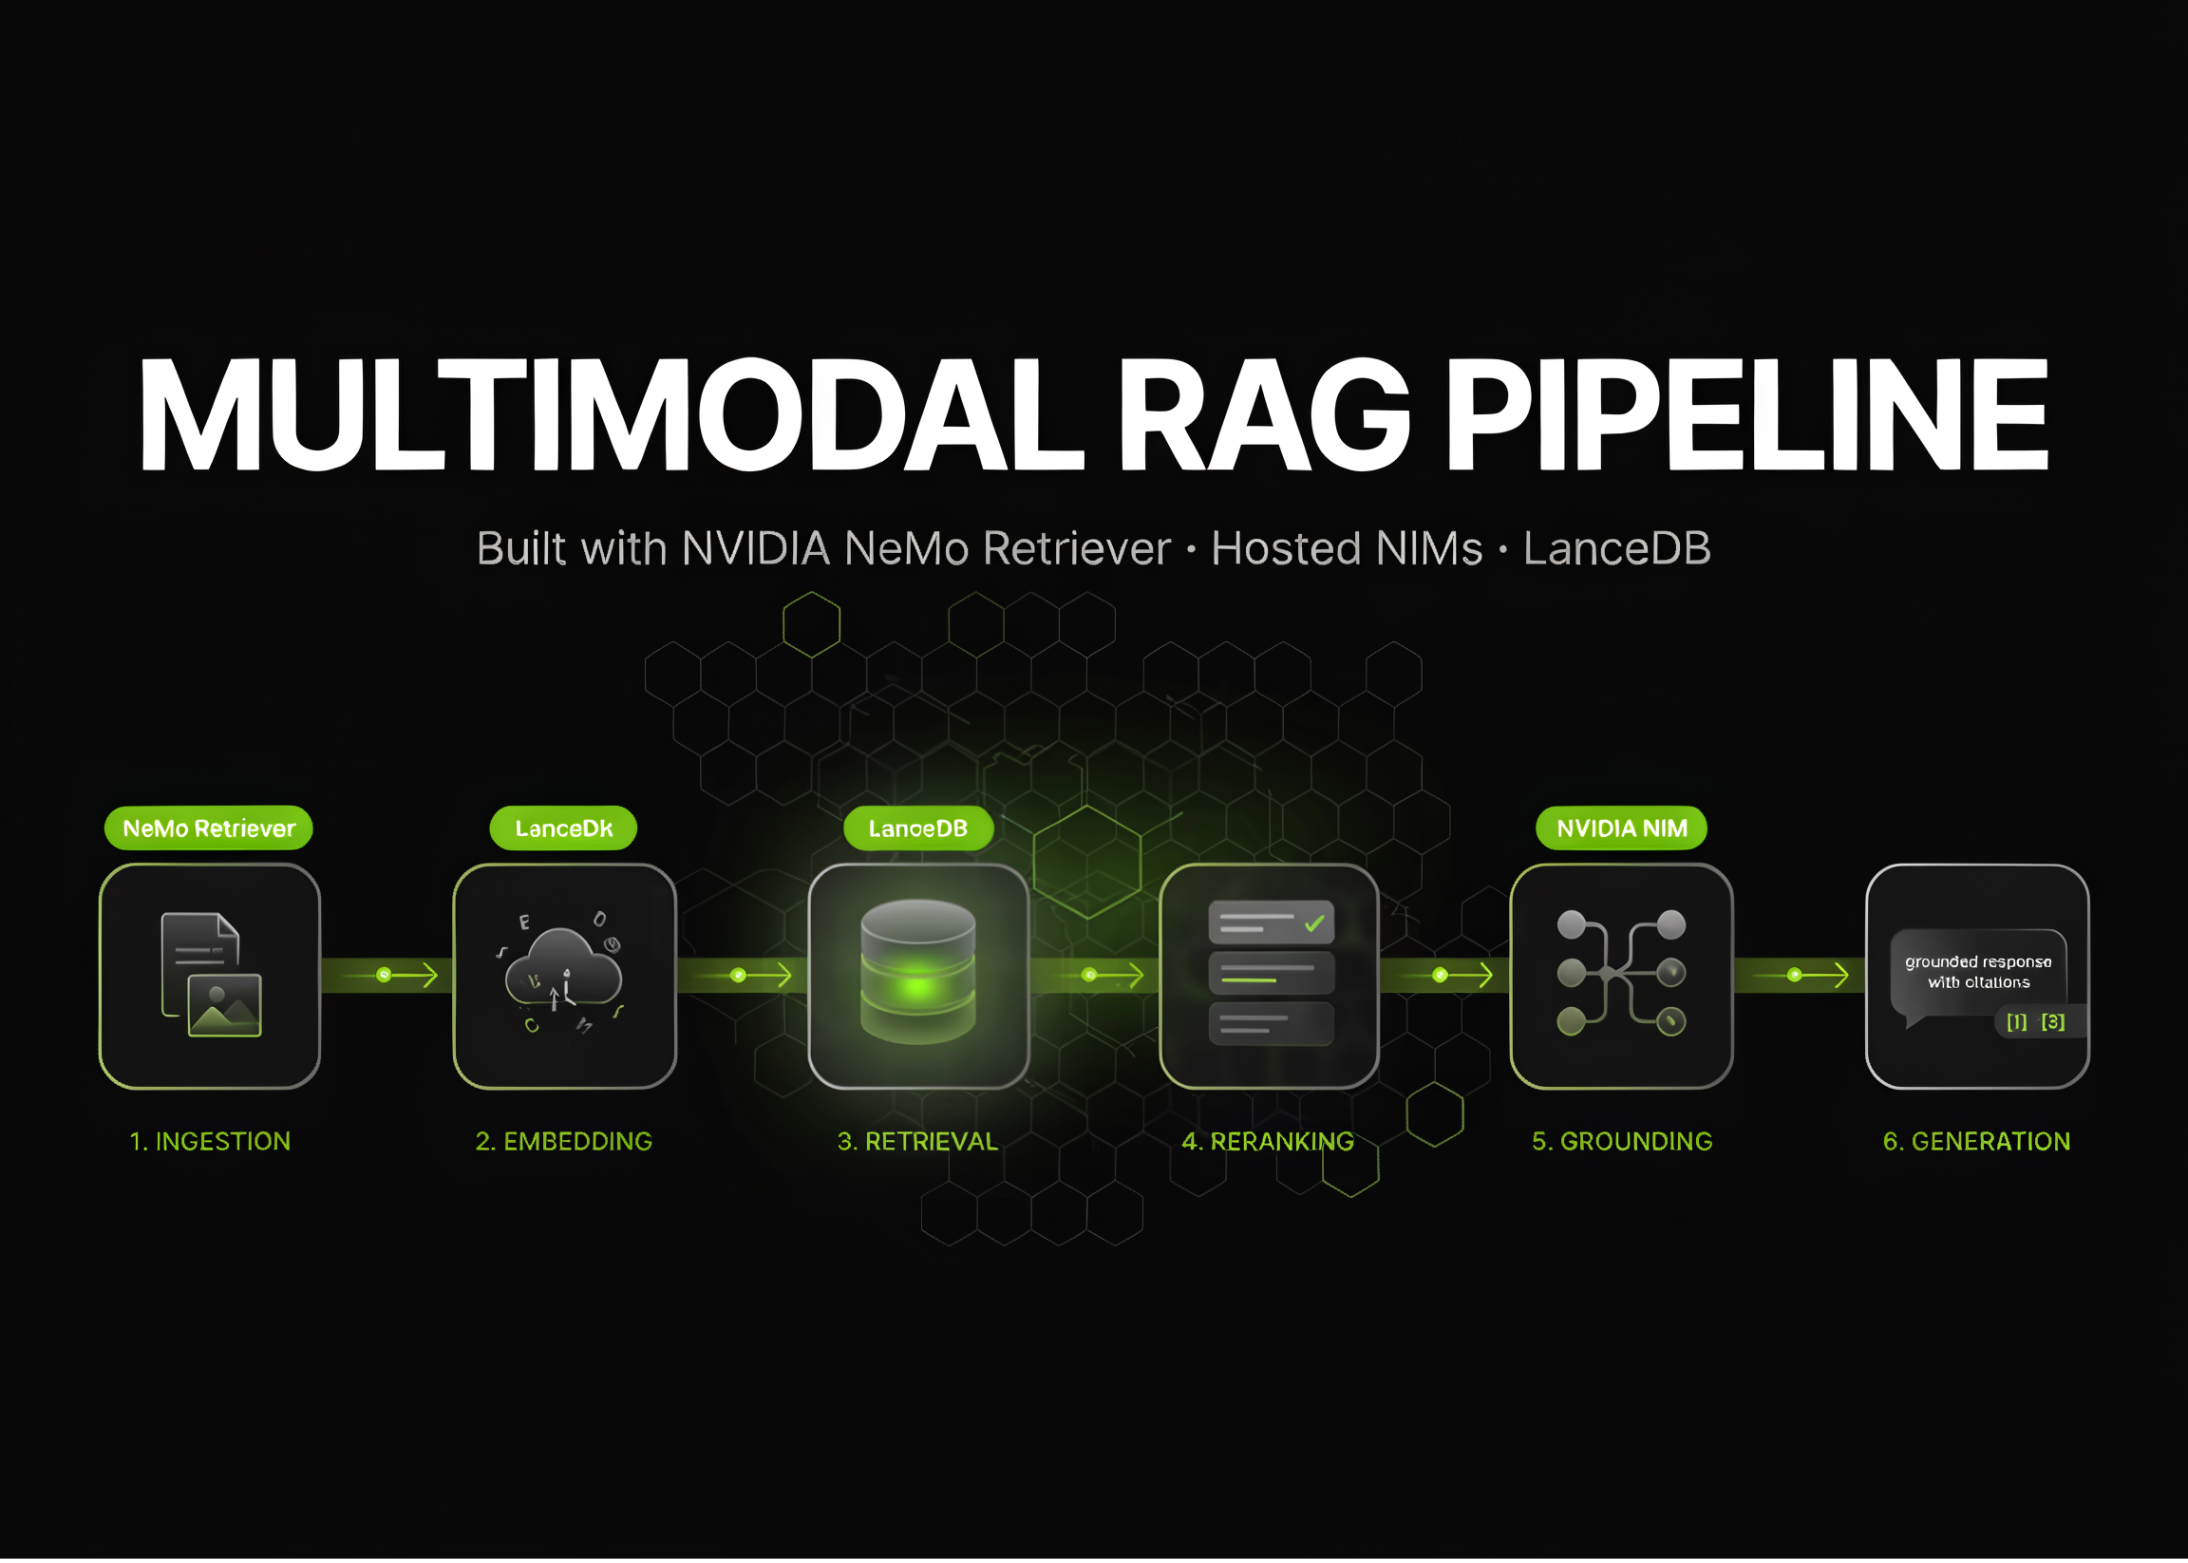
NVIDIAが、画像やテキストなど様々な情報から正確な回答を生成するAIの作り方を公開。これにより、AIがより賢く質問に答えられるようになります。
このチュートリアルでは、NVIDIA NeMo Retriever を使用して、高度なマルチモーダルRAGパイプラインを構築します。まず、Python 3.12環境を設定し、必要なパッケージをインストールし、GPUや外部APIキーに依存せずにオフラインでPDFテキスト抽出を実行します。次に、ホストされたNVIDIA NIM endpointsを使用して、ページ要素の検出、テーブル、チャート、インフォグラフィックの抽出、dense vector embeddingsの生成、および処理されたコンテンツのLanceDBへの保存を行います。最後に、dense retrieval、vision-language reranking、metadata-filtered search、inline citations付きのgrounded response generation、およびマルチモーダルドキュメントコンテンツ全体の検索品質を検証するための軽量なrecall-at-k評価を実装します。
コードをコピーしました。別のブラウザを使用してください。
import sys, os, subprocess, textwrap, json, time, warnings warnings.filterwarnings("ignore") assert sys.version_info[:2] == (3, 12), ( f"nemo-retriever requires Python 3.12.x (found {sys.version.split()[0]}). " "Colab's default runtime is 3.12; if you changed it, switch back." ) def sh(cmd): print(f"$ {cmd}") subprocess.run(cmd, shell=True, check=False) try: import nemo_retriever print("nemo-retriever already installed") except ImportError: sh("pip install -q --ignore-installed PyJWT nemo-retriever openai") import nemo_retriever print("nemo-retriever version:", nemo_retriever.__version__) from nemo_retriever import create_ingestor try: from nemo_retriever.io import to_markdown, to_markdown_by_page except ImportError: from nemo_retriever.common.io import to_markdown, to_markdown_by_page try: from nemo_retriever.retriever import Retriever except ImportError: from nemo_retriever.graph.retriever import Retriever import pandas as pd pd.set_option("display.max_colwidth", 160) DOC = "multimodal_test.pdf" if not os.path.exists(DOC): sh(f"curl -sL -o {DOC} " "https://raw.githubusercontent.com/NVIDIA/NeMo-Retriever/main/data/multimodal_test.pdf") print("document:", DOC, os.path.getsize(DOC), "bytes")
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。