NVIDIA、AIでタンパク質生成を高速化
NVIDIA Details BioNeMo Inference Runtime (BioIR): 2.90x Higher Boltz-2 Folding Throughput and 58.5K Residues per GPU-Hour on 8xH100
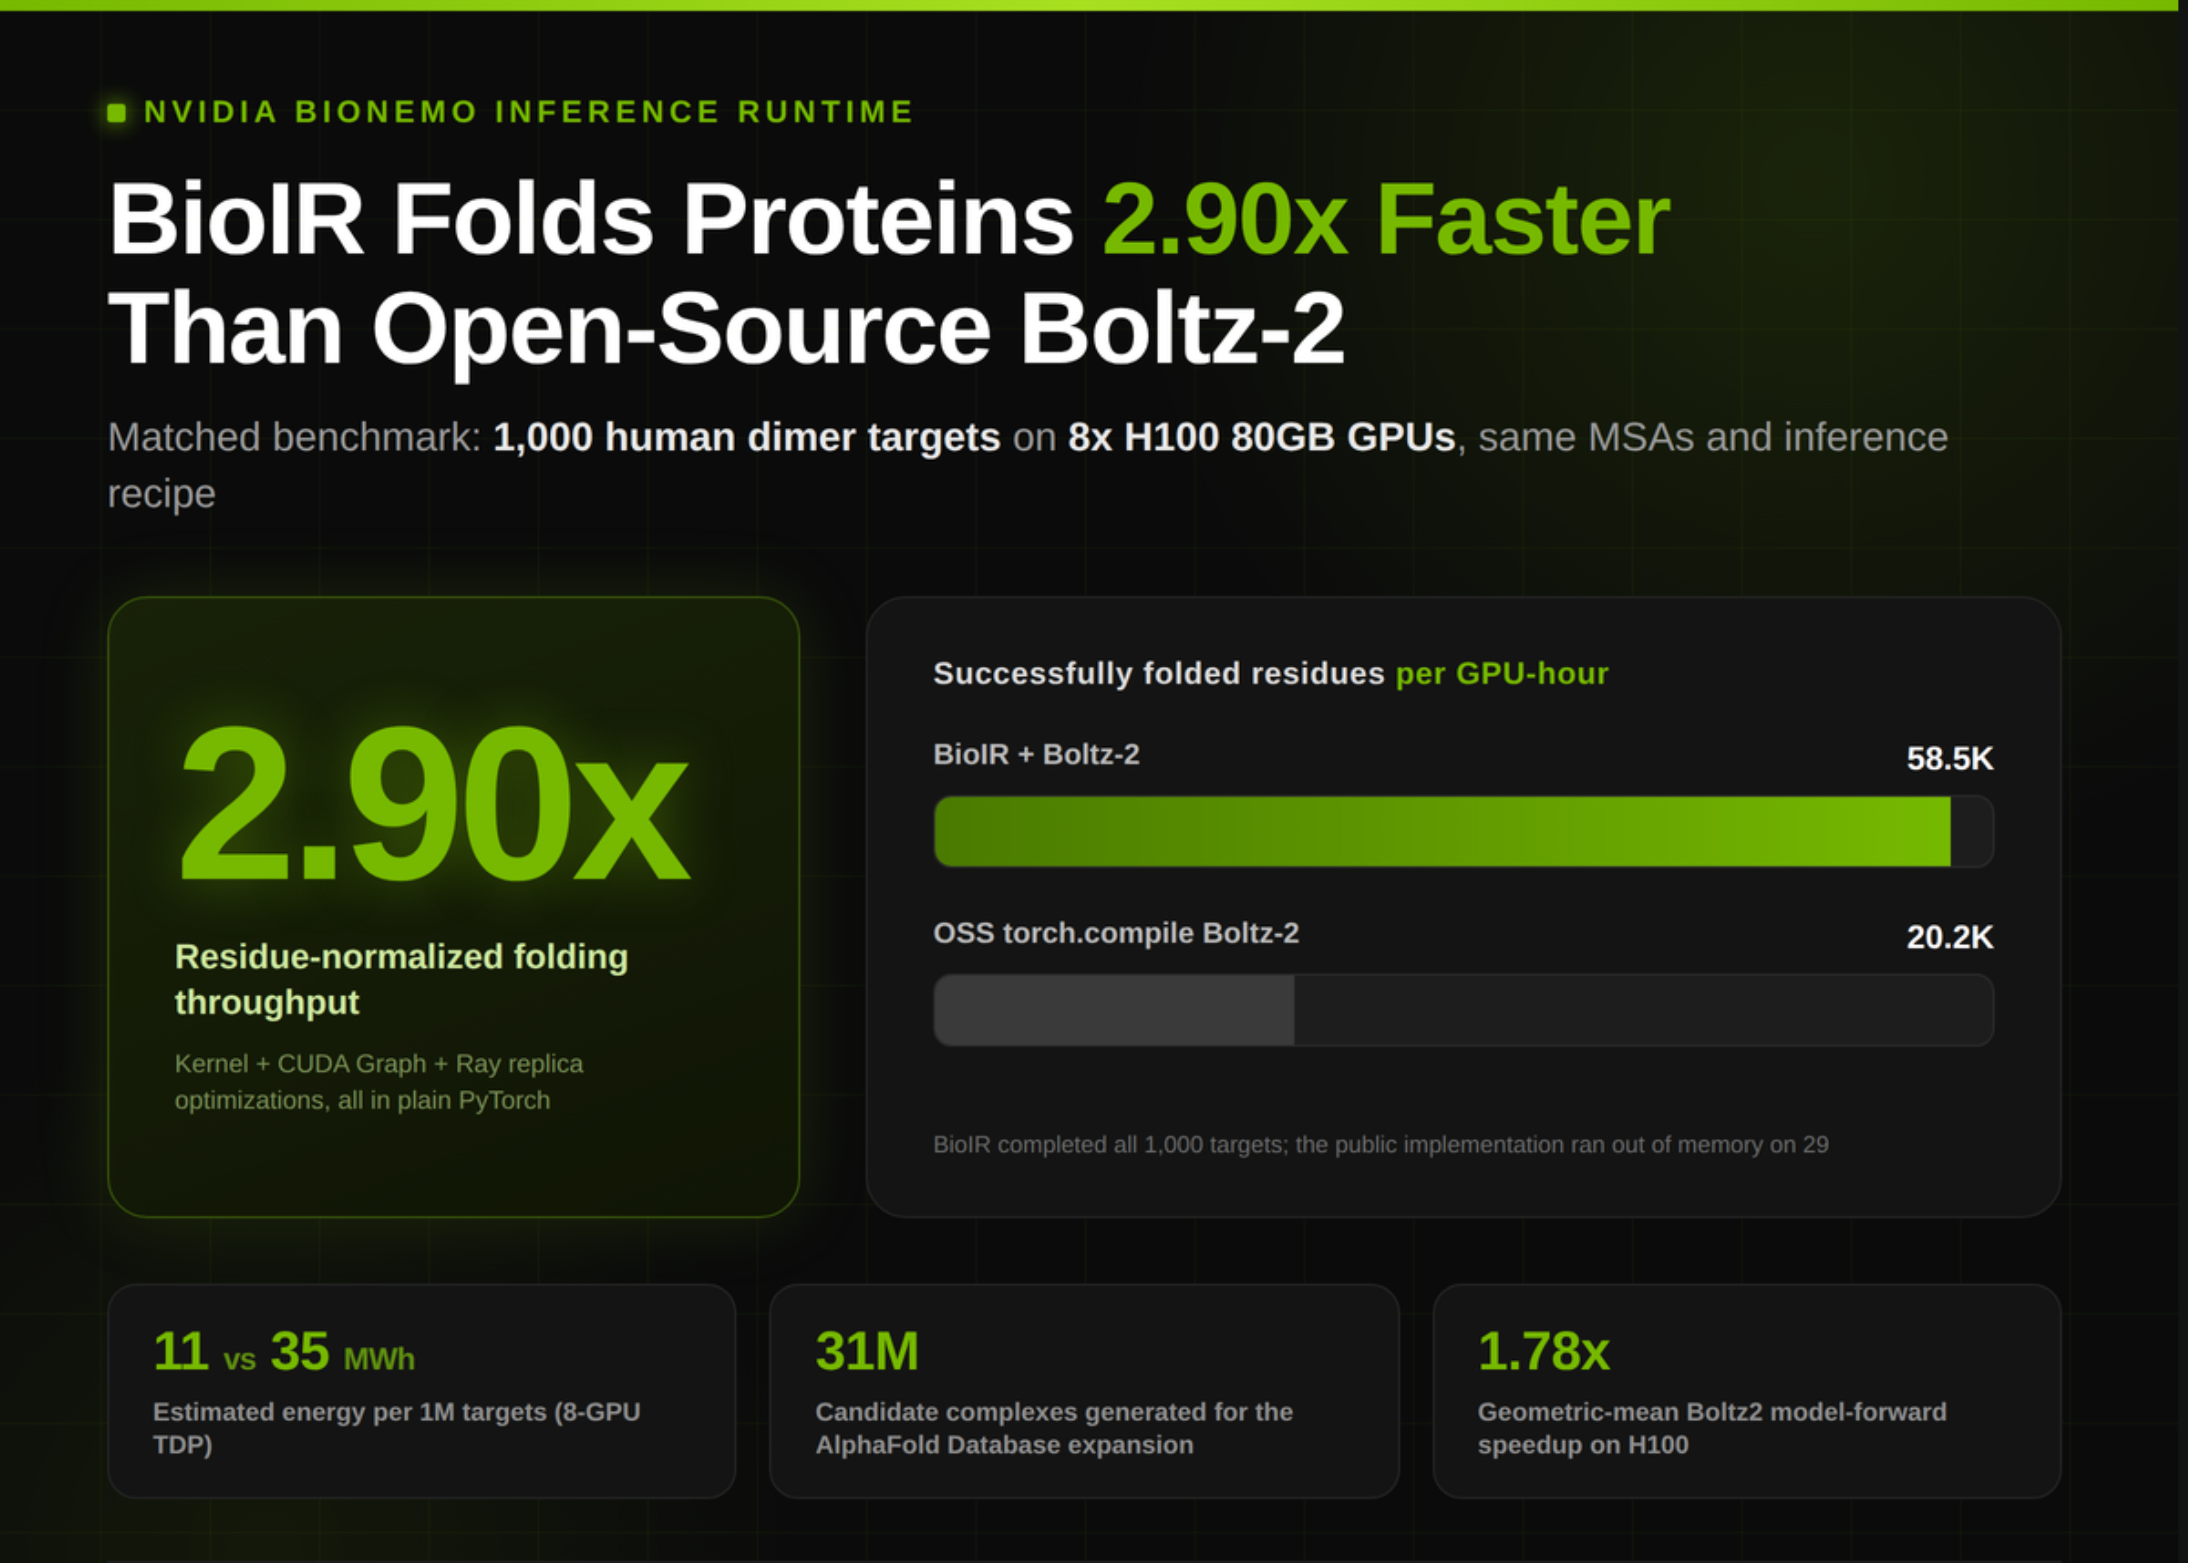
NVIDIAがAIによるタンパク質構造予測を最大2.9倍高速化するBioIRを発表。これにより、生命科学研究や新薬開発が効率化されます。
生体分子構造予測は、単一ターゲットの実行からプロテオーム規模のワークリストへと移行しました。ボトルネックは、もはやモデルがタンパク質を折りたたむことができるかどうかではなくなっています。それは、独立したターゲットのキュー全体が、解析、特徴抽出、GPU inference、および出力書き込みをどれだけ速く通過するかです。NVIDIAの新しい技術的な詳細解説では、BioNeMo Inference Runtime (BioIR)について説明しています。これは、標準のPyTorchワークフローを維持しながら、NVIDIA GPU上でサポートされている構造予測モデルを高速化するPythonライブラリです。BioIRはすでに本番規模で稼働しています。これは、最近のAlphaFold Databaseの拡張を支え、4,777のプロテオームにわたるタンパク質複合体構造を生成し、約3,100万の候補複合体のうち181万が高信頼性予測としてリリースされました。展開可能でしょうか?はい。BioIRは現在、プリコンパイルされたCUBINを含むwheelを備えたオープンなGitHubリポジトリとして利用可能です。ランタイムの使用には、Python 3.12+、互換性のあるNVIDIA GPUとドライバー、ステージングされたmodel checkpoint、およびチェーンごとのA3M MSAsが必要です。nvcc、CUDA source、CMake、またはCUDA toolkitは必要ありません。BioIRとは BioIRは、汎用inferenceスタックが完全に最適化しない操作をターゲットとしています。これらには、PairformerおよびEvoformerスタック、triangle operations、pairwise attention、diffusion transformers、およびatom-level modulesが含まれます。モデルは通常のtorch.nn.Moduleオブジェクトのままです。engine build、export step、またはcheckpointとforward passの間に個別のartifactはありません。使用方法は2つあります。エンドツーエンドのプロセッサは、InputRequestを解析、トークン化、特徴生成、GPU inference、およびPDBまたはmmCIF書き込みを通じて移動させます。直接的なPyTorch統合により、開発者はサポートされているモデルを構築したり、カスタムコード内で選択された最適化モジュールを再利用したりできます。チュートリアルでは、Boltz-2 (model_source="boltz-2")を使用したプロセッサパスを示しています。各タンパク質鎖にはA3M MSAが必要です。複数の非同一タンパク質鎖を持つ入力には、ペアまたは非ペアのMSAsが受け入れられます。テンプレートは提供できます
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。