画像や音を理解する小型AI公開
Thinking Machines Lab Releases Inkling-Small: A 276B Total, 12B Active Open Weights Multimodal MoE Model
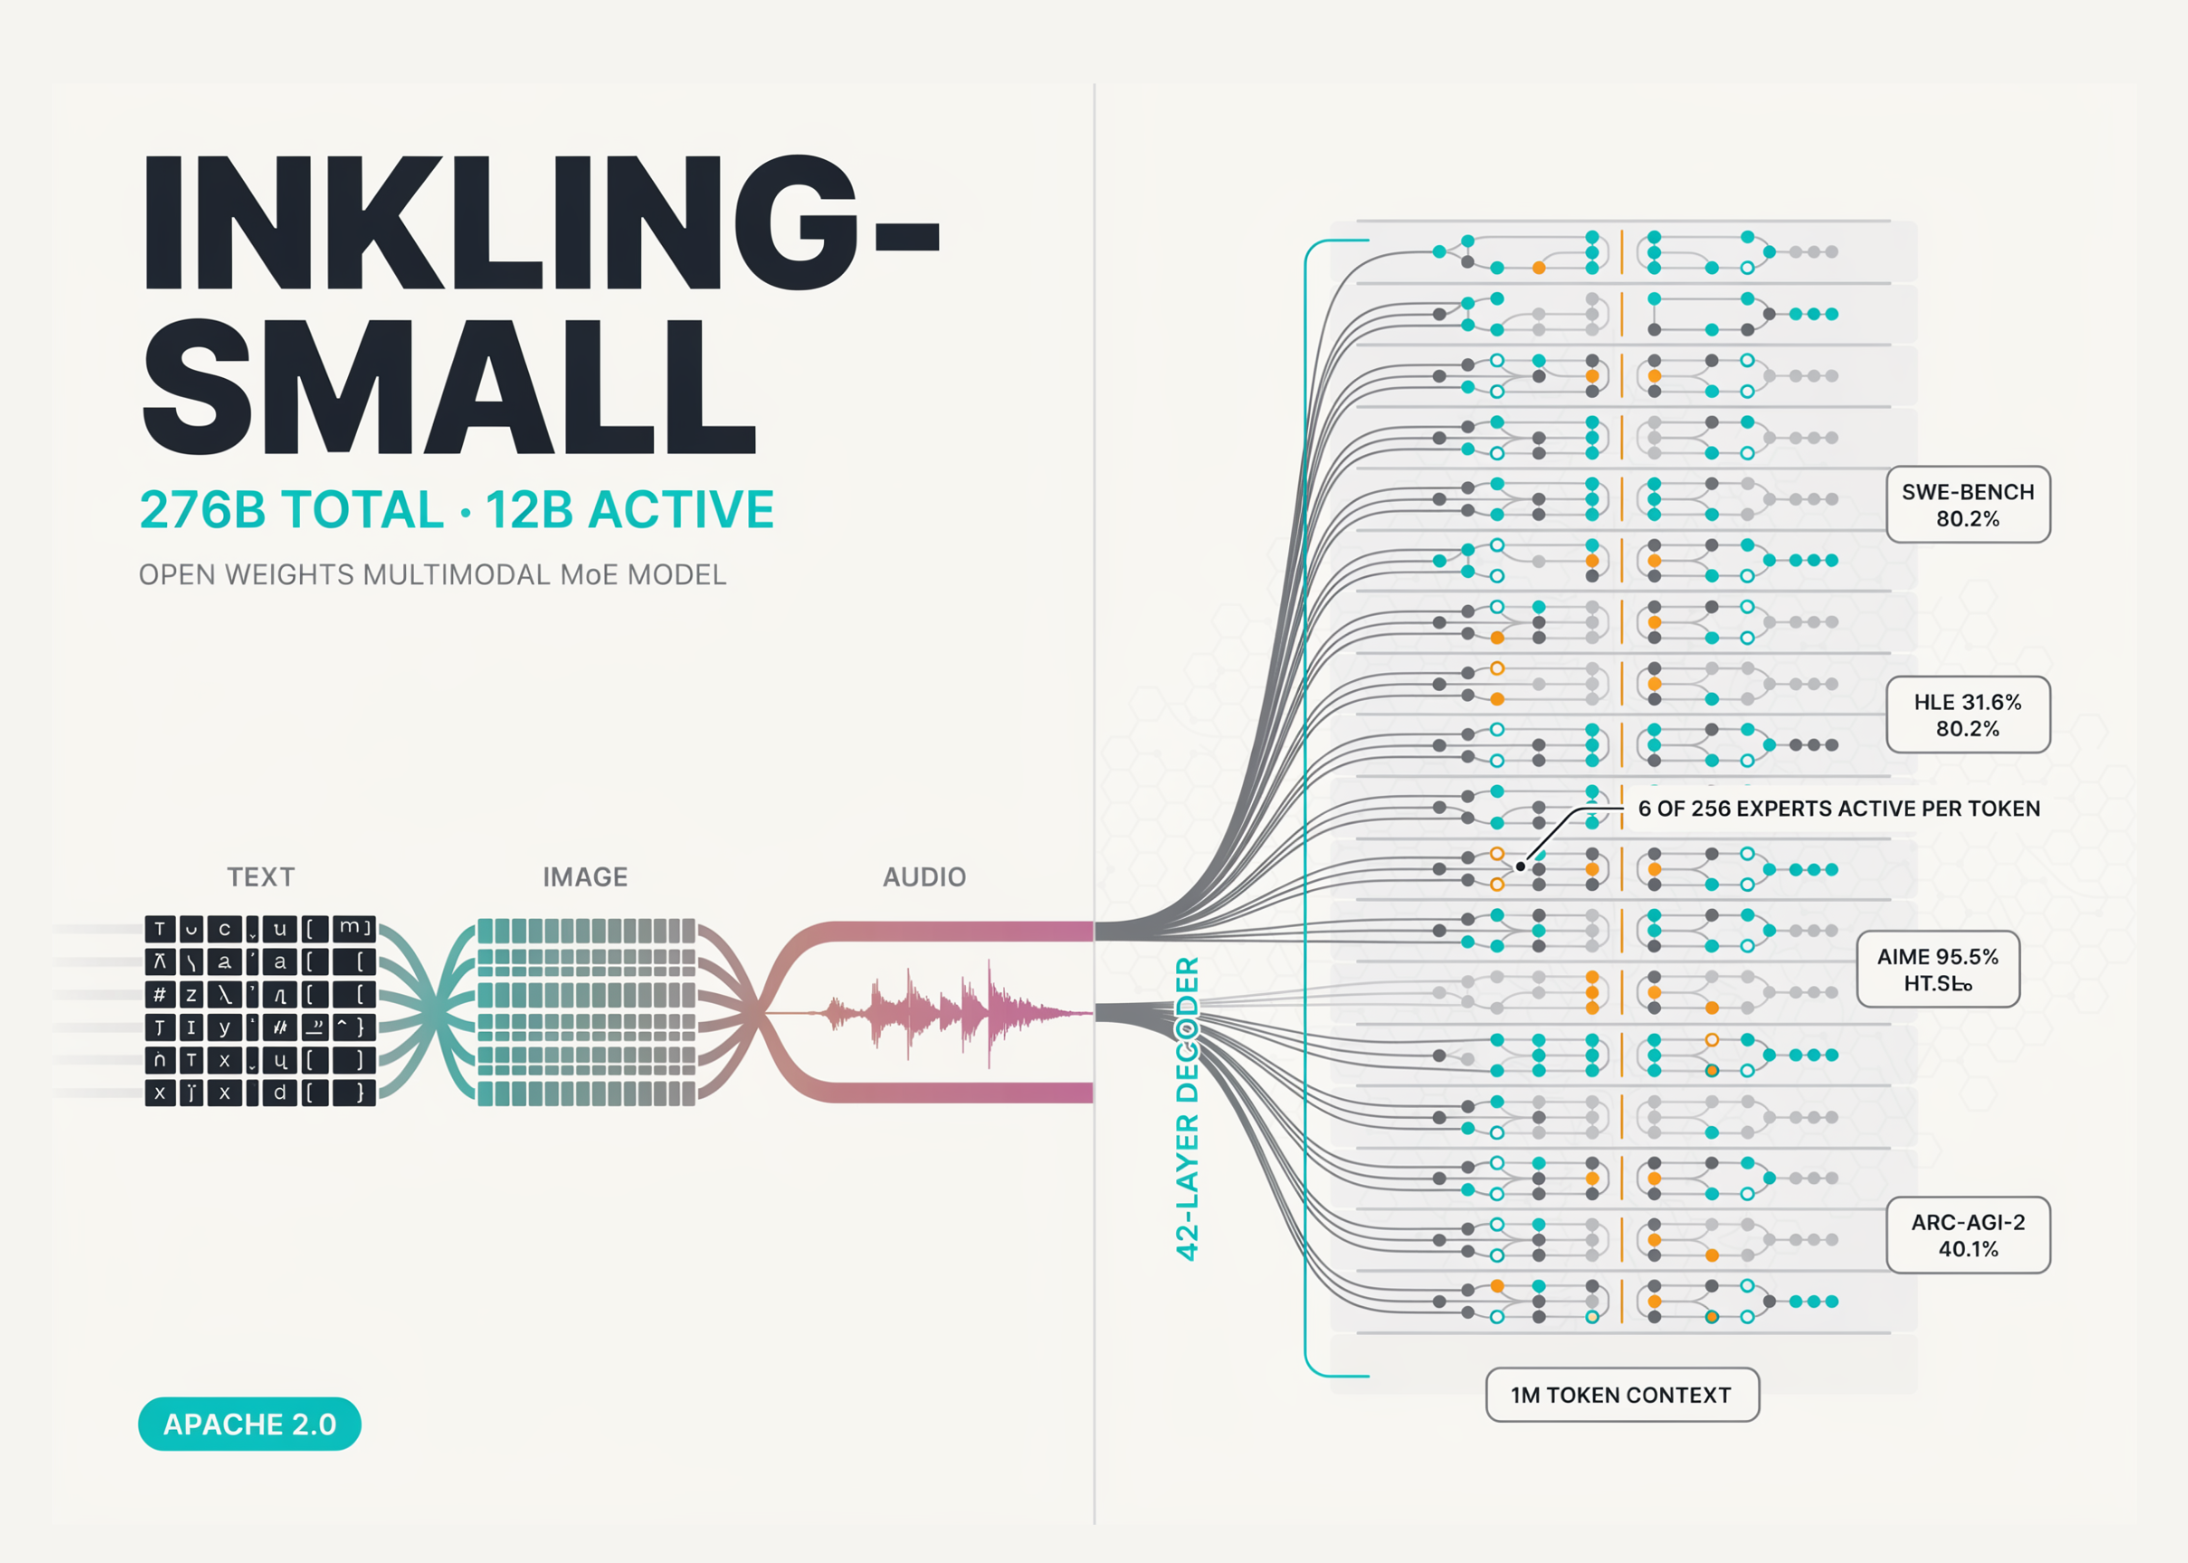
Thinking Machines Labが、画像や音を理解するAI「Inkling-Small」を公開。合計2760億の賢い部分を使い分ける仕組みで、少ない計算力でも動くため、企業がAIを導入しやすくなります。
Thinking Machines Labは、合計2760億のパラメータを持ち、そのうち120億がアクティブなオープンウェイトのMixture-of-Expertsモデル「Inkling-Small」をリリースしました。これは、合計9750億、アクティブ410億のパラメータを持つInklingの約4分の1のサイズです。このモデルはNVIDIA GB300 NVL72システムで訓練されました。テキスト、画像、音声をネイティブに推論します。コンテキストウィンドウは1Mトークンに達し、思考の労力は調整可能です。ウェイトはApache 2.0ライセンスのもとHugging Faceで提供されています。展開可能か?はい、そして量子化されたチェックポイントがその理由です。モデルカードによると、BF16チェックポイントには少なくとも600 GBの集約VRAMが必要です。これは4x NVIDIA B300または8x NVIDIA H200で満たされます。NVFP4チェックポイントは、その最低要件を180 GBにまで下げます。これは、SM100+を必要とする単一のB300でW4A4として、または2つのH200でW4A16として動作します。サポートされているランタイムはSGLang、vLLM、TokenSpeed、Unsloth、Hugging Faceです。このシングルGPUパスにより、2760億のモデルが最先端の研究室の領域から外れます。スタートアップ企業は、レンタルした1つのB300インスタンスでセルフホストできます。既存のH200容量を持つ中規模企業は、新しいハードウェアなしでこれを運用できます。金融サービス、医療業務、保険、通信、公共部門といった規制された分野では、プライベートウェイトの選択肢が得られます。適用可能なワークロードには、コーディングエージェント、端末自動化、ドキュメントおよびチャートの理解が含まれます。音声は、コールセンター分析、音声インターフェース、会議の要約へとその範囲を広げます。アーキテクチャ:Inkling-Smallは、スパースなMoEフィードフォワードバックボーンを持つ42層のデコーダーオンリーTransformerです。各トークンは256のエキスパートのうち6つにルーティングされ、さらにすべてのトークンでアクティブな2つの共有エキスパートがあります。アテンションはローカル層とグローバル層のハイブリッドです。このモデルはエンコーダーフリーで、ネイティブにマルチモーダルです。画像は40x40ピクセルのパッチに分割され、4層のhMLPを使用して変換されます。音声はdMelスペクトログラムとして表現されます。どちらも軽量なembedding層を通過し、テキストトークンと共同で処理されます。数値サポートはBF16、MXFP8、NVFP4をカバーします。音声入力は16 kHzのWAV形式で、理想的には2分以内です。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。