中国の2社が同じAI構造を開発
GLM-5.3-Flash vs Qwen3.8-Flash-Next: Two Chinese AI Labs Independently Converge on the Same Model Architecture
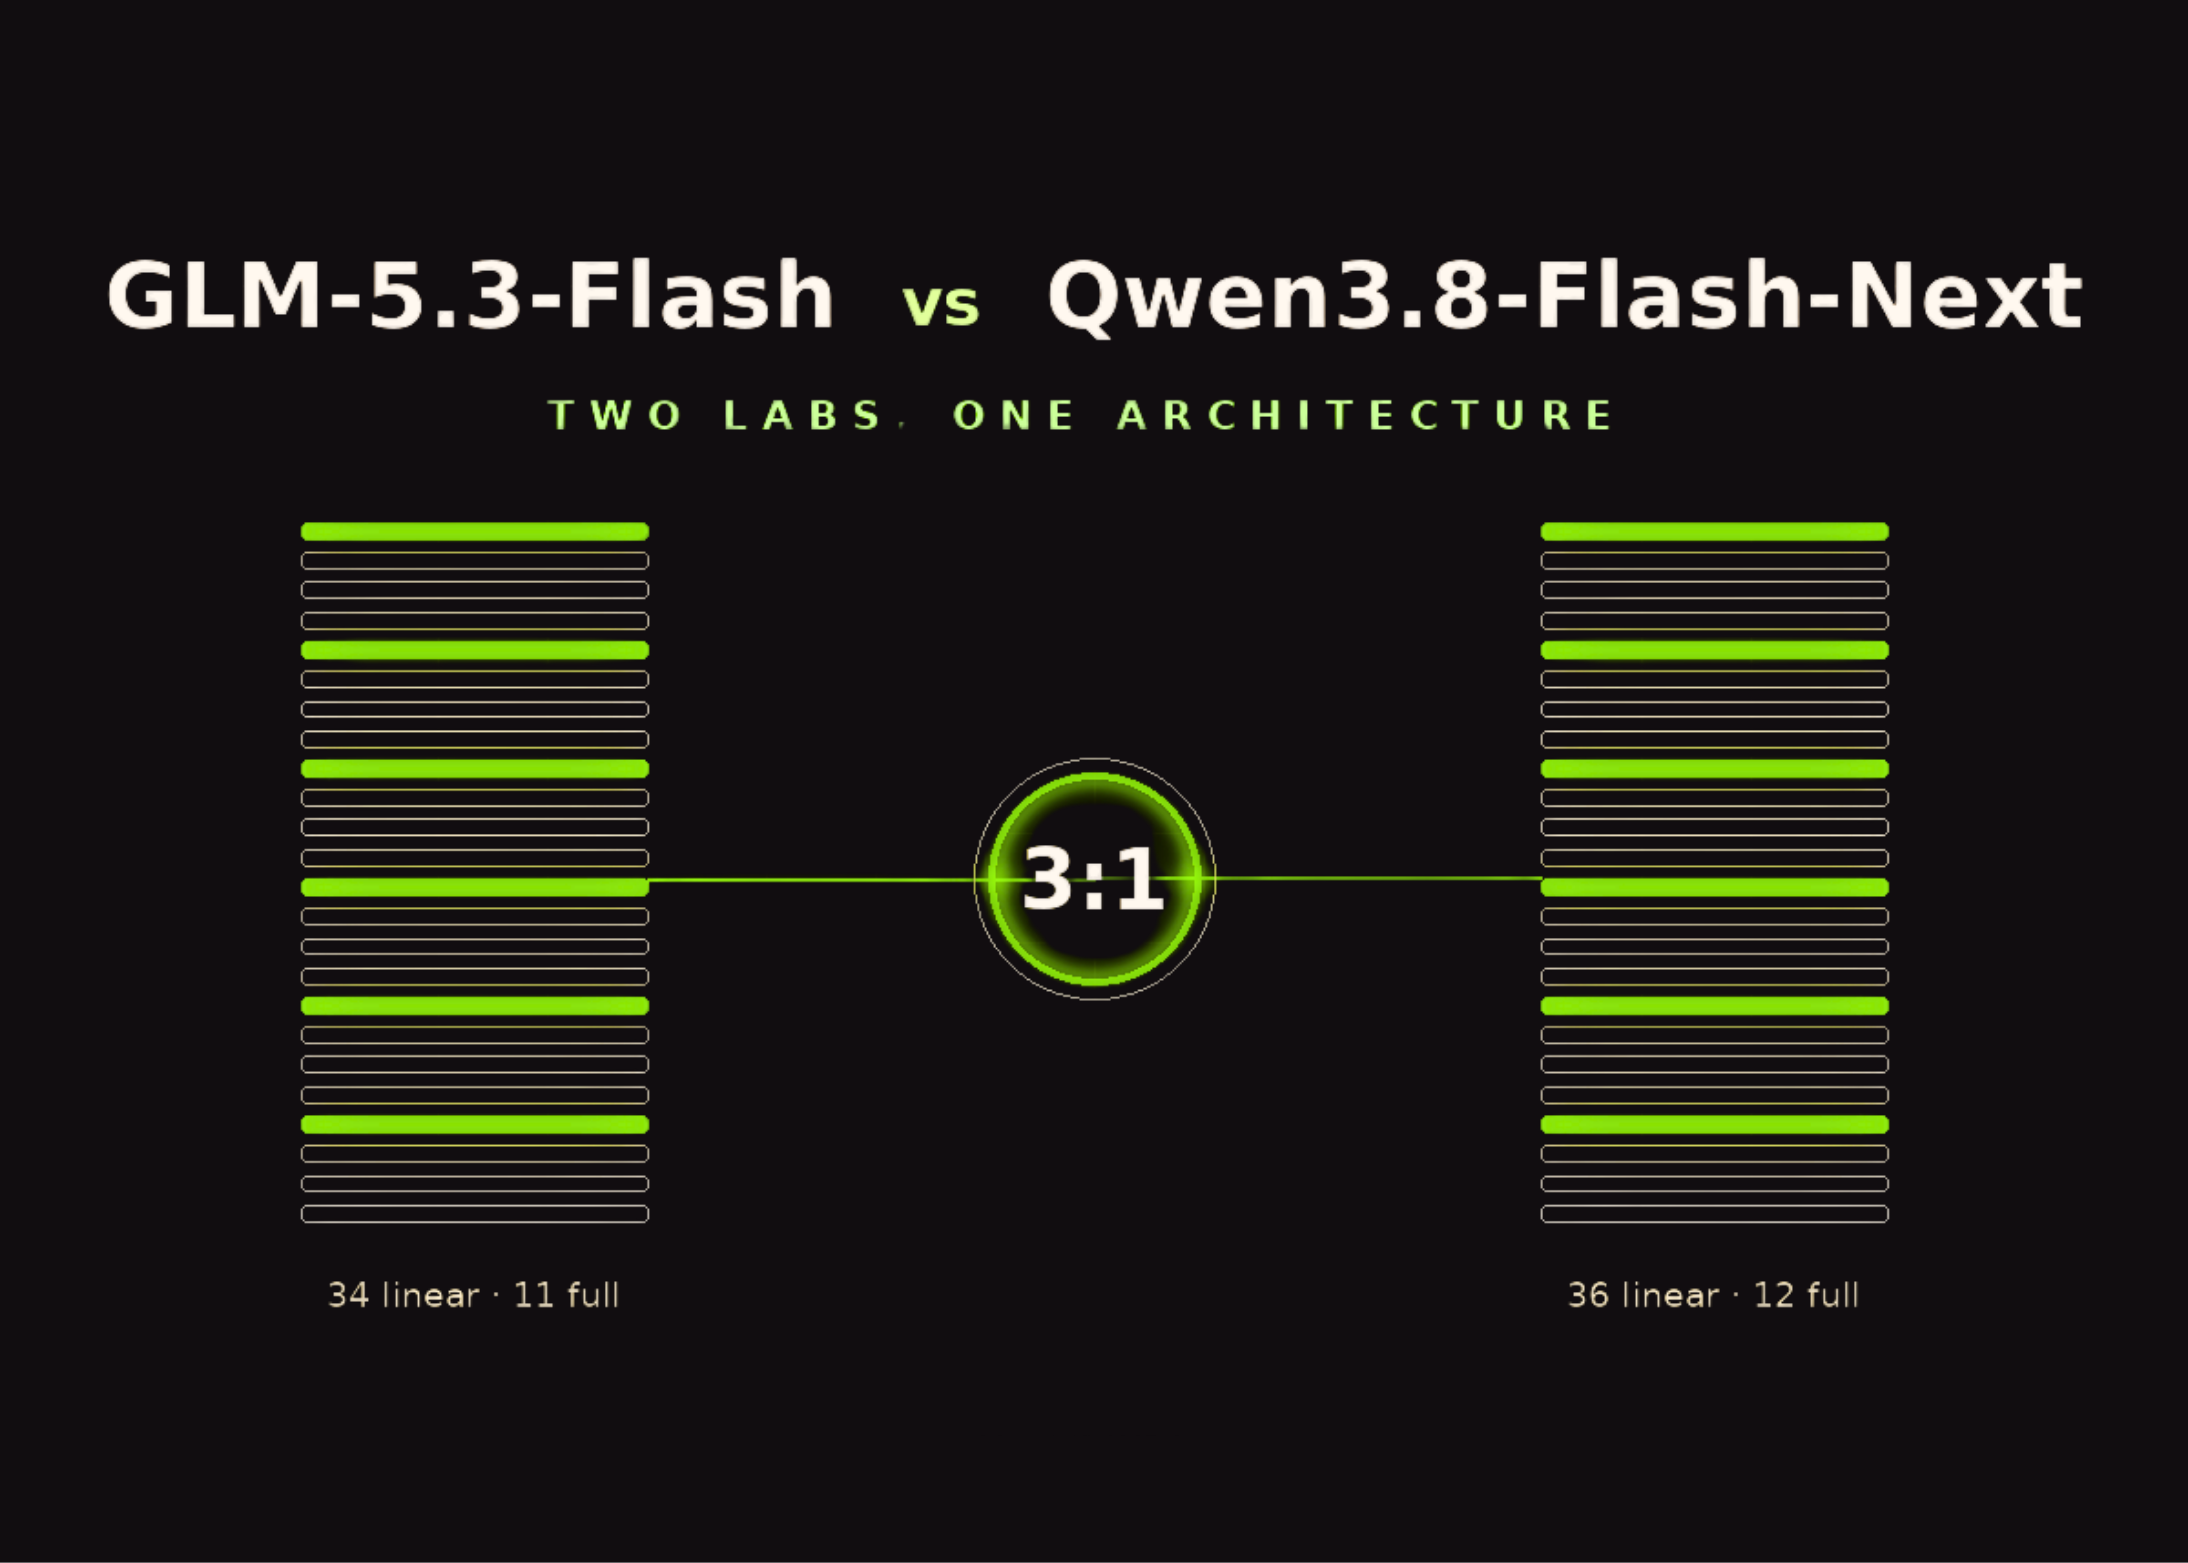
中国のAI開発チーム2社が、独立してほぼ同じ仕組みの新しいAIを発表。性能向上とコスト削減を両立し、今後のAI開発の方向性を示す重要な動きです。
今週、2つの最先端のオープンウェイトモデルが1日違いでリリースされました。Z.aiは、320B-parameterのマルチモーダルMoEモデルで18Bのアクティブパラメータを持つGLM-5.3-Flashをリリースしました。AlibabaのQwenチームは、Qwen4アーキテクチャのプレビューとなる、125Bモデルで6Bのアクティブパラメータを持つQwen3.8-Flash-Nextをリリースしました。これら2つのチームは、これらのシステムを独立して設計しました。しかし、それらの設定は互いにほぼコピーのように読めます。両方とも、線形とフルアテンションの3:1ハイブリッドを使用しています。両方とも、2048トークンに制限された圧縮インデクサーでコンテキストを選択します。両方とも、残差ストリームを4つのゲート付きブランチに広げます。両方とも、直交化の前に分割された結合パラメータ行列を持つMuonオプティマイザでトレーニングします。この記事では、共有されたレシピ、唯一の意見の相違点、そして異議を唱える1つのラボについて説明します。GLM-5.3-Flashは、GLM-5シリーズ初のネイティブマルチモーダルモデルであり、Hugging FaceでMITライセンスの下でリリースされました。Z.aiはOpenRouterでOx Alphaとして匿名でテストし、その週で最も人気のあるモデルとなりました。これは30T-tokenのマルチモーダルコーパスでトレーニングされ、1M-tokenのコンテキストウィンドウを提供します。Z.aiは、GLM-5.2をベンチマークで上回り、価格は10分の1でありながら、コーディングおよびエージェントベンチマークでClaude Opus 4.8に近づいていると述べています。リスト価格は、入力トークン100万あたり0.15ドル、出力トークン100万あたり0.50ドルです。Qwen3.8-Flash-Nextは、Qwen3-NextがQwen3.5に対して果たした役割、つまり次のアーキテクチャファミリーの早期公開プレビューの役割を担っています。モデルカードには、125Bのメインモデルと追加の51Bのn-gram embedding tableが記載されており、トークンあたり6Bのパラメータがアクティブ化されます。ネイティブコンテキストは262,144トークンで、YaRNを使用すると1Mに拡張可能です。Qwenチームは、トレーニングに必要な計算量がQwen3.7-Plusの約9分の1であったと報告しています。付随する技術レポートは「On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability」と題されています。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。