AIが複雑な情報を素早く整理
Knowledgator Releases GLiFormer: A 575M-Parameter Encoder That Hits 91.10 F1 on Nested JSON Extraction Without Generating Tokens
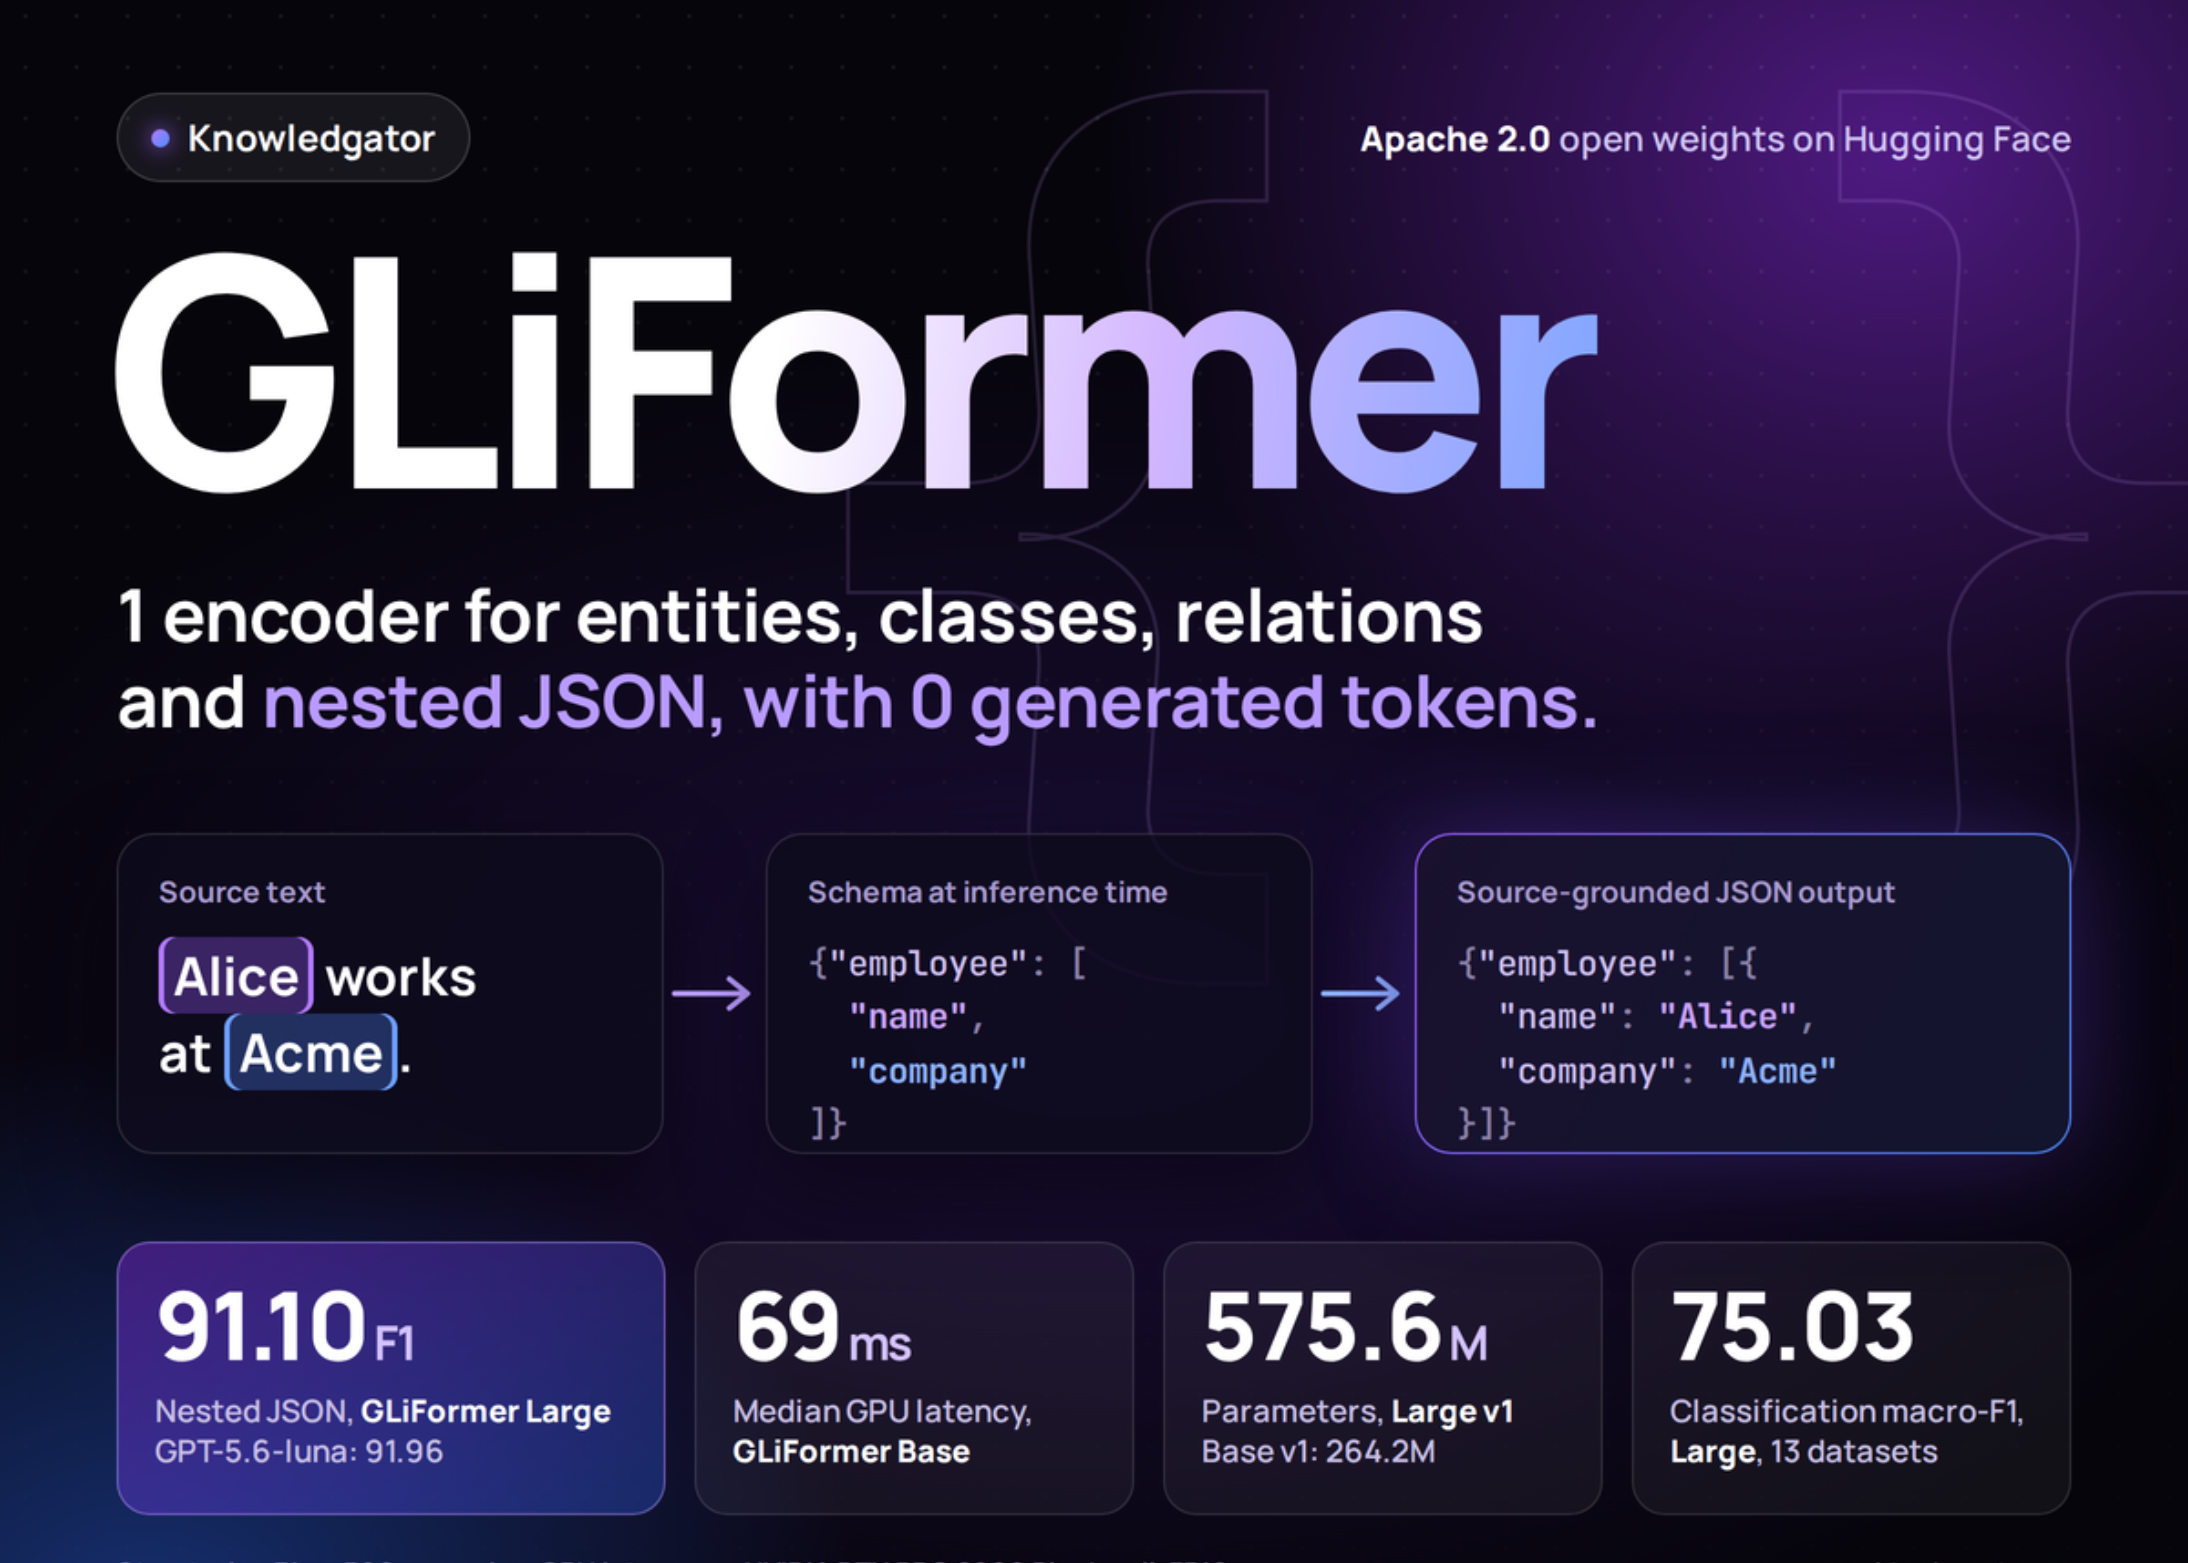
Knowledgatorが発表したGLiFormerは、情報を読み取るAIだけで複雑な情報を直接整理できる新しいAIです。これにより、AIが情報を生成する手間が省け、データ処理がより速く正確になります。
Knowledgator Engineeringは、情報抽出のためのスキーマ条件付きエンコーダーフレームワークであるGLiFormerをリリースしました。1つのモデルで、固有表現認識(NER)、テキスト分類、関係抽出、ネストされたJSON構造化、およびテキスト埋め込みを処理します。推論時にラベルと抽出スキーマを渡します。Hugging Faceには2つのチェックポイントがあります。GLiFormer Base v1は2億6420万パラメータ、GLiFormer Large v1は5億7560万パラメータです。本日中にデプロイ可能ですか?はい。両方のチェックポイントはApache 2.0で、pip install gliformerでインストールでき、CPUまたはGPUで動作します。 認識できる問題点 情報抽出のスタックでは、多くの場合、別々のモデルが連結されています。1つはエンティティをタグ付けし、別のモデルはドキュメントを分類し、3つ目のモデルがレコードを再構築します。研究チームは、これらのタスクが1つのコア操作を共有していると主張しています。ソースをエンコードし、要求された概念を表現し、それらの互換性をスコア付けすることです。LLMはネストされたJSONを出力できますが、フィールド名、句読点、および値をトークンごとに生成します。GLiFormerは、そのパスから出力生成を削除します。 GLiFormerの仕組み GLiFormerはGLiNERをベースにしており、「アンカー」を介してラベルマッチングを一般化しています。アンカーとは、各ランタイムラベルがスコア付けされるオブジェクトです。分類のためのグループベクトル、関係のためのエンティティペア、またはレコードスロットになり得ます。ソースは一度エンコードされます。同じドキュメントに対する複数のスキーマは、その共有されたエンコーディング上でタスクローカルグループとして実行されます。ヘッドの計算は、グループ、ラベル、アンカーの数とともに増加します。NERの場合、ヘッドはすべてのトークンとラベルのペアについて、開始、終了、および内部の証拠をスコア付けします。独立したシグモイド出力により、ネストされたメンションと共有された境界が共存できます。構造化は4つのステージで実行されます。フィールド値をソーステキストから直接取得したスパンとしてグラウンド化します。ハンガリアンマッチングでトレーニングされた順序なしのレコードスロットにスパンを割り当てます。スキーマが許可するパスに制限された、指向性のある親子リンクを予測します。決定論的デコーダーでネストされたJSONを組み立てます。値はソーススパンであるため、モデルはソースにない値のテキストを発明することはできません。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。