Google、AI検索を高速化する新技術
Google Research Introduces Retrieve-for-Train (R4T): An RL-Compiled Diffusion Retriever for 12× to 20× Faster Query Fan-Out
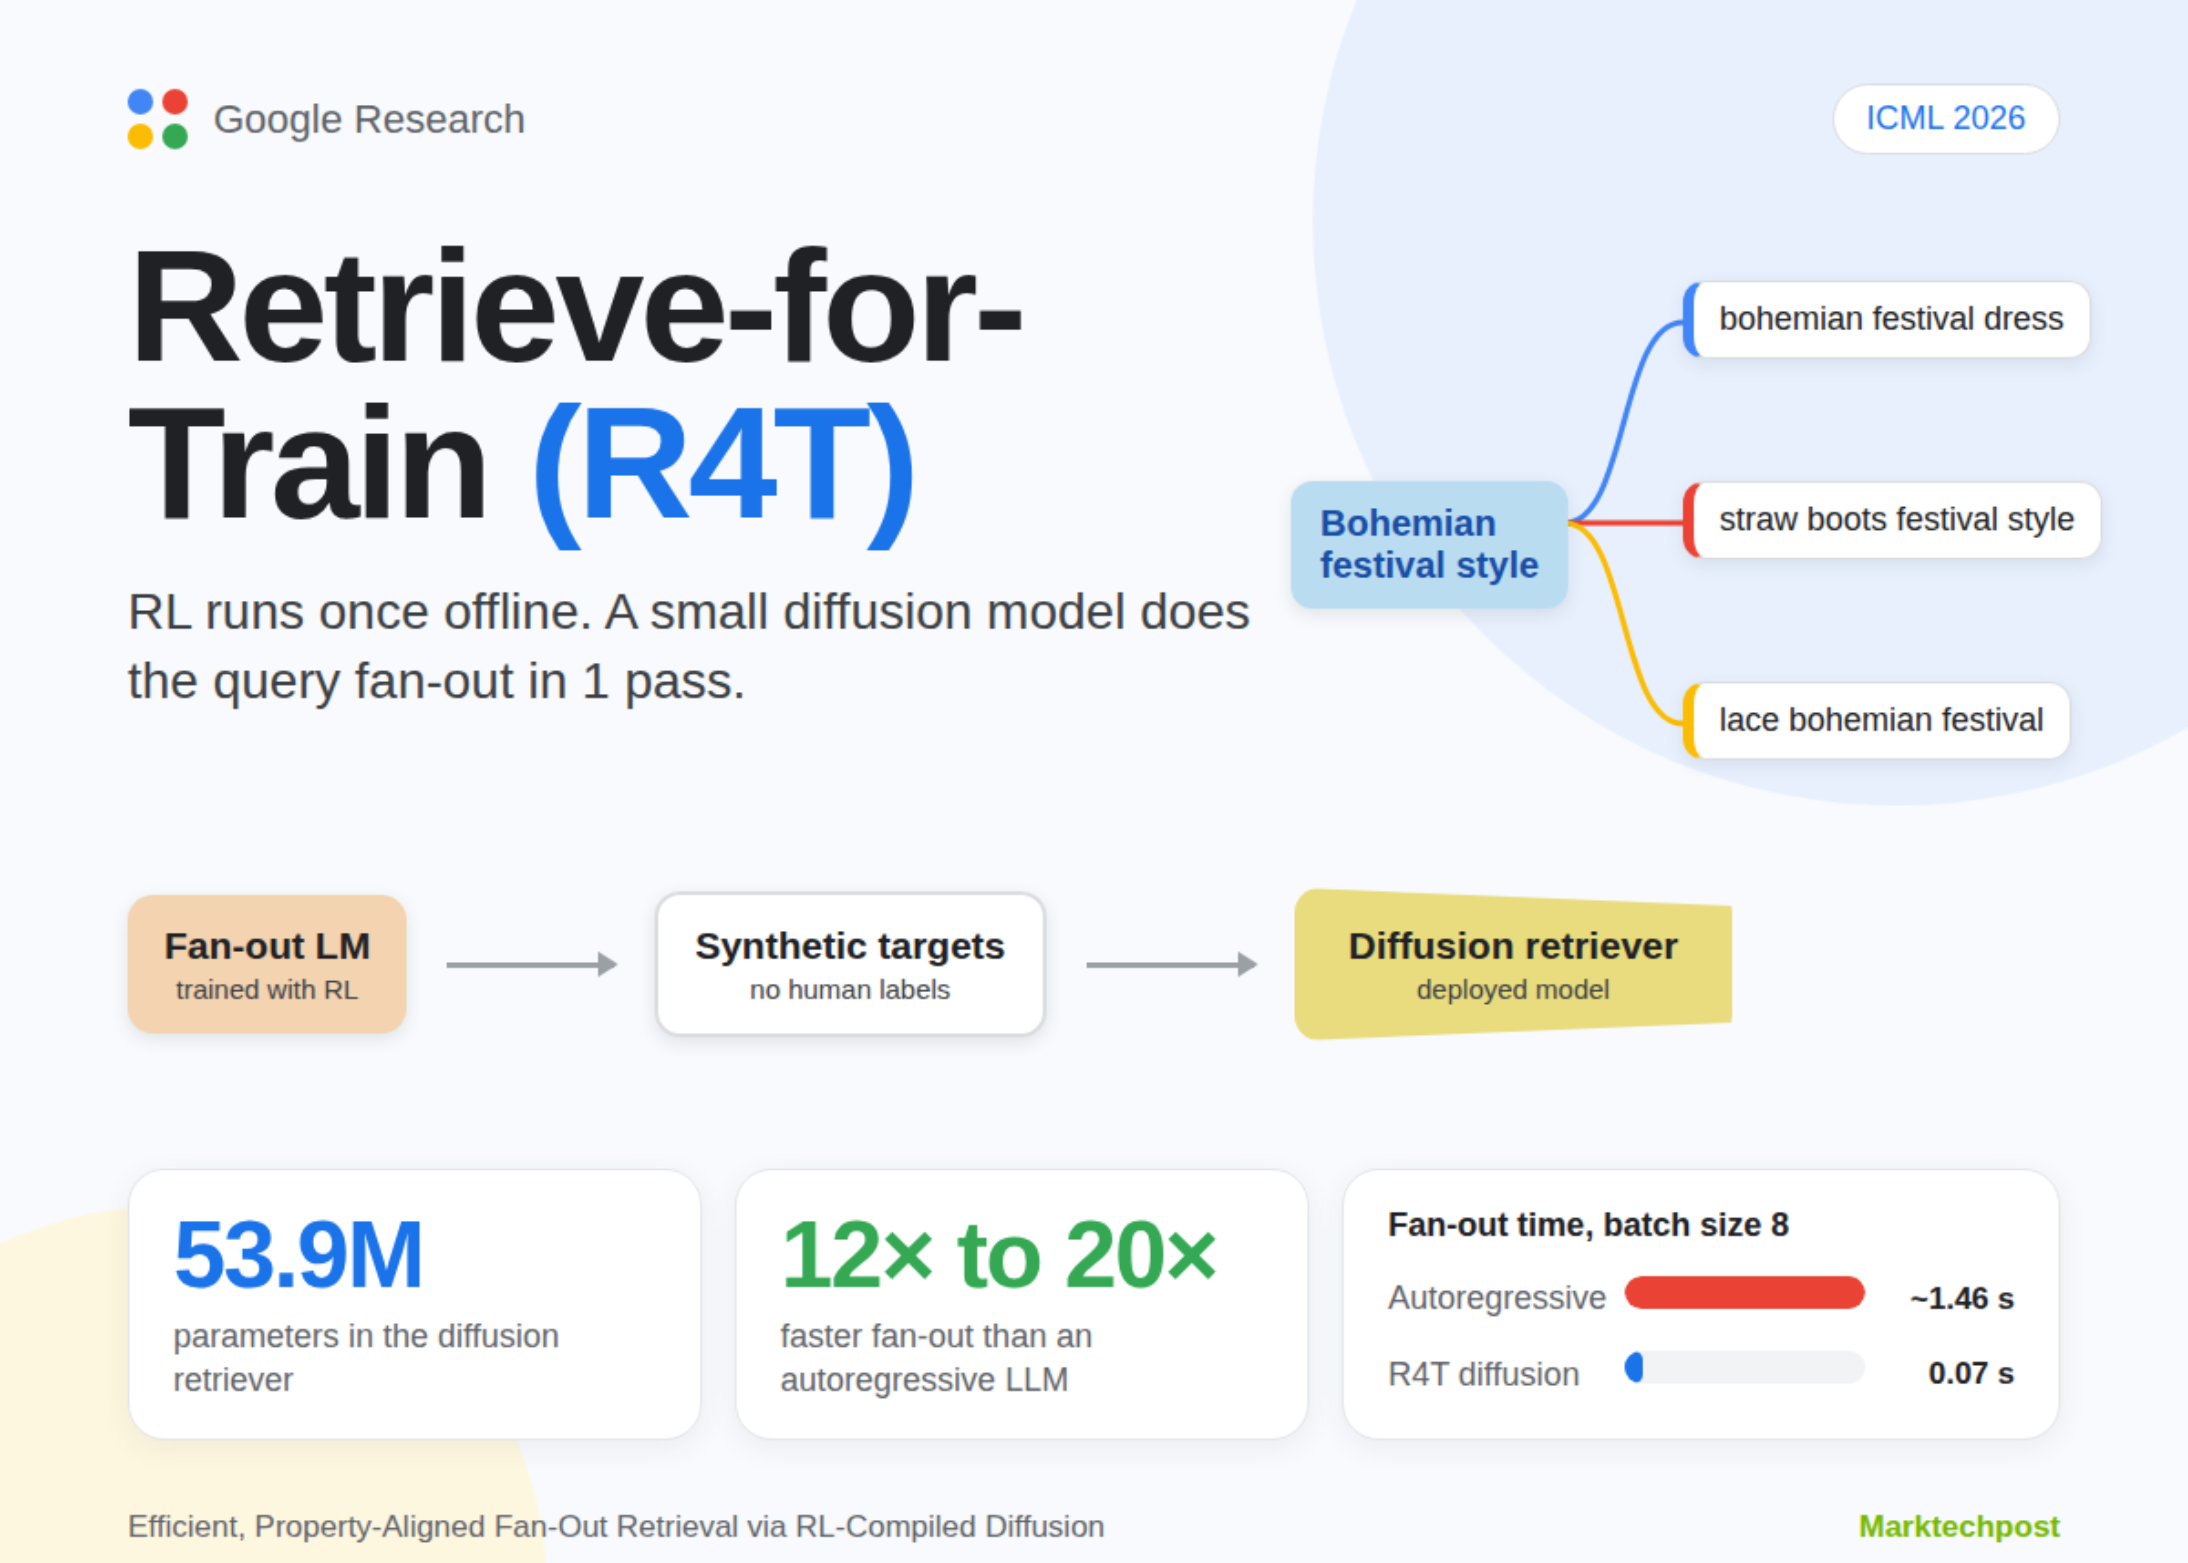
Googleの研究チームが、多様な検索結果を素早く表示する新技術R4Tを発表。これにより、AIが考える検索の幅出しが最大20倍速くなり、ユーザーはより多くの選択肢を得られます。
検索システムやレコメンデーションシステムは、単一の最適な一致ではなく、一連の結果を返す必要性が高まっています。「キャンプ用品」のようなクエリは、テント、寝袋、ストーブ、ヘッドランプを返す必要があります。ほぼ同じテントを10個返すべきではありません。Google Researchは、この問題のためにRetrieve-for-Train (R4T)を導入しました。このフレームワークは、一度だけオフラインで強化学習 (RL) を使用して、適切なクエリのファンアウトを学習します。その後、その動作を小さなdiffusion modelに蒸留し、1回のパスですべての検索方向を生成します。 標準的なファンアウトが不十分な理由 クエリのファンアウトは、1つの広範なプロンプトを複数のサブクエリに分割します。研究チームは、汎用的なLLMが推論時にこれを行う際に2つの問題を特定しています。1つ目は「paraphrastic collapse」です。「Bohemian festival style」の場合、zero-shot Qwen3-4Bは「bohemian festival fashion」と「festival bohemian clothes」を生成しました。これらのほぼ同義語は、均質な結果のセットを検索します。2つ目は「latency」です。自己回帰的な生成と繰り返しの検索呼び出しは遅いです。Best-of-Nサンプリングは品質を向上させますが、推論コストを増加させます。 3段階のR4Tパイプライン ファンアウトLMトレーニング: ファンアウト言語モデル (FOLM) がk個のサブクエリを生成します。凍結されたdense retrieverがそれらを実行します。セットレベルの報酬が、個々のアイテムではなく、検索されたセット全体を評価します。 教師データ合成: 訓練されたFOLMは、温度0.9でクエリごとに128個のファンアウトをサンプリングします。これらは、人間のラベルなしで(クエリ、ターゲットセット)の訓練ペアになります。オープンエンドのタスクの場合、ターゲットは検索されたコンテンツのembeddingです。構成的なタスクの場合、ターゲットはサブクエリのembeddingです。 Diffusive retrieverトレーニング: 53.9Mパラメータのdiffusion transformerが、クエリのembeddingをターゲットembeddingの完全なセットにマッピングすることを学習します。EDM framework内でvariance-exploding formulationを使用します。推論時には、単一の非自己回帰パスですべてのembeddingを生成します。その後、最近傍探索が各embeddingをデータベースアイテムにマッピングします。 報酬設計と報酬ハッキング オープンエ
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。