NVIDIA、8人話者を特定するAI公開
NVIDIA Releases Nemotron 3 Diarization: A 100M-Parameter Open-Weight Model That Tracks 8 Speakers in Real Time
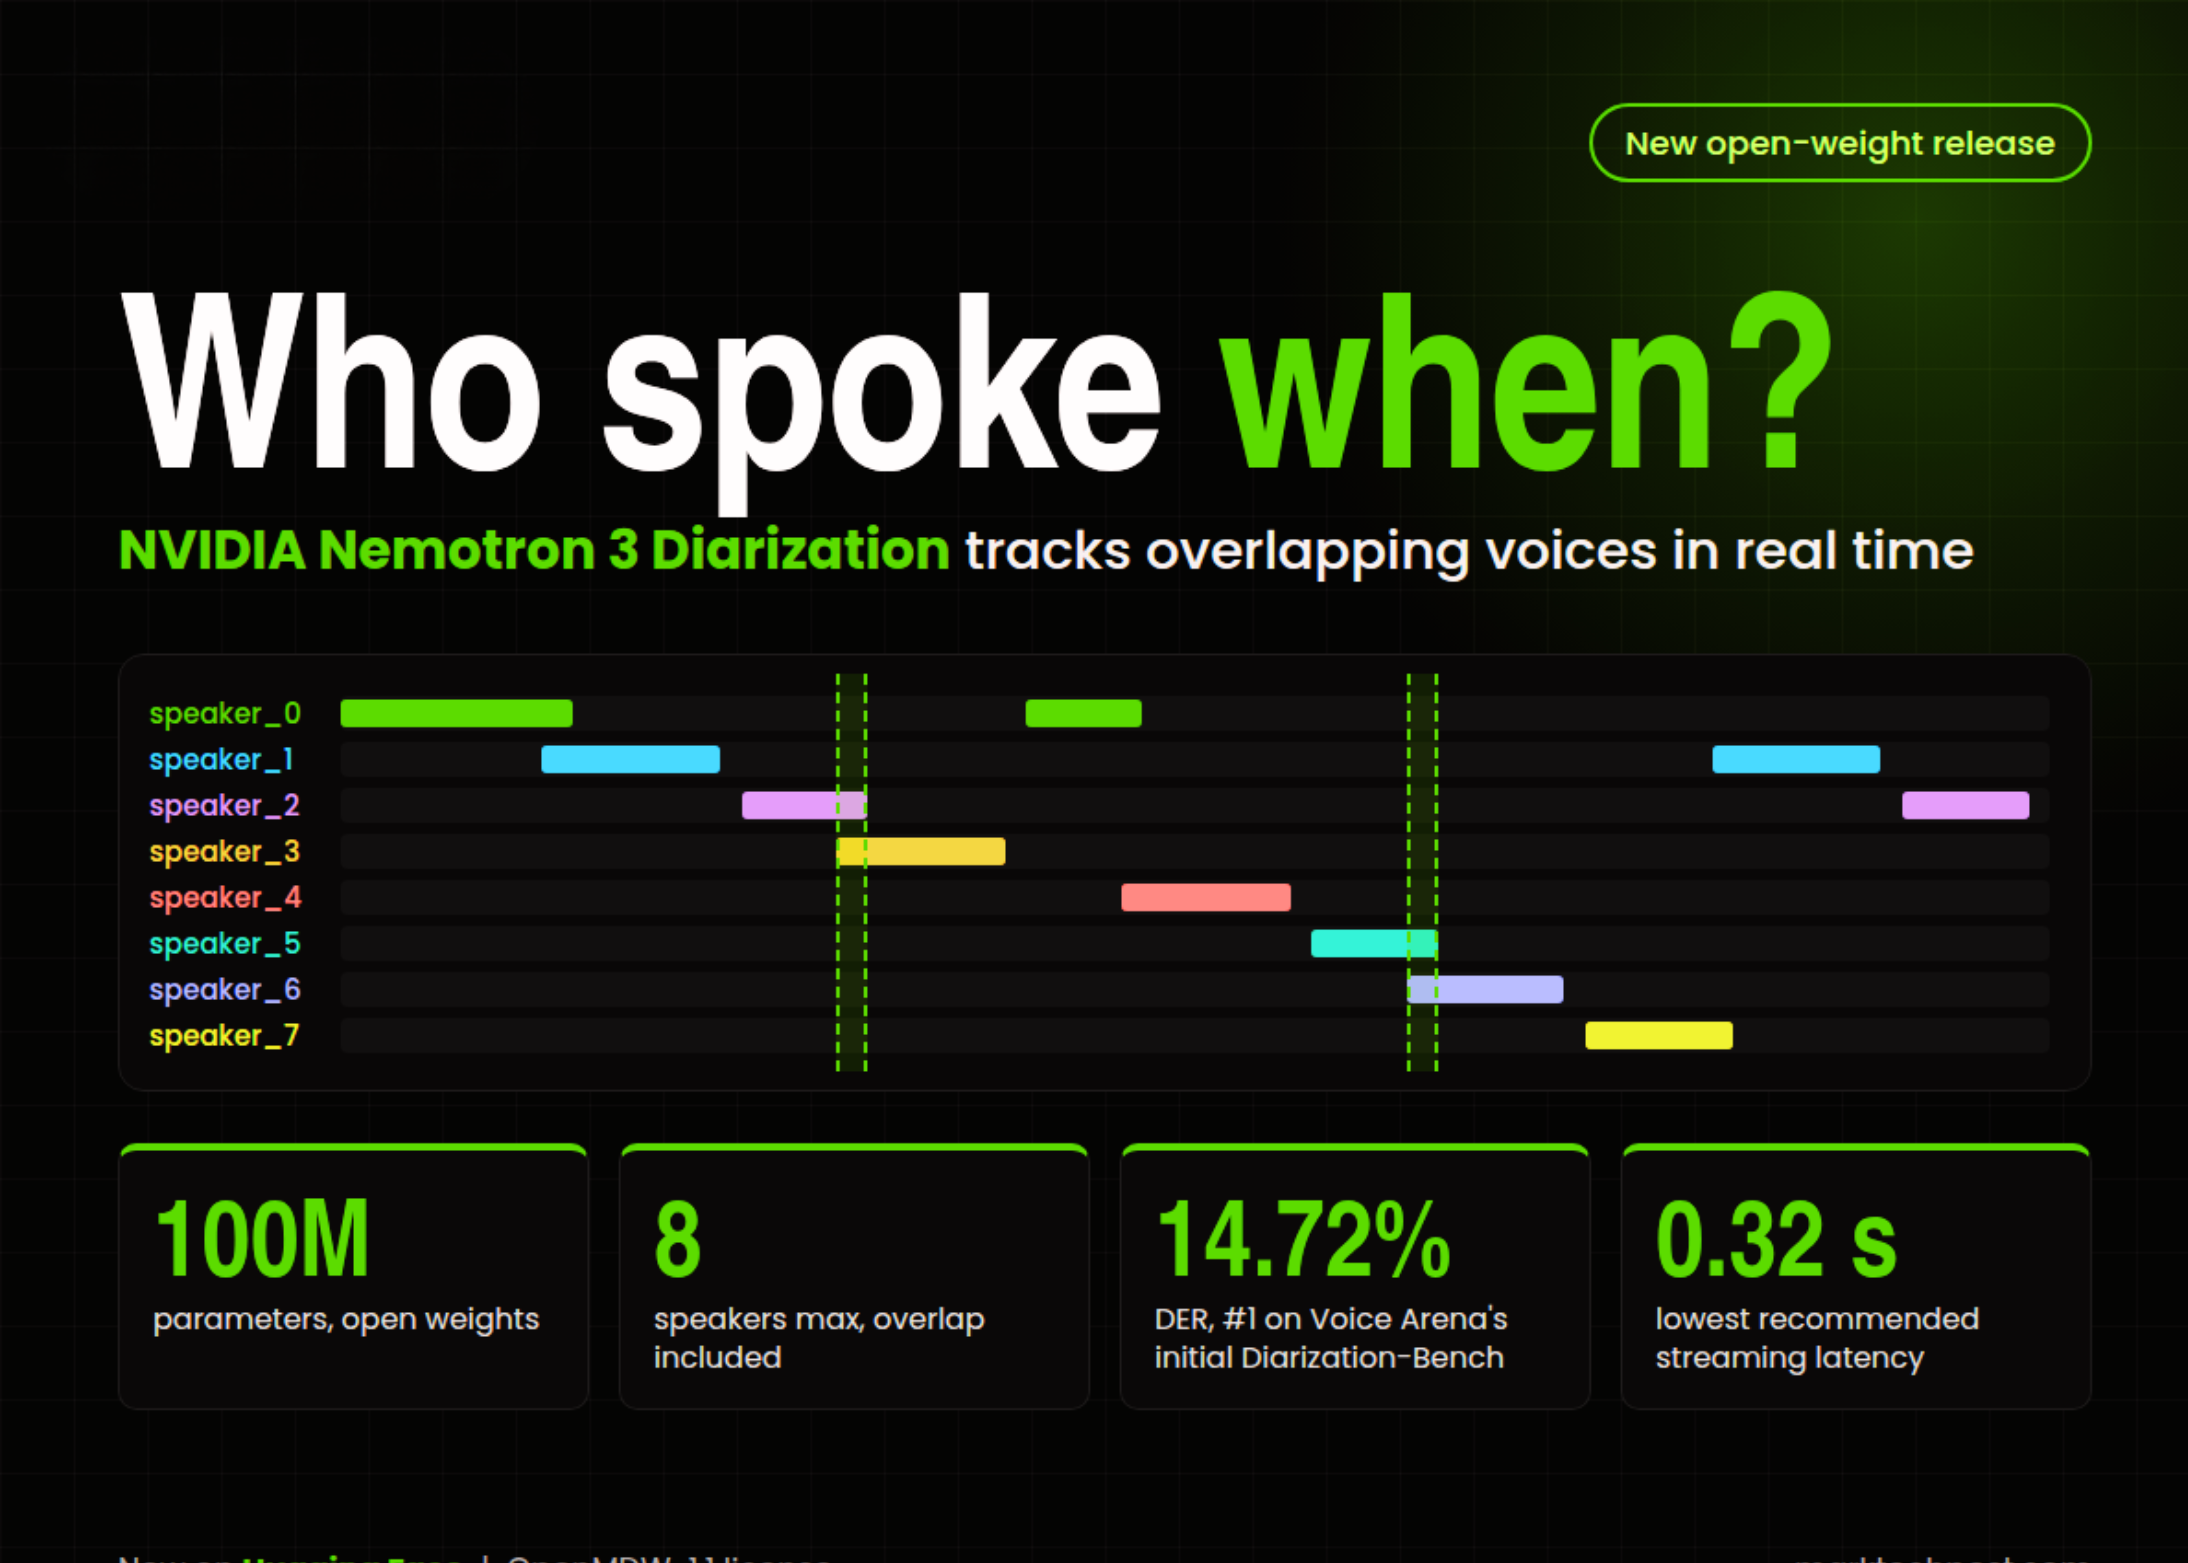
NVIDIAが最大8人の話者を特定できるAIを公開。会議の議事録や音声分析の精度が大幅に向上し、ビジネス活用が期待されます。
NVIDIAは、Hugging Faceでオープンウェイトのspeaker diarizationモデルであるNemotron 3 Diarizationをリリースしました。これは、あらゆる会話について「誰がいつ話したか」という問いに答えます。1億パラメータのこのモデルは、声が重なる場合でも最大8人の話者を追跡します。1つのチェックポイントで、オフラインの録音とリアルタイムのストリーミングの両方に対応します。展開可能でしょうか?はい。ウェイトはOpenMDW License 1.1の下でリリースされており、商用利用が可能です。NVIDIA NeMoを通じてLinux上で動作し、Ampere、Ada Lovelace、Hopper、またはBlackwell GPUを使用します。なぜSpeaker Diarizationは必要なのでしょうか?自動音声認識(ASR)は言葉を提供しますが、誰がそれを言ったかは教えてくれません。発言者が特定できないと、要約ツールは誰が約束をしたのか、誰が異議を唱えたのかを判別できません。Diarizationは、各話者が活動している時間間隔を出力します。これらのタイムスタンプはASR出力と組み合わされ、発言者属性付きの文字起こしを生成します。会議ツール、通話分析、ポッドキャストのパイプライン、音声エージェントのメモリはすべてこのステップに依存しています。Streaming Sortformerから何が変わったのか?NVIDIAの以前のStreaming Sortformerチェックポイントであるdiar_streaming_sortformer_4spk-v2.1は、4人の話者をサポートしていました。Nemotron 3 Diarizationはその制限を8人に倍増させます。NVIDIAの発表によると、ターゲットは人々が同時に話すような、乱雑な複数人音声です。アーキテクチャの仕組み このモデルは、.wav、.flac、.opus、または.mp3形式の16 kHz、シングルチャンネルオーディオを受け入れます。オーディオを10ミリ秒のステップでMel-spectrogram特徴量に変換します。特徴量は8倍にスタックされ、80ミリ秒のエンコーダフレームを生成します。rotary positional embeddings(RoPE)を備えた31層のTransformerエンコーダがこれらのフレームを処理します。その後、Conv1Dレイヤーが予測を10ミリ秒の解像度に戻してアップサンプリングします。出力は、話者ごとの活動確率を示す[T, 8]テンソルです。この設計は、重なりを直接処理します。2人が同時に話す場合、同じフレームで2つのチャネルがアクティブになります。このモデルは、Sortformerのアプローチに従い、話者を到着時間順に並べます。最初の
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。