AIの目で見る能力を測る方法
Evaluating Multimodal Vision Models with Moonshot PerceptionBench Using Robust Data Loading and Automated Judging
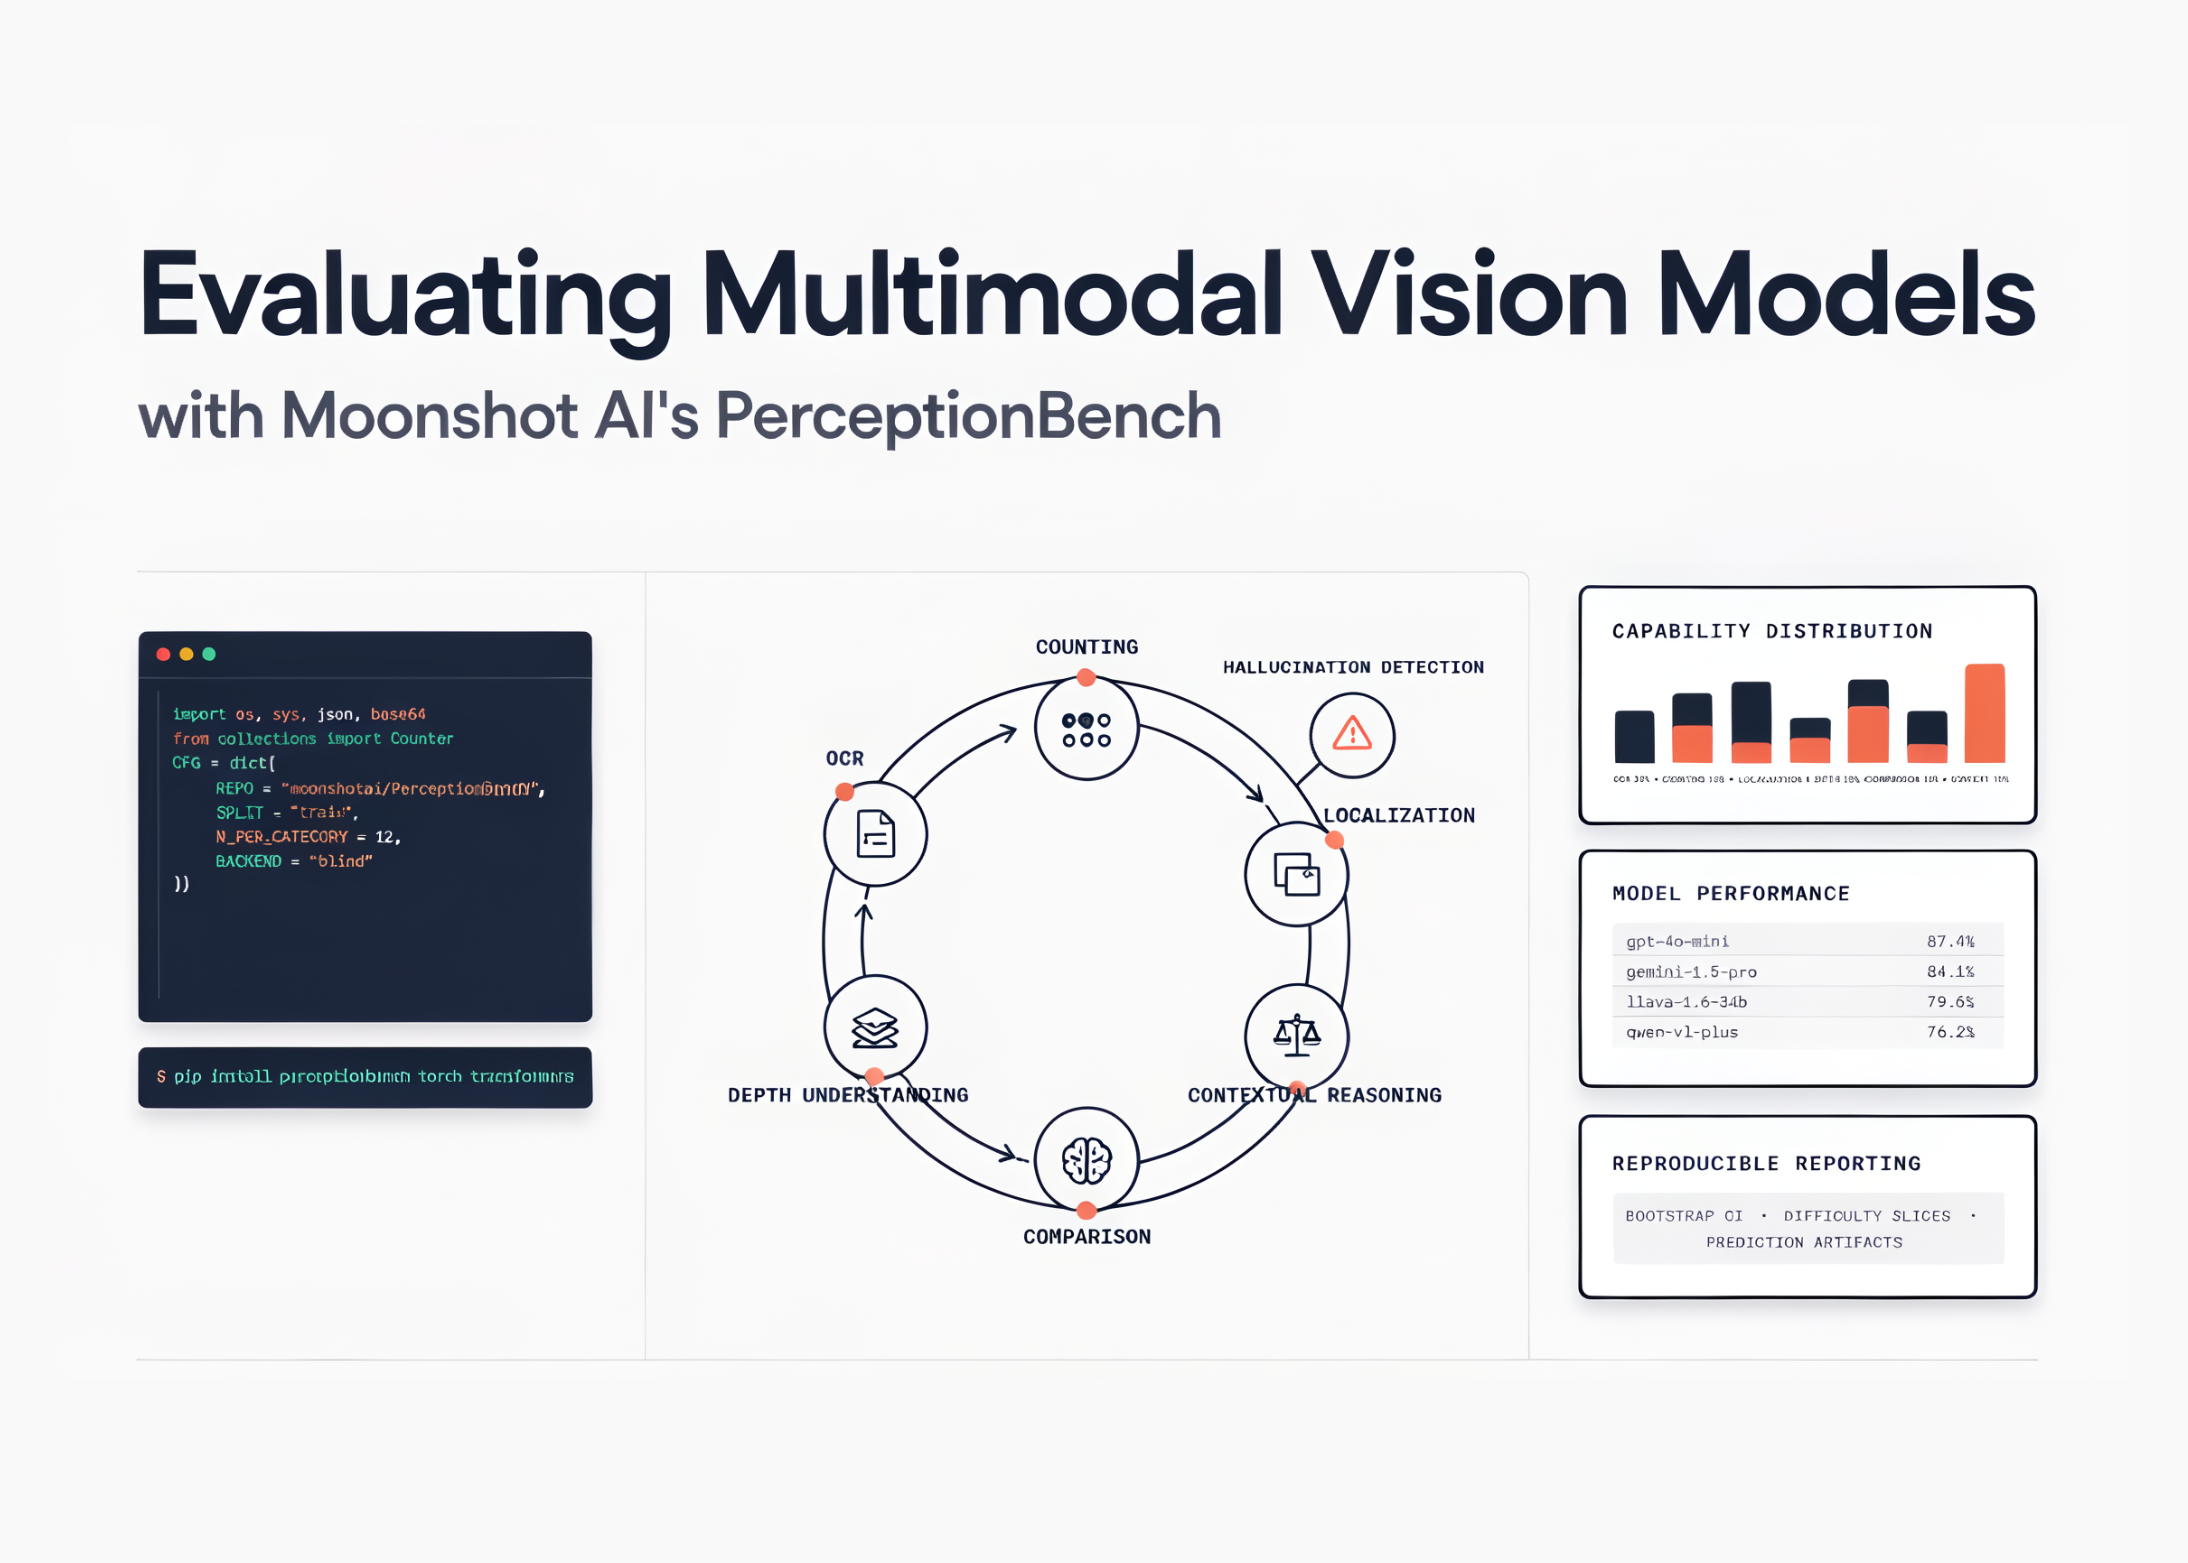
AIが画像や文字を理解する能力を測る新しい評価方法が公開されました。これにより、AIの目で見る能力を細かく分析し、モデル間の比較や改善に役立ちます。
このチュートリアルでは、PerceptionBenchのためのエンドツーエンドの評価ワークフローを設計します。このマルチモーダルベンチマークは、OCR、カウント、ローカライゼーション、文脈推論、比較、深度理解、幻覚検出といったタスクにおいて、きめ細やかな視覚認識能力を測定します。私たちはまず、Colab互換の環境を設定し、必要なライブラリをインストールし、堅牢な多段階ストリーミングおよびダウンロード戦略を通じて、データセットのバランスの取れたサブセットをロードします。次に、base64でエンコードされた画像をデコードし、インターリーブされた画像プレースホルダーを解析し、各例を一貫したレコード形式に正規化し、データセットの能力分布、画像要件、回答タイプ、およびソースベンチマークを分析します。そこから、ブラインド事前ベースライン、OpenAI互換のマルチモーダルAPI、およびローカルのHugging Face vision-language modelsをサポートする統合評価ハーネスを構築します。また、ルールベースおよびオプションのLLM-assisted judgingを実装し、ブートストラップ信頼区間を計算し、難易度スライスごとのパフォーマンスを調査し、含まれているリーダーボードと能力プロファイルを比較し、再現可能な予測およびレポート成果物をエクスポートします。Copy Code Copied Use a different Browser import os, sys, io, re, json, time, math, base64, random, hashlib, subprocess, warnings from collections import Counter, defaultdict from concurrent.futures import ThreadPoolExecutor, as_completed warnings.filterwarnings("ignore") CFG = dict( REPO = "moonshotai/PerceptionBench", SPLIT = "train", N_PER_CATEGORY = 12, MAX_SCAN = 1200, SEED = 0, LOAD_MODE = "stream", BACKEND = "blind", API_BASE = os.environ.get("PB_API_BASE", "https://api.openai.com/v1"), API_KEY = os.environ.get("PB_API_KEY", ""), API_MODEL = os.environ.get("PB_API_MODEL", "gpt-4o-mini"), API_WORKERS = 4, API_MAX_TOKENS = 512, LOCAL_MODEL = "HuggingFaceTB/SmolVLM2-2.2B-Instruct", LOCAL_MAX_NEW = 128, MAX_IMAGE_SIDE = 1024, JPEG_QUALITY = 90, JUDGE = "rule", NUM_REL_TOL = 0.0, OUT_DIR = "/content/percepti"
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。