PerplexityがAIの失敗から学ぶ
Perplexity Trains Its Computer Agent on Real Mistakes With Hint-Guided Self-Distillation
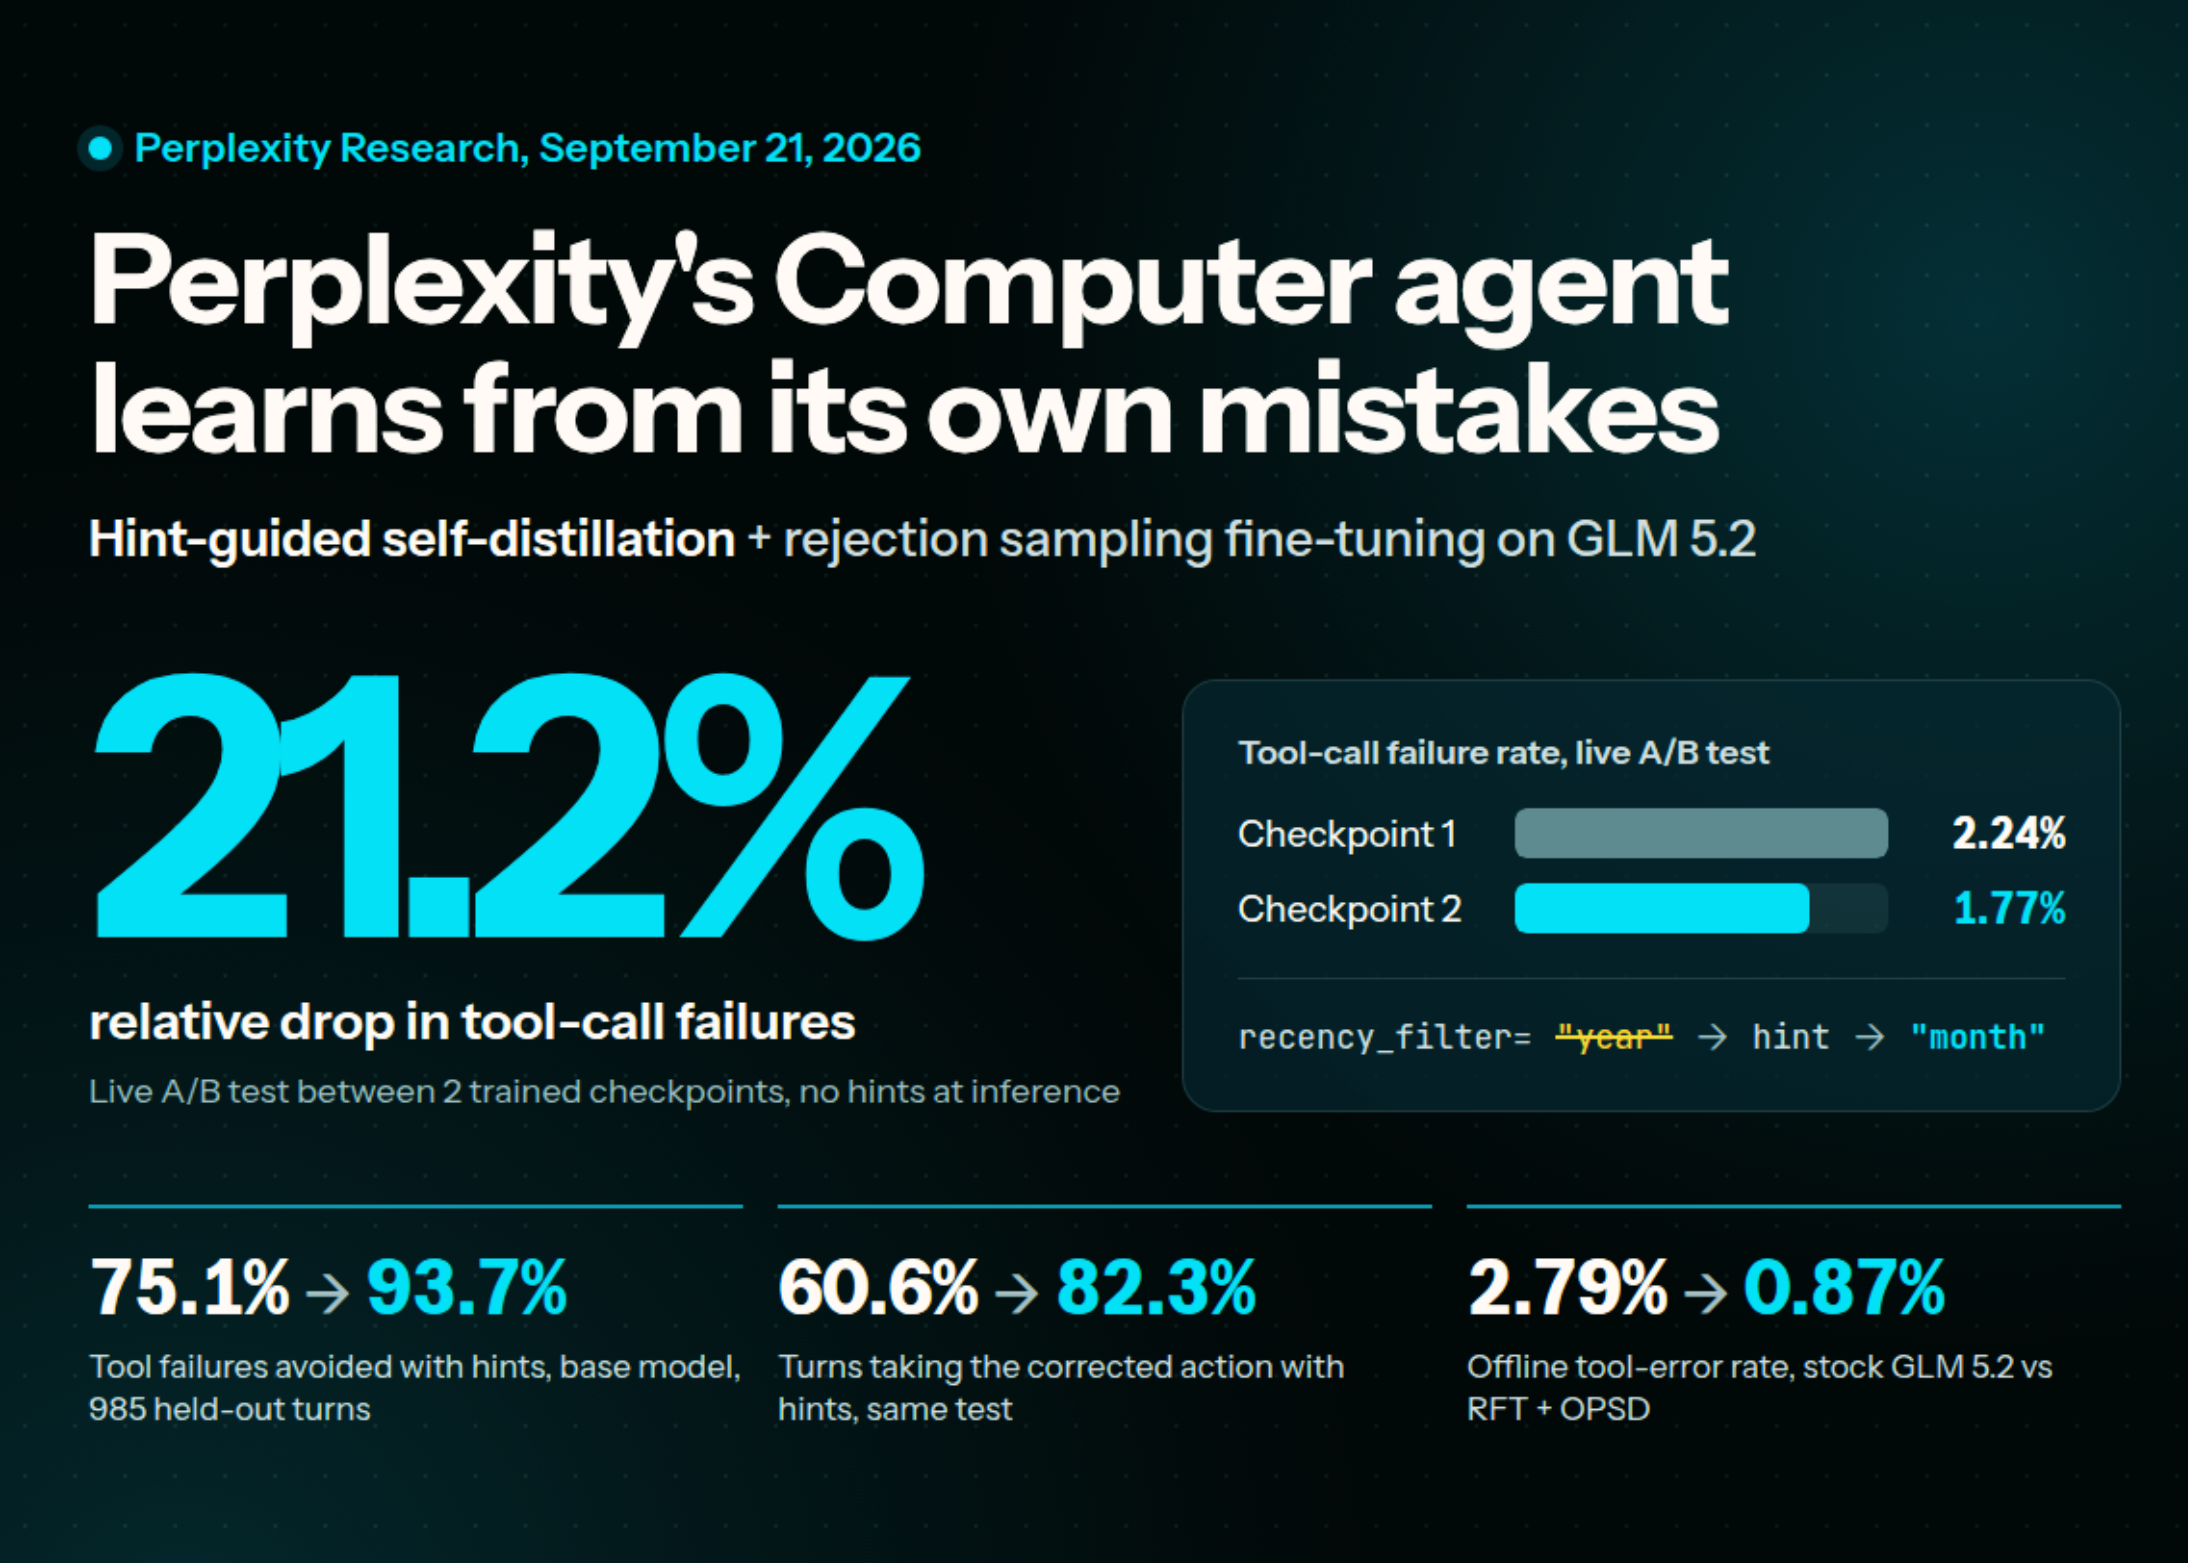
Perplexityは、AIアシスタントが実際の失敗から学び、間違いを修正する新学習法を開発。これにより、AIがツールを使う際の失敗が21.2%減り、より信頼性の高い応答が期待されます。
Perplexity Researchは、新しいpost-trainingに関する研究を発表しました。これは、失敗したセッションを含む実際のユーザーセッションで、Perplexity Computer内のモデルを訓練するものです。この手法は、rejection sampling fine-tuningとhint-guided self-distillationを組み合わせています。ライブA/Bテストでは、2つの訓練済みチェックポイント間で、ツール呼び出しの失敗が2.24%から1.77%に減少しました。Perplexityチームはこれを統計的に有意な21.2%の相対的な削減として報告しています。これは直接展開可能でしょうか?いいえ、直接はできません。Perplexityはpost-trained weightsやtraining codeを公開していません。このモデルはPerplexity Computer内のモデルオプションとしてのみ動作します。ベースモデルであるGLM 5.2はHugging Faceで公開されています。結果のみのフィルタリングが不十分な理由標準的なrejection sampling fine-tuning (RFT)は、各セッションを評価し、成功したものだけを模倣します。しかし、成功した結果が得られたからといって、すべてのステップが正しかったわけではありません。エージェントは誤ったツール呼び出しから回復し、正しい答えを出すことができます。その完全な軌跡を模倣することは、エラーを強化してしまう可能性があります。また、失敗したセッションを破棄することは、回避可能な間違いの明確な証拠を捨ててしまうことにもなります。模倣、修正、またはコンテキストとして保持Perplexityチームは2つの決定を分けています。模倣する価値のある行動を含むセッションと、修正する価値のある間違いを含むターンです。各アシスタントのターンは、以下の3つの処理のいずれかを受けます。模倣 (Imitate): 成功したセッション内のエラーでないターンは、cross-entropy (CE) lossを受け取ります。修正 (Correct): 検証済みのヒントを伴うエラーターンは、どのセッションであってもKullback-Leibler (KL) divergence lossを受け取ります。コンテキストとして保持 (Keep as context): 残りのターンは入力内に残りますが、lossは受け取りません。成功したセッションは、模倣と修正の両方のターゲットを提供できます。失敗したセッションは、修正ターゲットのみを提供します。ヒントが訓練シグナルになる方法ヒントとは、モデルがすでに持っていた情報に基づいた短い修正指示です。ある例では、検索呼び出しがrecency_filterを「year」に設定しました。しかし、スキーマでは「day」、「week」、または「month」のみが許可されていました。ヒントは失敗した呼び出しを特定し、有効な
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。