画像AIが最大3倍速く動く新技術
Liquid AI Releases LFM2.5-VL-3B-DSpark: Speculative Decoding for Vision-Language Models With Up to 3.13x Faster Decoding
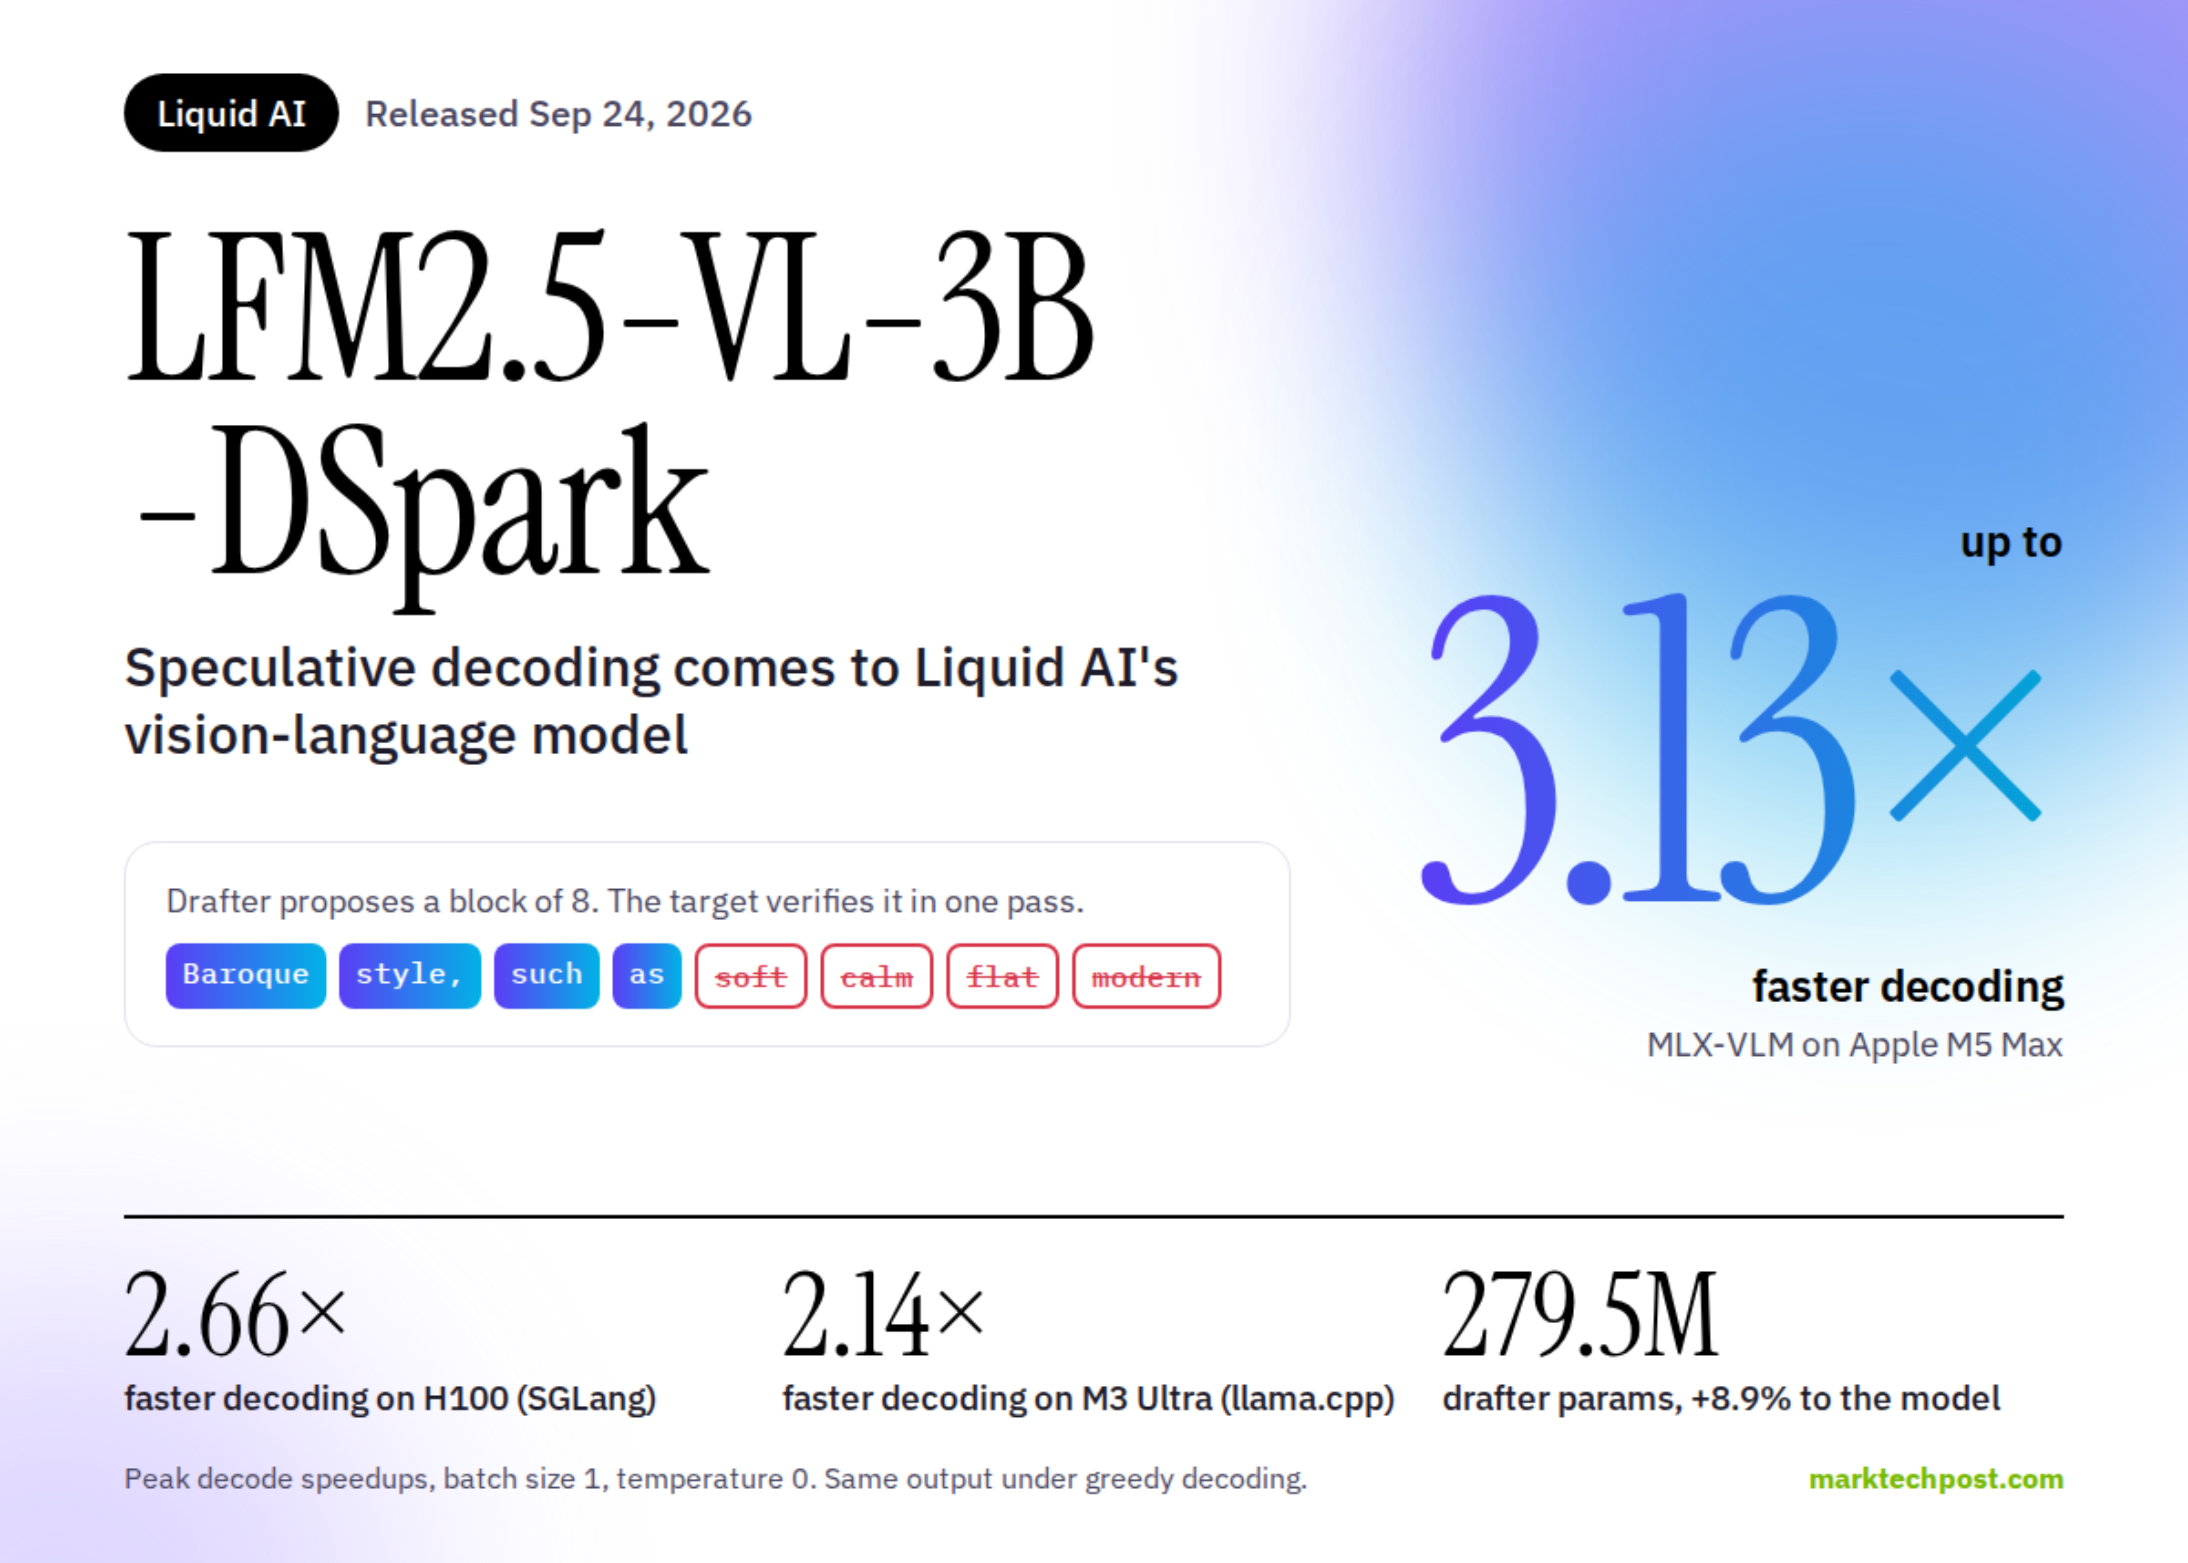
Liquid AIが、画像も扱えるAI(Vision-Language Model)の処理速度を最大3.13倍に高速化する新技術「DSpark」を発表しました。これにより、AIの応答がより速くなり、利用体験が向上します。
Liquid AIは、同社のVision-Language ModelであるLFM2.5-VL-3B向けの実験的なspeculative-decodingドラフトモデル、LFM2.5-VL-3B-DSparkを発表しました。このドラフターは約2.8億のパラメータを追加し、モデルの出力は変えずにdecodingを高速化します。Liquid AIチームは、Apple siliconで最大3.13倍、NVIDIA H100で最大2.66倍の高速なdecodingを報告しています。展開可能か?はい、WeightsはHugging FaceでSafetensorsとGGUF形式で公開されており、SGLang、MLX-VLM、llama.cppで初日からサポートされています。Liquid AIチームはこのリリースを実験的と位置付けており、年間売上1000万ドル未満の企業のみに無料の商用利用を許可するLFM Open License v1.0の下で提供されます。 どのようなSpeculative DecodingがVLMを変えるのか 標準的なモデルは、1回のforward passで1つのtokenを生成します。Speculative decodingは、数個先のtokenを提案する小さなdrafterを追加します。その後、大きなターゲットモデルがブロック全体を1回のpassでチェックし、合意したtokenを保持します。DSparkは、DSpark論文で説明されているLiquid AIのtext-model DSpark draftersのレシピに従っています。drafterは、ターゲットモデルのいくつかの層からのhidden statesを読み取り、次のk個のtokenを予測します。重要な設計ポイントは、drafterにとってmodalityが問題ではないことです。tokenがhidden layersに到達するまでに、テキストと画像のパッチはどちらも単なるtensorになります。そのため、Liquid AIチームはVision-Language Modelにまったく同じinferenceアルゴリズムを再利用しています。 Drafterのアーキテクチャとトレーニング Drafterは、簡略化されたattention-onlyモデルです。Ablationsにより、4層とブロックサイズ9が選択されました。Liquid AIは、ハードウェアに応じてinference時にブロックサイズ8または9を推奨しています。Apple siliconでの実行には8が使用されます。 コンポーネント パラメータ Decoder stack (4 layers) 193.0M Hidden-state projection 21.0M Markov head 65.5M Norms + confidence head 6.4k 合計 279.5M embeddingとLM headは
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。