小型AIが高性能で登場
OpenBMB Releases MiniCPM5-2B: A 2.52B Dense Model Averaging 53.9 Across 34 Benchmarks and Built to Run On Device
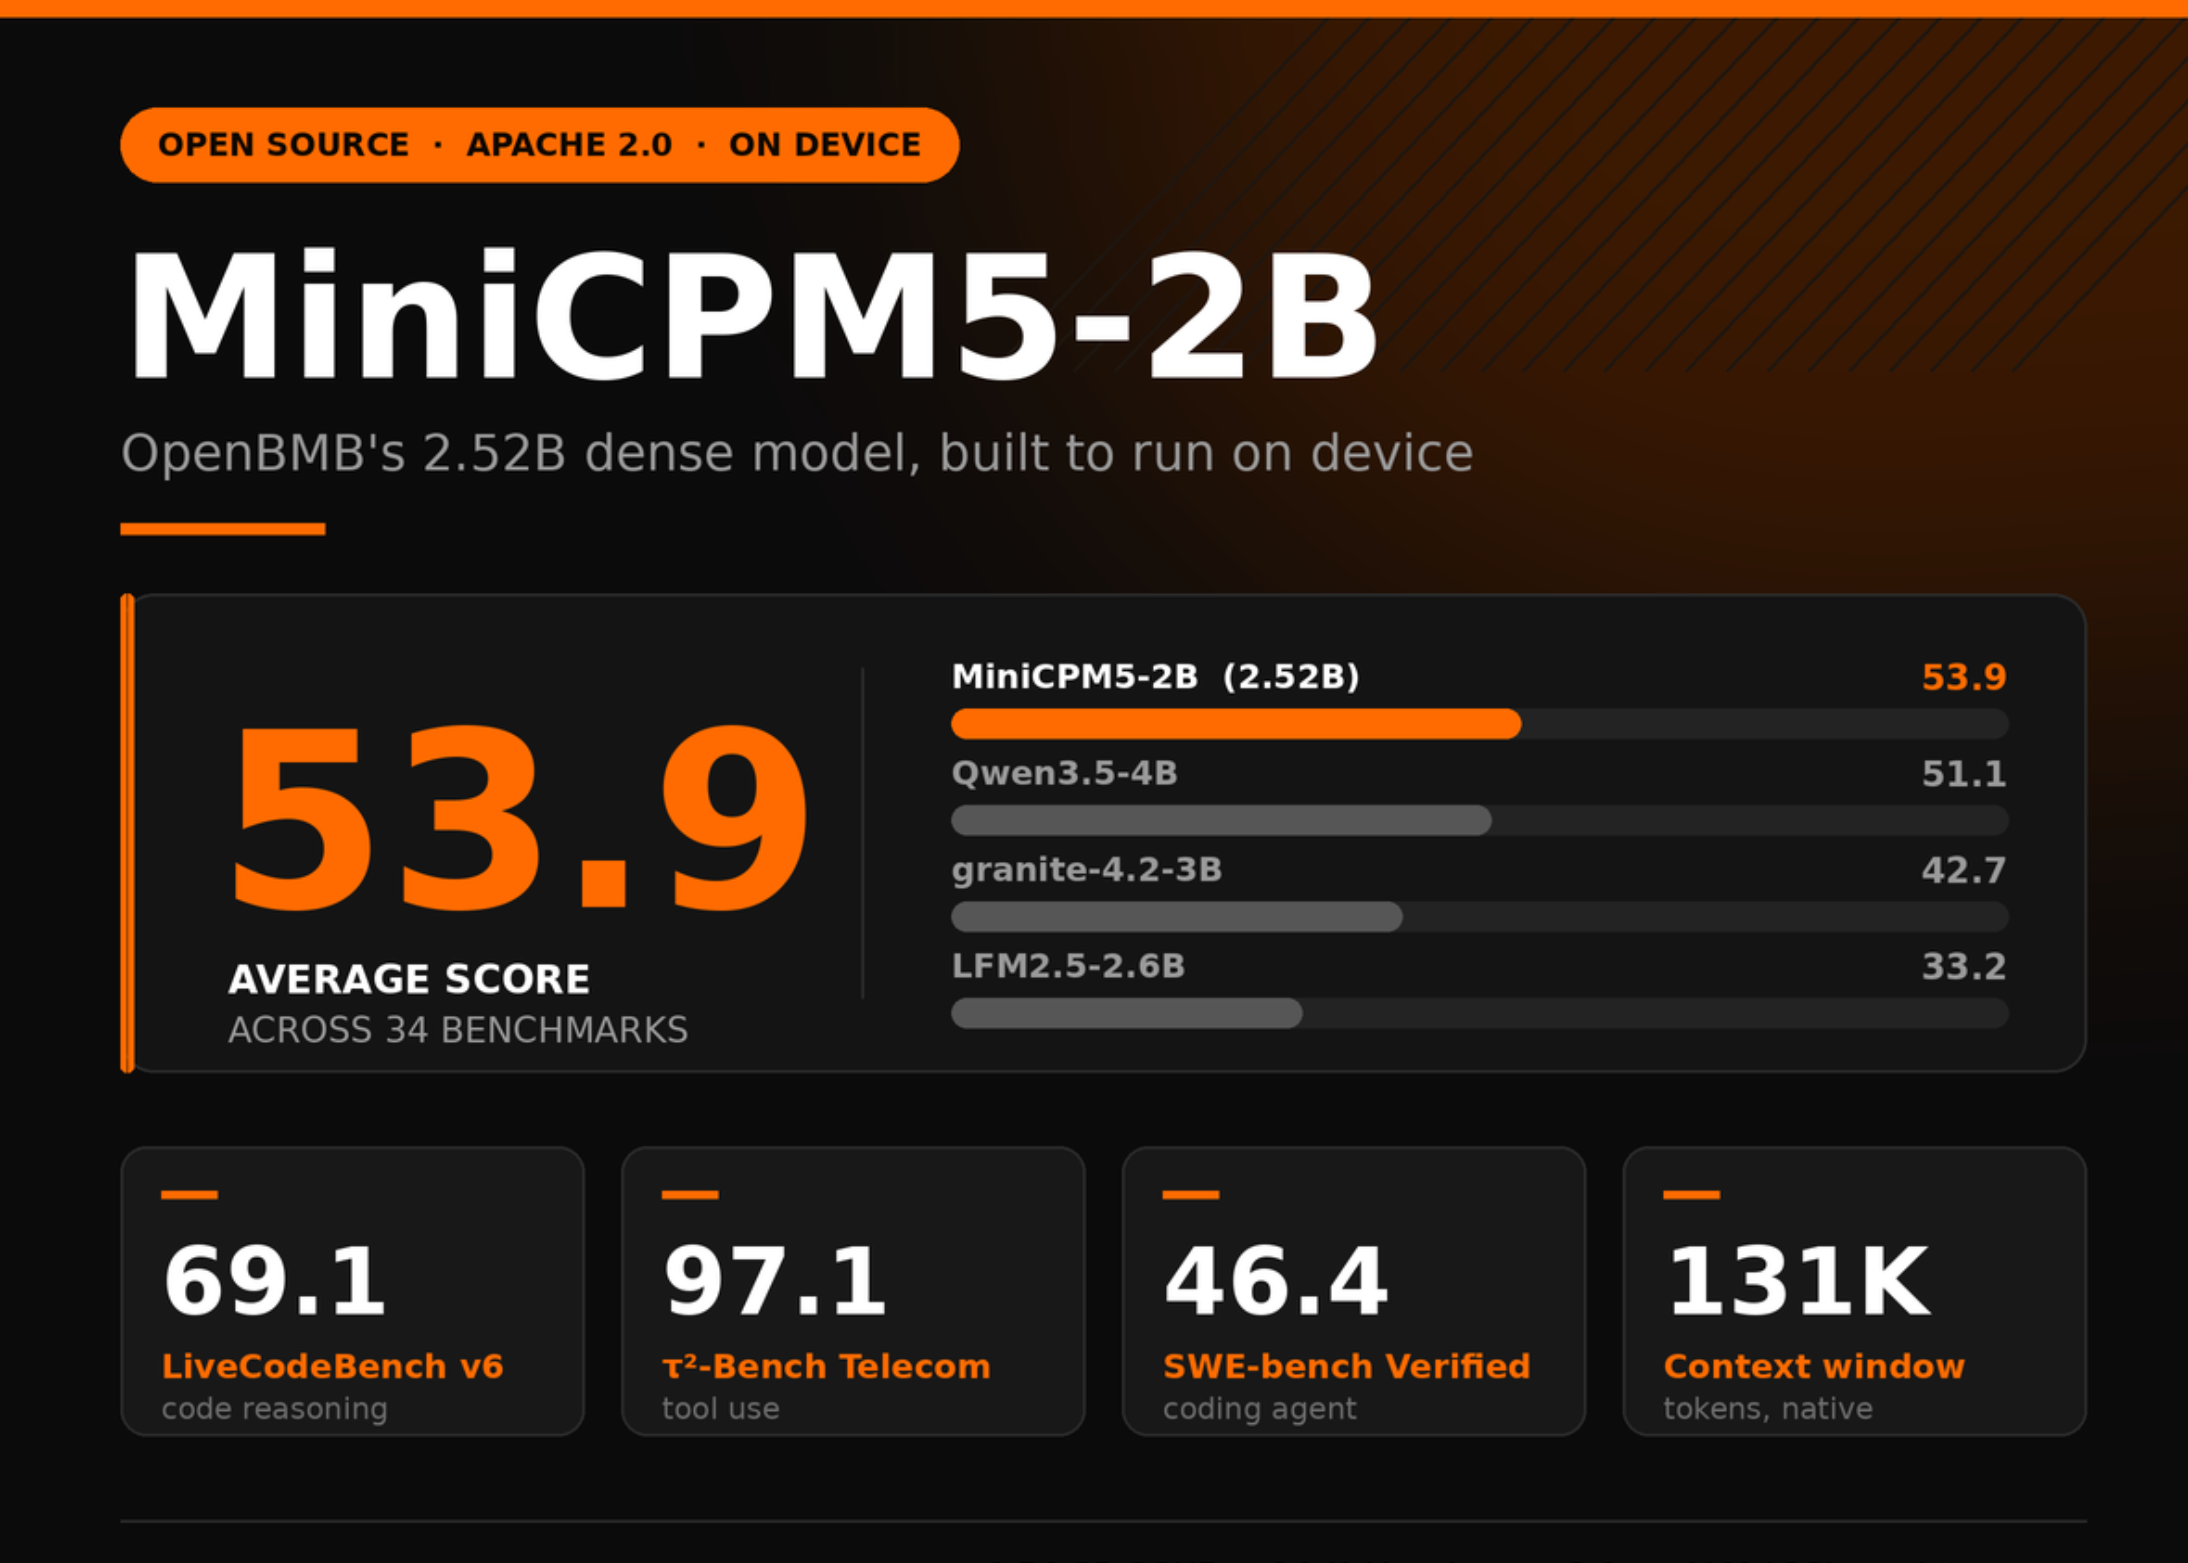
OpenBMBが、パソコンやスマホで動く小型AI「MiniCPM5-2B」を発表。25億個の部品で平均53.9点と高性能で、AIをより身近にするでしょう。
OpenBMBは、MiniCPM5シリーズの2番目のチェックポイントであり、MiniCPM5-1Bの後継となるMiniCPM5-2Bをリリースしました。これは、2,516,756,480個のparametersを持つ密な因果言語モデルであり、そのうち1,981,982,720個はembeddingsの外に位置しています。42層、16のquery headsと2つのkey/value headsを持つgrouped-query attention、および131,072 tokensのnative context windowを使用しています。アーキテクチャは標準的なLlamaForCausalLMであるため、主流のエンジンはcustom kernelsやmodel-code forkなしでこれをロードできます。展開可能でしょうか?はい。weightsはApache 2.0で、vLLM、SGLang、Transformers、llama.cpp、Ollama、LM Studio、MLX、FlagOSを通じて実行できます。<br>ベンチマークテーブルが実際に示していること<br>OpenBMBは、MiniCPM5-2Bを同サイズのLFM2.5-2.6B、Qwen3.5-2B、Gemma-4-E2B-itと比較し、Qwen3.5-4B、granite-4.2-3B、Nemotron-3-Nano-4B、Gemma-4-E4B-it、LFM2.5-8B-A1Bを参照としてリストしています。34のベンチマーク項目全体で平均53.9を記録しました。このセットで最高のbaselineはQwen3.5-4Bの51.1、次いでgranite-4.2-3Bの42.7、LFM2.5-2.6Bの33.2です。コード推論では、MiniCPM5-2BはLiveCodeBench v6で56.4に対して69.1、SWE-bench Verifiedで33.6に対して46.4を記録しました。ツール使用は最も差が大きく、τ²-Bench Telecomで97.1、BFCL v4で66.6、τ³-Bench Bankingで6.8に対して20.8を記録しました。長文contextは分かれており、NoLiMaで43.5に対して68.1ですが、AA-LCRで61.0に対して59.0、LongBench v2で47.3に対して43.7でした。一般的な知識はサイズ差が現れるところで、MMLU-Proで78.0に対して70.8、Humanity's Last Examで9.9に対して8.9でした。OpenBMBは、Artificial Analysisから取得した行と内部で再現した行を区別してマークしています。<br>トレーニングレシピ:SFT、次にRL、次にon-policy distillation<br>トレーニングは、元のresearchで説明されているUltraData tiered data management methodに従います。基本トレーニングはstable and decay phasesを実行し、その後、mid-trainingでmodelをtarget data distributionに適応させます。Post-trainingは、400B tokensのdeep-thinking SFTから始まり、その後、数学、コード、agent向けのspecialised RL teachersをトレーニングします。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。