アリババ、次世代AIの試作公開
Alibaba’s Qwen Team Releases Qwen3.8-Flash-Next: A 125B Multimodal MoE With 6B Active Parameters Previewing the Qwen4 Architecture
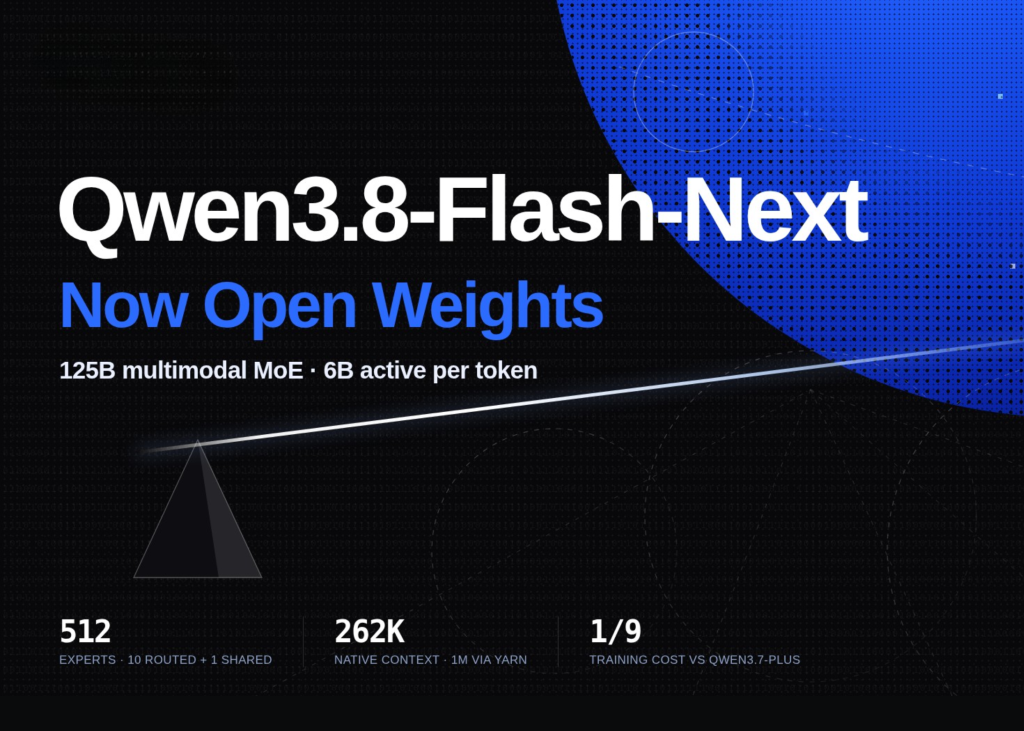
アリババが、計算コストを約9分の1に抑えられる新しいAI「Qwen3.8-Flash-Next」を公開。次世代AIの技術を先行体験でき、AI利用が手軽になる可能性を示します。
アリババのQwenチームは、トークンあたりのコストを考慮して構築されたオープンウェイトのマルチモーダル Mixture-of-Experts モデルであるQwen3.8-Flash-Nextをリリースしました。このチェックポイントは、125Bのバックボーンと51BのN-gram embeddingテーブル、そして4Bのマルチトークン予測モジュールを組み合わせています。トークンあたり6Bのパラメータのみがアクティブになります。チームはこれを、Qwen3-NextがQwen3.5で果たしたのと同じ役割で、Qwen4を支えるアーキテクチャの初期プレビューと位置付けています。このリリースには、Gated DeltaNetとQwen Sparse Attentionのハイブリッド、Gated Residual、N-gram Embedding、そしてMuon optimizerという4つの変更点が含まれています。Qwenチームは、トレーニングコストがQwen3.7-Plusの約9分の1であると報告しています。展開可能でしょうか?はい、しかしワークステーションではできません。FP8チェックポイントは172.78 GiB、BF16チェックポイントは335.28 GiBです。vLLMのレシピによると、GB300でのFP8構成の最小検証済みはTP2であり、TP4が推奨されます。8×H200ノードではTEP8を使用してください。通常のTP8は、チェックポイントの128ワイド量子化ブロックと互換性がありません。Sparse activationは計算を削減しますが、ストレージは削減しません。https://qwen.ai/blog?id=qwen3.8-flash-next<br>実際に新しい点<br>Qwen3.8-Flash-Nextは、125Bのメインモデルと51BのN-gram embeddingパラメータ、そして4Bのマルチトークン予測モジュールを組み合わせ、ディスク上で合計180Bになります。トークンあたり6Bのパラメータのみがアクティブになります。これを推進する4つの変更点があります。<br>ハイブリッドアテンション (GDN + QSA):4層のうち3層はGated DeltaNetを使用します。これは履歴を固定サイズのリカレント状態に圧縮する線形アテンション層です。4層目はQwen Sparse Attention (QSA)を実行します。これは軽量なインデクサーを使用して、トークンごとではなくマイクロブロック粒度でコンテキストを選択します。レイヤーの配置は、48層にわたって12 × (3 × GDN → 1 × QSA)であり、QSAの予算は512ブロックまたは2048トークンです。<br>Gated Residual:レジデュアルストリームは、ボトルネックランク320で、要素ごとの読み取りゲートとブランチごとのスカラー書き込みゲートを備えた4つの並列ブランチに広がります。<br>N-gram Embedding:レイヤー2にある20,000,000エントリのバイグラム/トライグラムテーブルは、決定論的なルックアップを通じて容量を追加します。これは
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。