Perplexity、AI情報整理の裏側を公開
Perplexity Details Its GPU Embedding Stack: How Ivy, Tulip and ROSE Serve pplx-embed
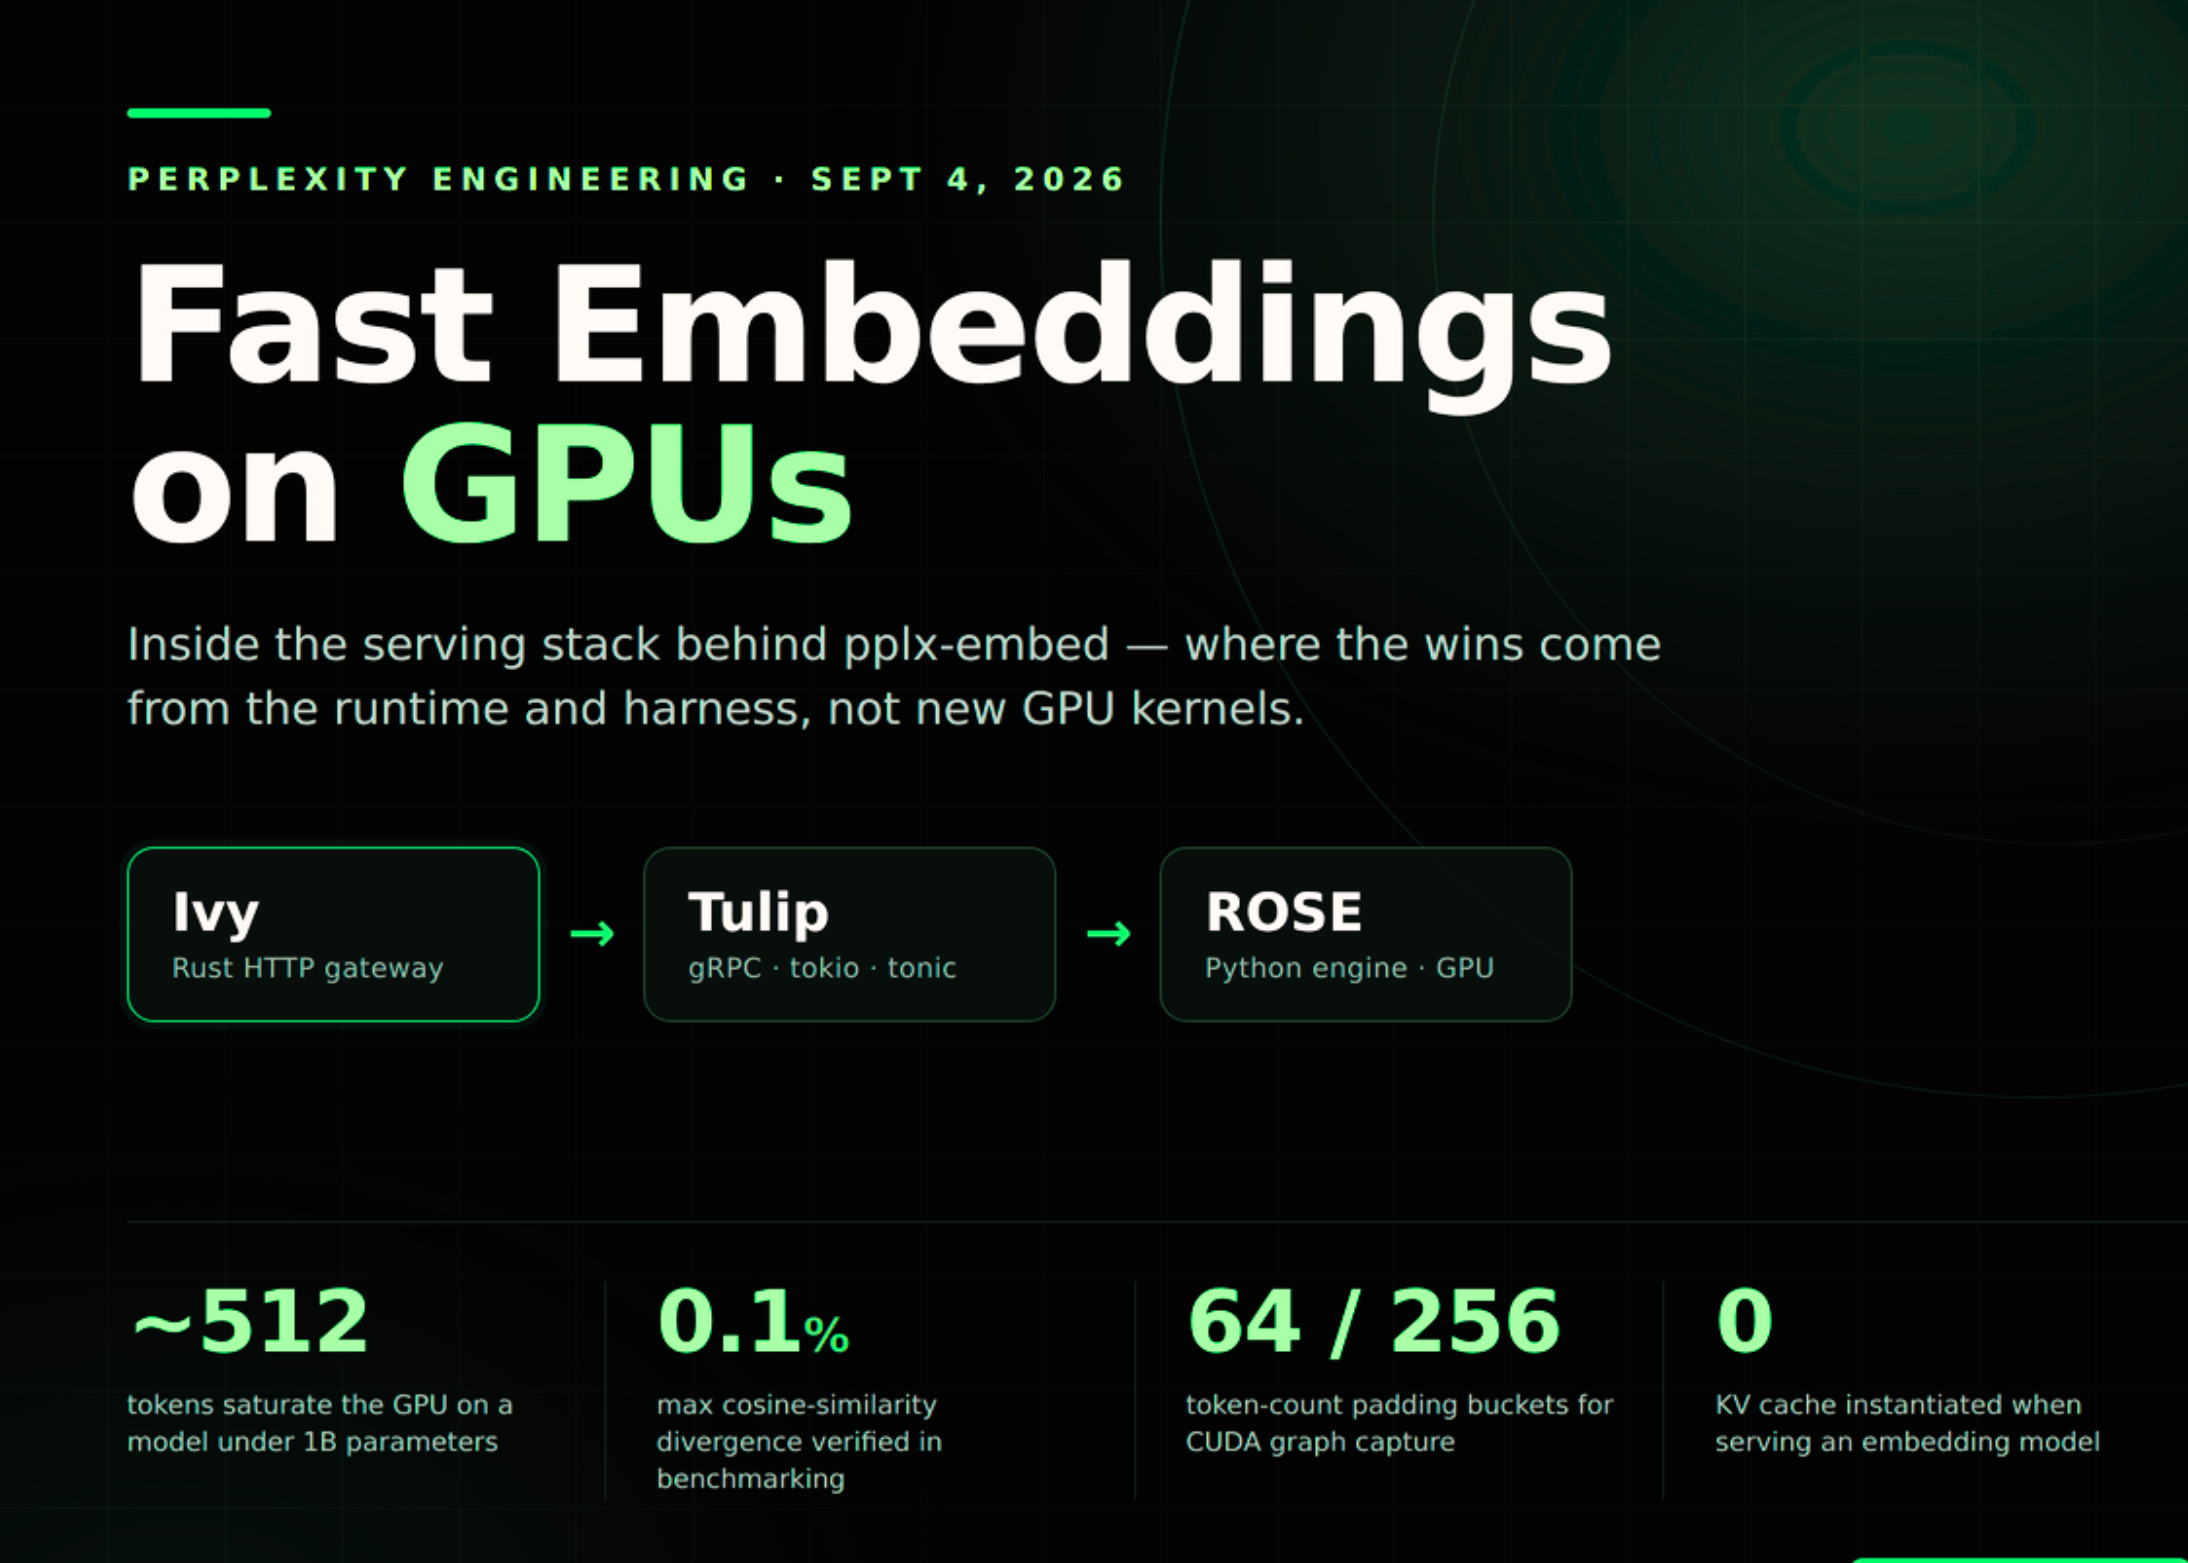
Perplexityは、AI検索で情報を高速整理する技術基盤を公開。Ivy、Tulip、ROSEがGPUを効率的に活用し、検索品質と処理速度を向上させます。
AI検索製品における情報検索の品質は、2つの要素によって決まります。1つは埋め込みモデル(embedding model)の性能、もう1つはインデックス全体でそれをどれだけ安価に実行できるかです。今週、Perplexity Engineeringチームは「Fast Embeddings on GPUs」を公開しました。これは後者、つまりpplx-embedの背後にあるサービス提供インフラストラクチャと、Perplexity Search、Computer、およびAPI Platform全体で使用されているランキングモデルに関する内部の詳細な説明です。Perplexityチームは、GPU側でのembedding inferenceは、成熟したHopperおよびBlackwellハードウェア上のエンジン間でほぼ収束していると述べています。成功の鍵は、モデル周辺のランタイムとハーネスにあります。具体的には、CUDA graph management、非同期の結果追跡抽象化、およびRustによるリクエストパスです。<br>2つのトラフィックパターン、1つのエンジン<br>Perplexityは、embeddingのサービス提供を2つのワークロードとして捉えています。バッチ埋め込み(Batch embedding)は、ベクトルデータベースの構築または再インデックス化の際に行われ、スループットがコストを最小化します。オンライン埋め込み(Online embedding)はクエリ時に行われ、短いクエリを高速に埋め込む必要があります。スコアリング(Scoring)はその中間に位置します。ベクトル検索の後、大規模なドキュメントバッチがランク付けされ、両方のバランスが取られます。重要な決定は、Perplexityが個別のembeddingエンジンを構築しなかったことです。embeddingモデルは小さなTransformersであるため、バッチ埋め込みは計算集約的なprefillに似ており、オンライン埋め込み(多くの場合、数トークン)はメモリ集約的なdecodeに似ています。そのため、研究チームはLLMスタックのprefillおよびdecodeカーネルを再利用しています。<br>Ivy、Tulip、ROSE<br>3つのサービスがリクエストを処理します。IvyはRust製のHTTPゲートウェイです。これはCPU側の作業(JSON解析、tokenization、入力テンプレート化、バッチ分割)を行い、リクエストをカスタムgRPCプロトコルに変換します。また、大規模なバッチリクエストをチャンクに分割し、レプリカ間で負荷分散を行います。これにより、本番環境のペイロードサイズが異なる場合に発生する負荷の不均衡を是正します。Tulipは推論サーバーインターフェースです。Rust、tokio、tonicで構築されたgRPCサーバーで、エンジンにディスパッチする前にスケジューリングとバッチ処理を処理します。ROSE(Runtime-Optimized Serving Engine)はモデルの実装を担います。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。