インド22言語と英語対応の音声AI
Sarvam AI Releases Saaras V4: A Speech-to-Text Model for All 22 Indian Languages and Global English
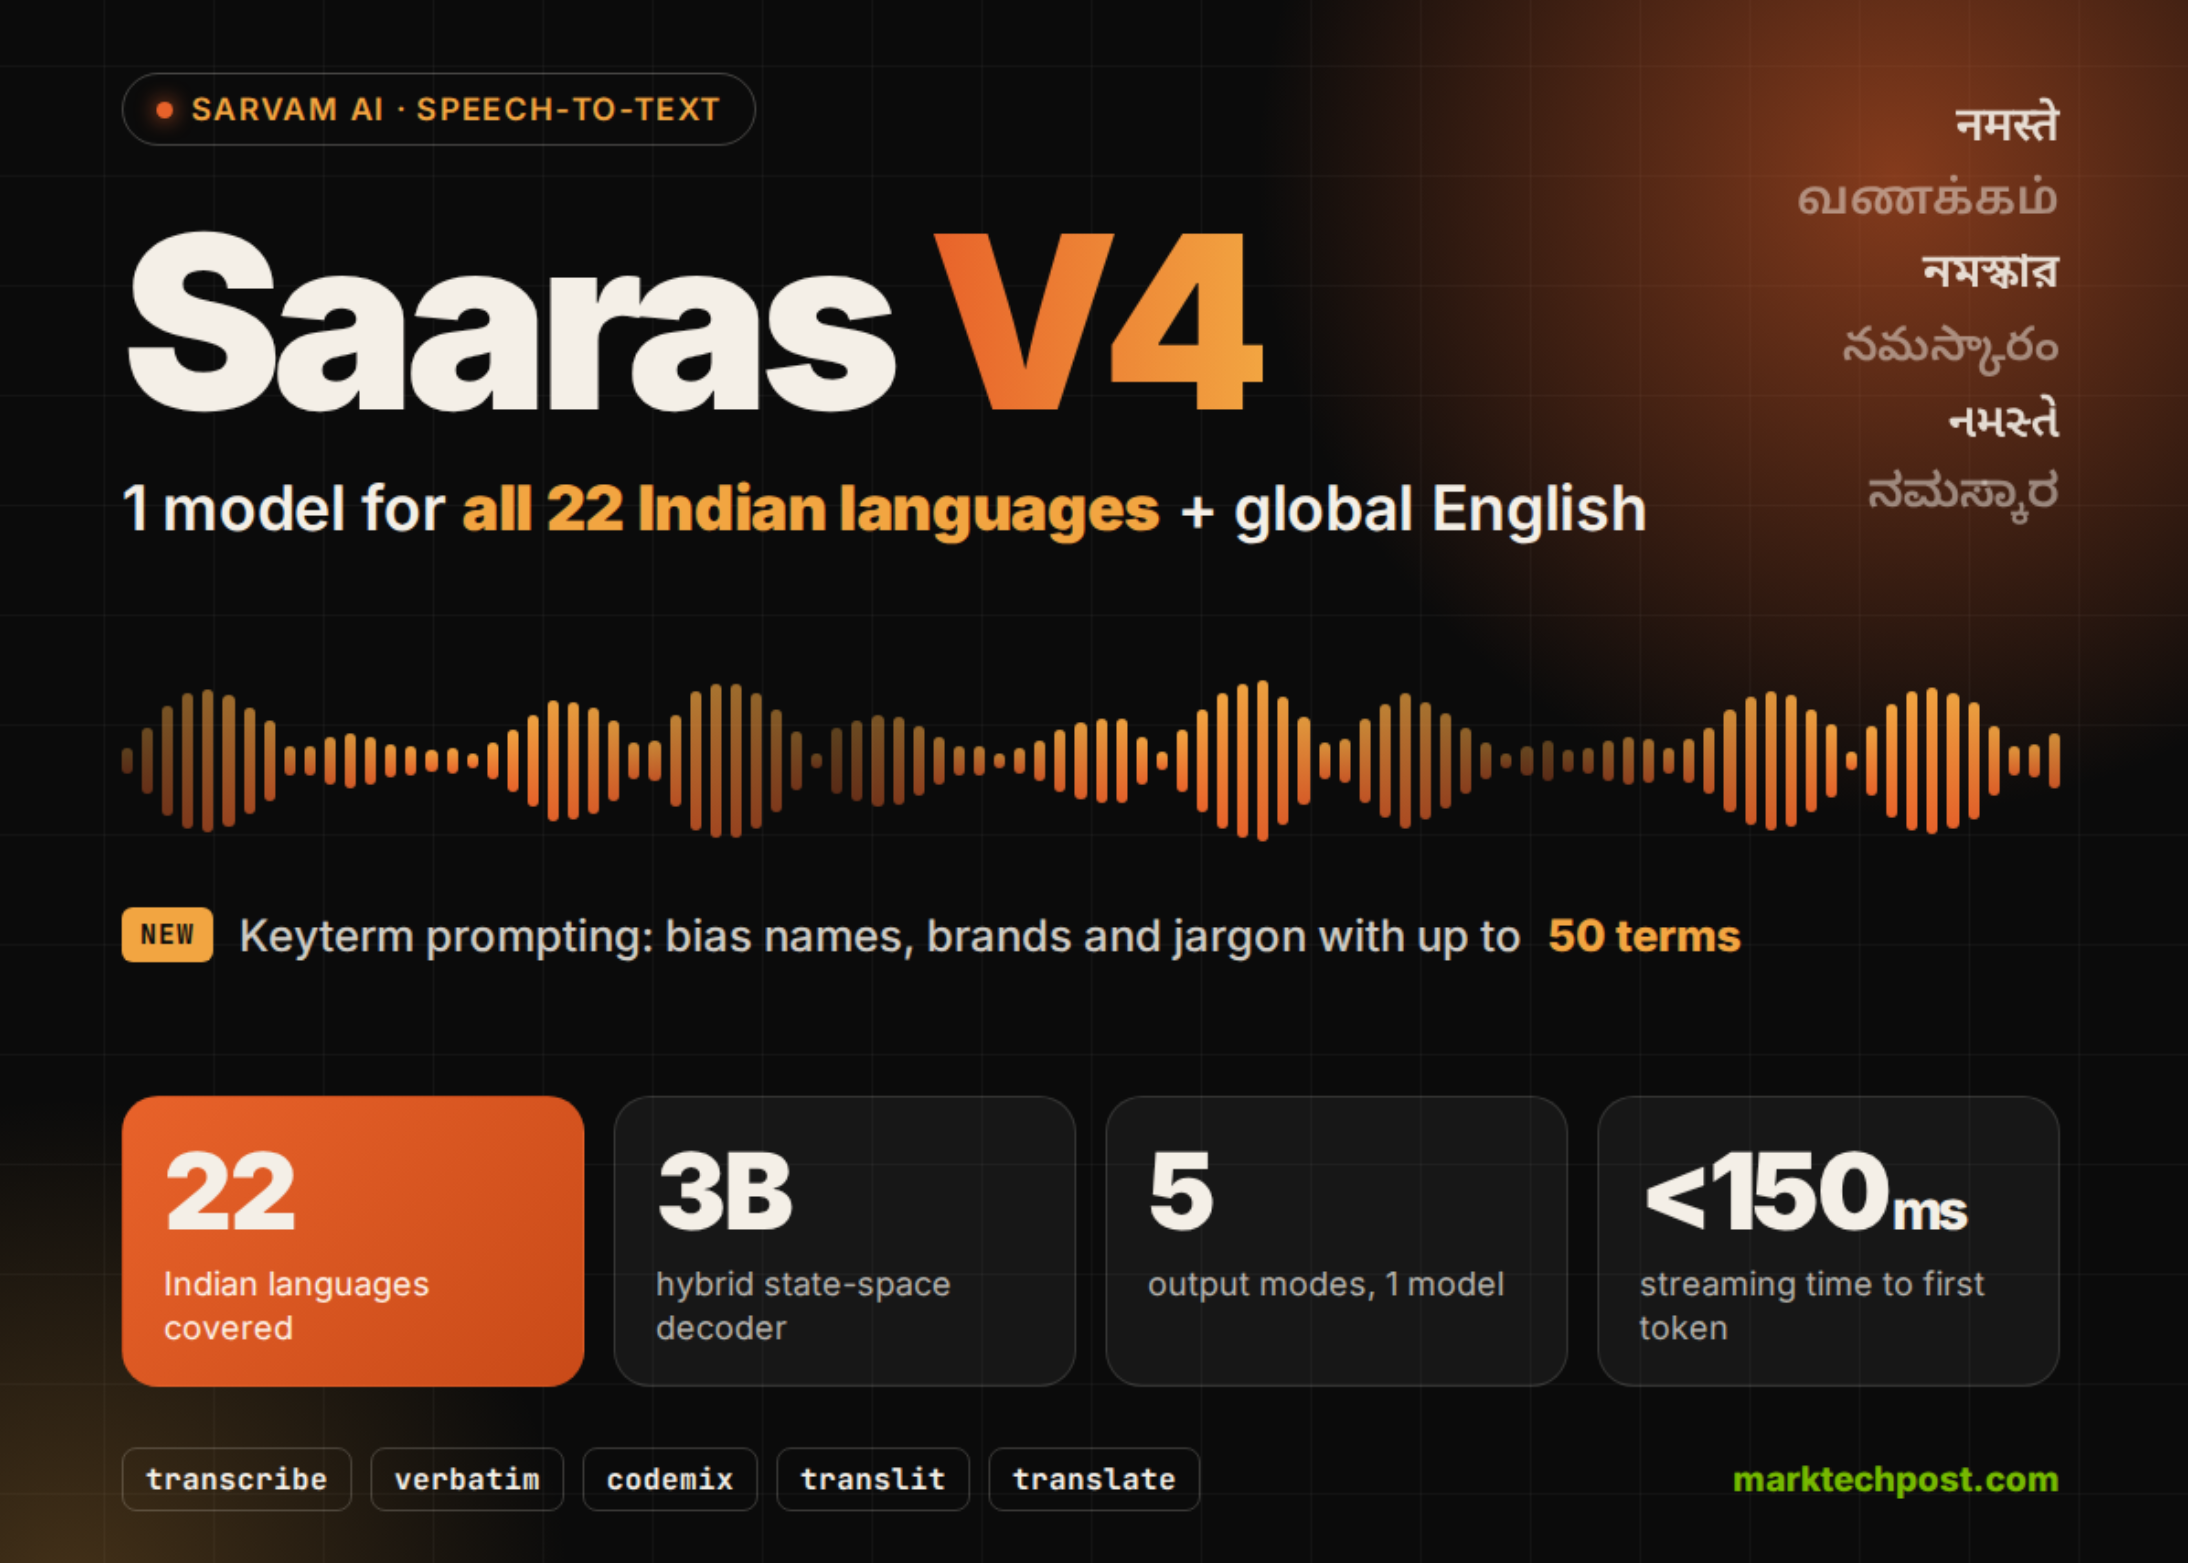
Sarvam AIがインドの22言語と世界中の英語に対応する高精度な音声認識AI「Saaras V4」を公開。多様なアクセントやノイズ環境でも高い認識精度を実現し、幅広い用途での利用が期待されます。
Sarvam AIは、音声認識モデルの最新世代であるSaaras V4をリリースしました。これは、インドの22の指定言語すべてと英語をカバーし、現在では世界中の英語アクセントにも対応しています。Sarvamは、22の全言語で最先端の精度を報告しています。展開可能か?はい、SarvamのAPIを通じて本日よりmodel="saaras:v4"として利用可能です。モデルの重みは公開されておらず、SarvamのSageMakerセルフホスティングドキュメントは現在Saaras v3のみを対象としています。 どのような仕組みか Saaras V4はエンコーダー・デコーダーシステムです。オーディオエンコーダーは波形を、音韻的および音響的な詳細を保持するembeddingsに変換します。その後、時間的ダウンサンプリングアダプターがそのシーケンスを短縮し、言語モデルのembedding spaceに投影します。これにより、長い録音もデコーダーのコンテキスト予算内に収まります。デコーダーはSarvam-3Bで、社内でゼロから学習された30億パラメータのハイブリッド状態空間言語モデルです。これはテキストプロンプトとともに音声の特徴を読み込みます。そして、各トークンを次の入力としてフィードバックしながら、自動回帰的に文字起こしを出力します。 ベンチマーク結果 英語: Sarvamは7つの英語データセットを評価しました。6つはHugging FaceのOpen ASR Leaderboardからのもので、AMI、GigaSpeech、LibriSpeech clean、LibriSpeech other、SPGISpeech、VoxPopuliです。7つ目はAI4BharatのインドアクセントのSvarahです。スコアリングはリーダーボードの正規化コードに従っています。Saaras V4は、Sarvamがベンチマークしたモデルの中で最も低い平均WERを記録しました。 インド系言語: Vistaarにおいて、SarvamはWERとLLM-WERの両方を使用して10のインド系言語での結果を報告しています。LLM-WERは意味的なチェックを追加します。これにより、インド系文字によく見られる無害なスペルや書式設定のバリエーションと、実際の意味のエラーを区別します。 ノイズの多い音声: LLM-WERで測定されたKathbath Noisyにおいて、SarvamはSaaras V4のエラー率がDeepgram Nova-3およびGPT-4o Transcribeの半分以下であると述べています。このセットには、圧縮され、クリップされ、背景ノイズの多い録音が含まれています。 言語識別: 検証済みのIndicVoicesの発話において、言語識別のエラー率は2.9%です。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。