AIが考える量を減らした新モデル
BottleCap AI Releases ThinkingCap-Qwen3.8-27B: 37.2% Fewer Thinking Tokens at a 0.86pp Accuracy Cost
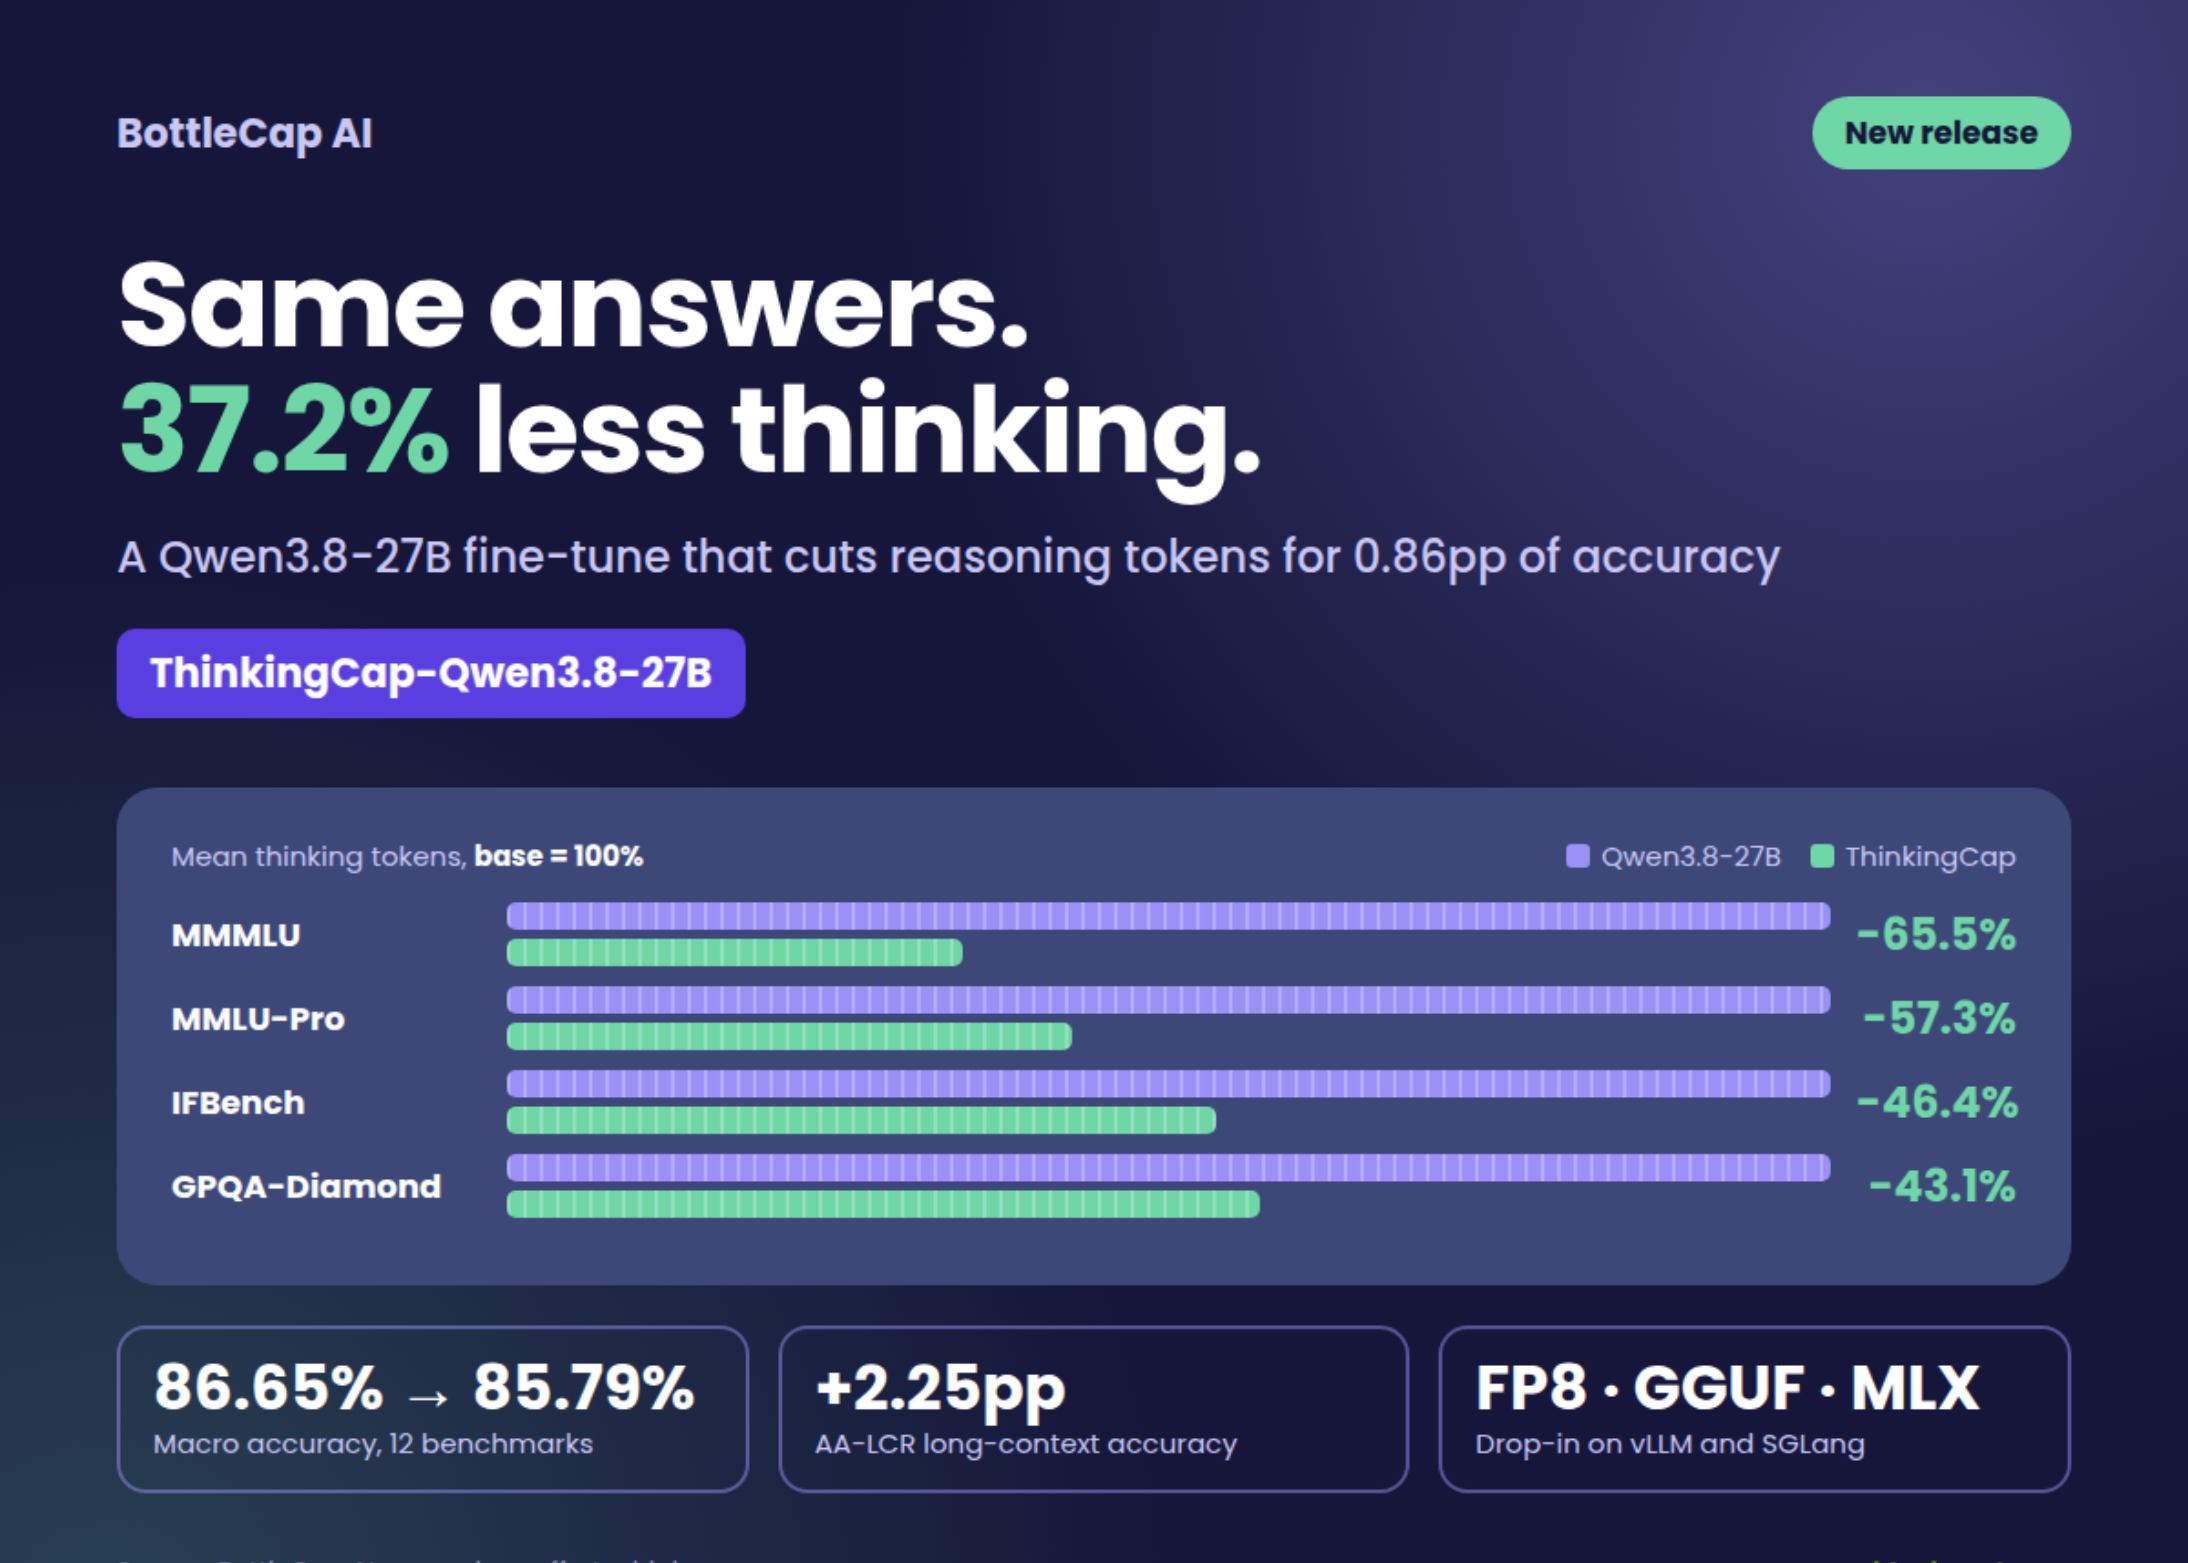
BottleCap AIが、AIが考えるための言葉を37.2%減らす新モデルを発表。わずかな精度低下で効率が大幅に向上し、AIの運用コスト削減に貢献します。
BottleCap AIは、ThinkingCapシリーズの第2弾となるモデル、ThinkingCap-Qwen3.8-27Bをリリースしました。これはQwenチームのQwen3.8-27Bを、推論の過程を短くするという一つの明確な目標のためにfine-tuneしたものです。12のベンチマークにおいて、平均で37.2%少ない思考トークンを使用します。マクロ平均の精度は86.65%から85.79%へと、0.86ppの低下です。展開可能か?はい。vLLMまたはSGLangでQwen3.8-27Bの代わりにドロップインでき、FP8、NVFP4、GGUF、MLXビルドが利用可能です。リポジトリはゲートされており、小規模ビジネスライセンスを超える商用利用にはBottleCapとの契約が必要です。ThinkingCapがターゲットとする問題は何ですか?推論モデルは、質問に必要な量よりも多くの思考トークンを費やすことがよくあります。BottleCapの立場は、それらの余分なトークンの多くは最終的な答えを変えないというものです。このシリーズの最初のリリースでは、このアイデアをQwen3.6-27Bに適用しました。今回の目標は意図的に保守的でした。BottleCapは知識を追加したり、回答スタイルを変更したりしようとはしませんでした。推論能力、指示への追従、安全性の挙動は、そのまま維持されることを意図していました。研究チームはまた、数学、推論、長文コンテキスト、エージェント的なベンチマークに重点を置きました。xhigh Effortでのベンチマーク結果すべての主要な数値は、チャットテンプレートのデフォルトであるreasoning_effort=xhighを使用しています。すべてのベンチマークで思考トークンが短縮され、削減率は10.7%から65.5%に及びます。知識および多言語タスクが最も大きく縮小します。MMMLUは65.5%(1,656トークンから571トークンへ)、MMLU-Proは57.3%減少します。GPQA-Diamondは12,772トークンから7,267トークンへと、43.1%の削減です。IFBenchは精度がほぼ横ばい(79.75%から79.71%)で46.4%思考が少なくなります。長文コンテキスト検索は改善します。AA-LCRの精度は2.25pp上昇し、81.75%から84.00%になり、思考トークンは38.6%減少します。LiveCodeBench v6は思考が20.3%減少しながら0.07ppわずかに上昇します。エージェント的な結果はベースモデルに近い値を維持します。τ²-benchは30.9%の削減に対して1.01ppの低下です。Terminal-Bench 2.1は10.7%の削減に対して0.56ppの低下で、±4.26の範囲内です。最も費用のかかるトレードオフはAIME 2026です。精度は3.85pp低下し、98.13%から94.27%になり、思考トークンは30.2%減少します。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。