マイクロソフト、話すAIで最速1位
Microsoft AI Releases MAI-Transcribe-2-Streaming: #1 Real-Time Speech-to-Text Model on Artificial Analysis
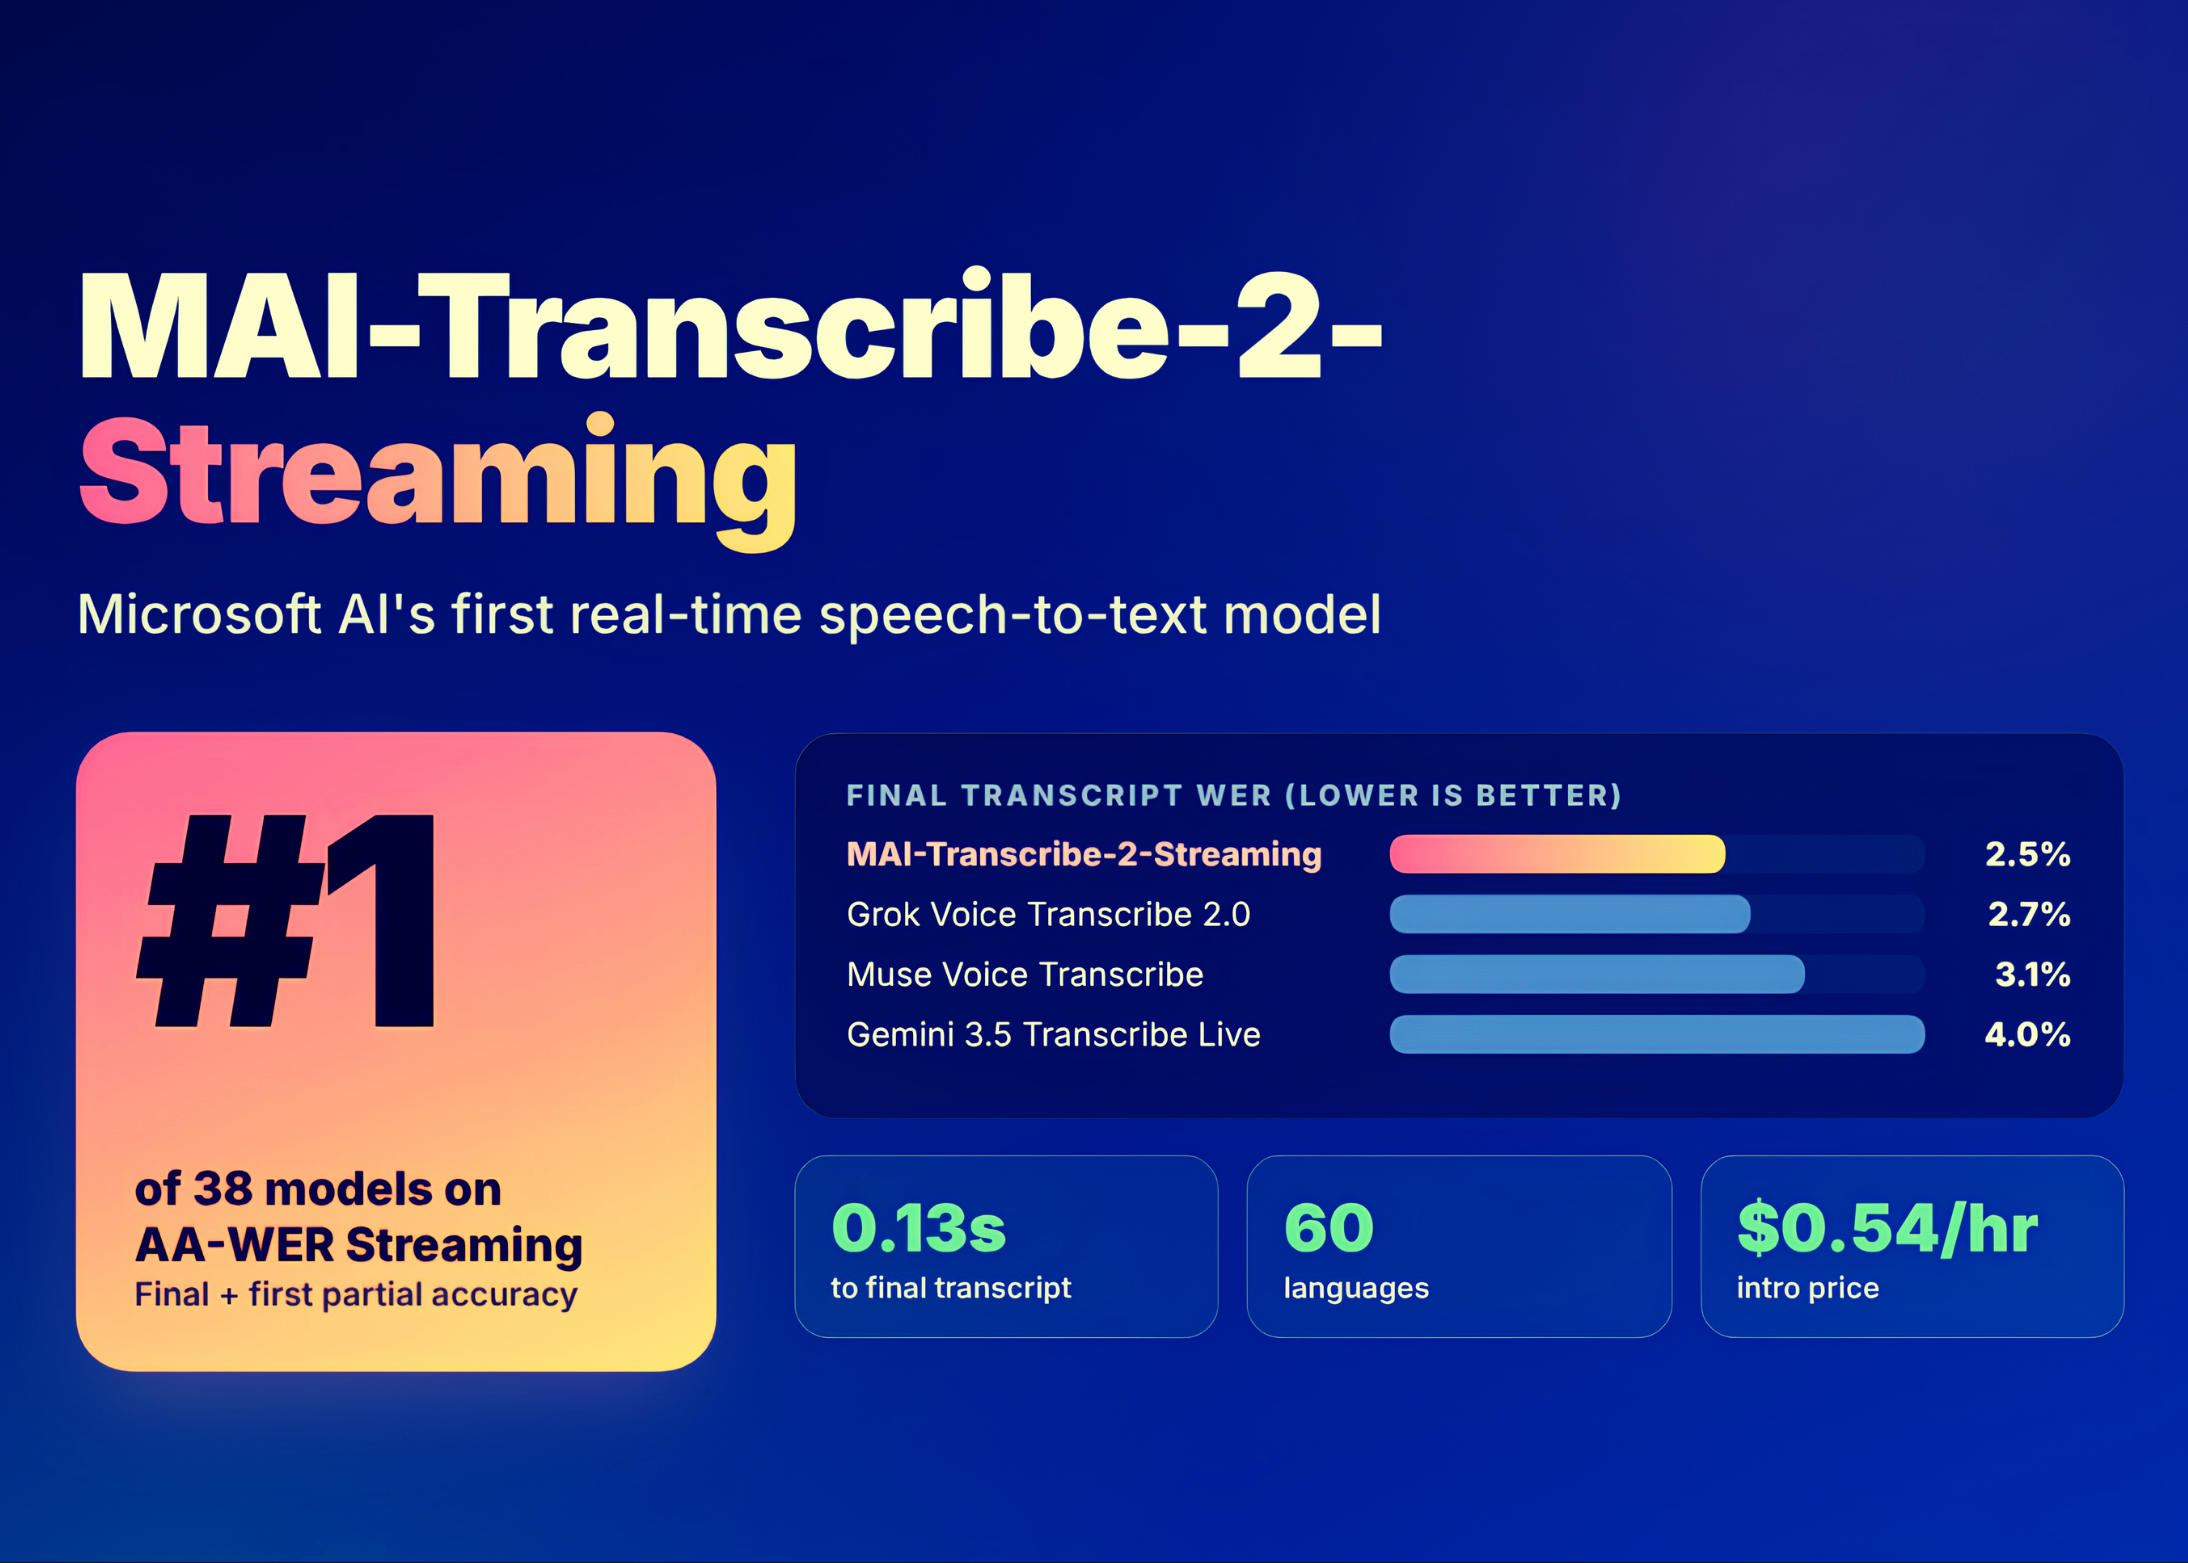
Microsoft AIが、話した言葉をすぐに文字にするAIで業界トップの性能を達成。これにより、AIがより速く人の言葉を理解し、応答できるようになります。
Microsoft AIは、初のストリーミング音声認識(STT)モデルであるMAI-Transcribe-2-Streamingをリリースしました。これは2026年10月1日に、2つのテキスト読み上げモデル、MAI-Voice-2.1およびMAI-Voice-2.1-Flashと共に発表されました。Artificial Analysisは、最終および最初の部分的な文字起こし精度において、38モデル中1位にランク付けしています。このモデルは、音声エージェント、ライブキャプション、ディクテーションなど、遅延が体験を左右する用途を対象としています。What Microsoft Shipped MAI-Transcribe-2-Streamingは、9月にリリースされたバッチ処理モデルMAI-Transcribe-2のリアルタイム版です。自動的かつ継続的な言語検出により、60言語を文字起こしします。音声は継続的にストリーミングされ、話者がまだ話している間にテキストが返されます。このモデルは、音声を受信してからわずか100ミリ秒強で、最初の仮説(部分的な文字起こし)を出力します。その後、文脈が到着するにつれてこれらの部分的な文字起こしを修正し、安定した最終的な文字起こしを確定します。そのため、エージェントは文の途中で推論を開始したり、ツールを呼び出したりすることができます。Microsoftチームは、社内テストにより、最も近い競合他社よりも2倍速く単語が表示されることを示していると述べています。What Artificial Analysis Measured The AA-WER Streamingインデックスは約8時間の音声を使用しています。その内訳は、AA-AgentTalk(50%)、VoxPopuli(25%)、Earnings22(25%)です。遅延は、SileroVADによって検出された発話の終了時点から計測されます。最終的な文字起こし:発話終了後0.13秒で2.5%のWER、38モデル中1位。最初の部分的な文字起こし:発話終了後0.12秒で2.5%のWER、これも1位。次点:Grok Voice Transcribe 2.0は2.7%で0.49秒。Muse Voice Transcribeは3.1%で0.16秒。最速ではない:Cartesia Ink-2(外部エンドポイント)は0.07秒で最終結果を返しますが、WERは4.0%です。最初の部分的な文字起こしは、最終的な文字起こしと同じくらい正確です。これは、話者が話し終える前に動作するエージェントにとって重要です。Microsoftはまた、このモデルを精度と遅延のパレートフロンティア上に位置付けています。window.addEventListener("message",function(e){if(e.data&&e.data.mtpMaiH){document.getElementById("mtp-mai-frame").style.height=e.data.mtpMaiH+"px";}});Pricing MAI-Transcribe-2-Streamingの価格設定
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。