AIが賢く短く考える新モデル
Fireworks AI Releases Ember-1: A Post-Trained Kimi K3 That Uses About 40% Fewer Tokens
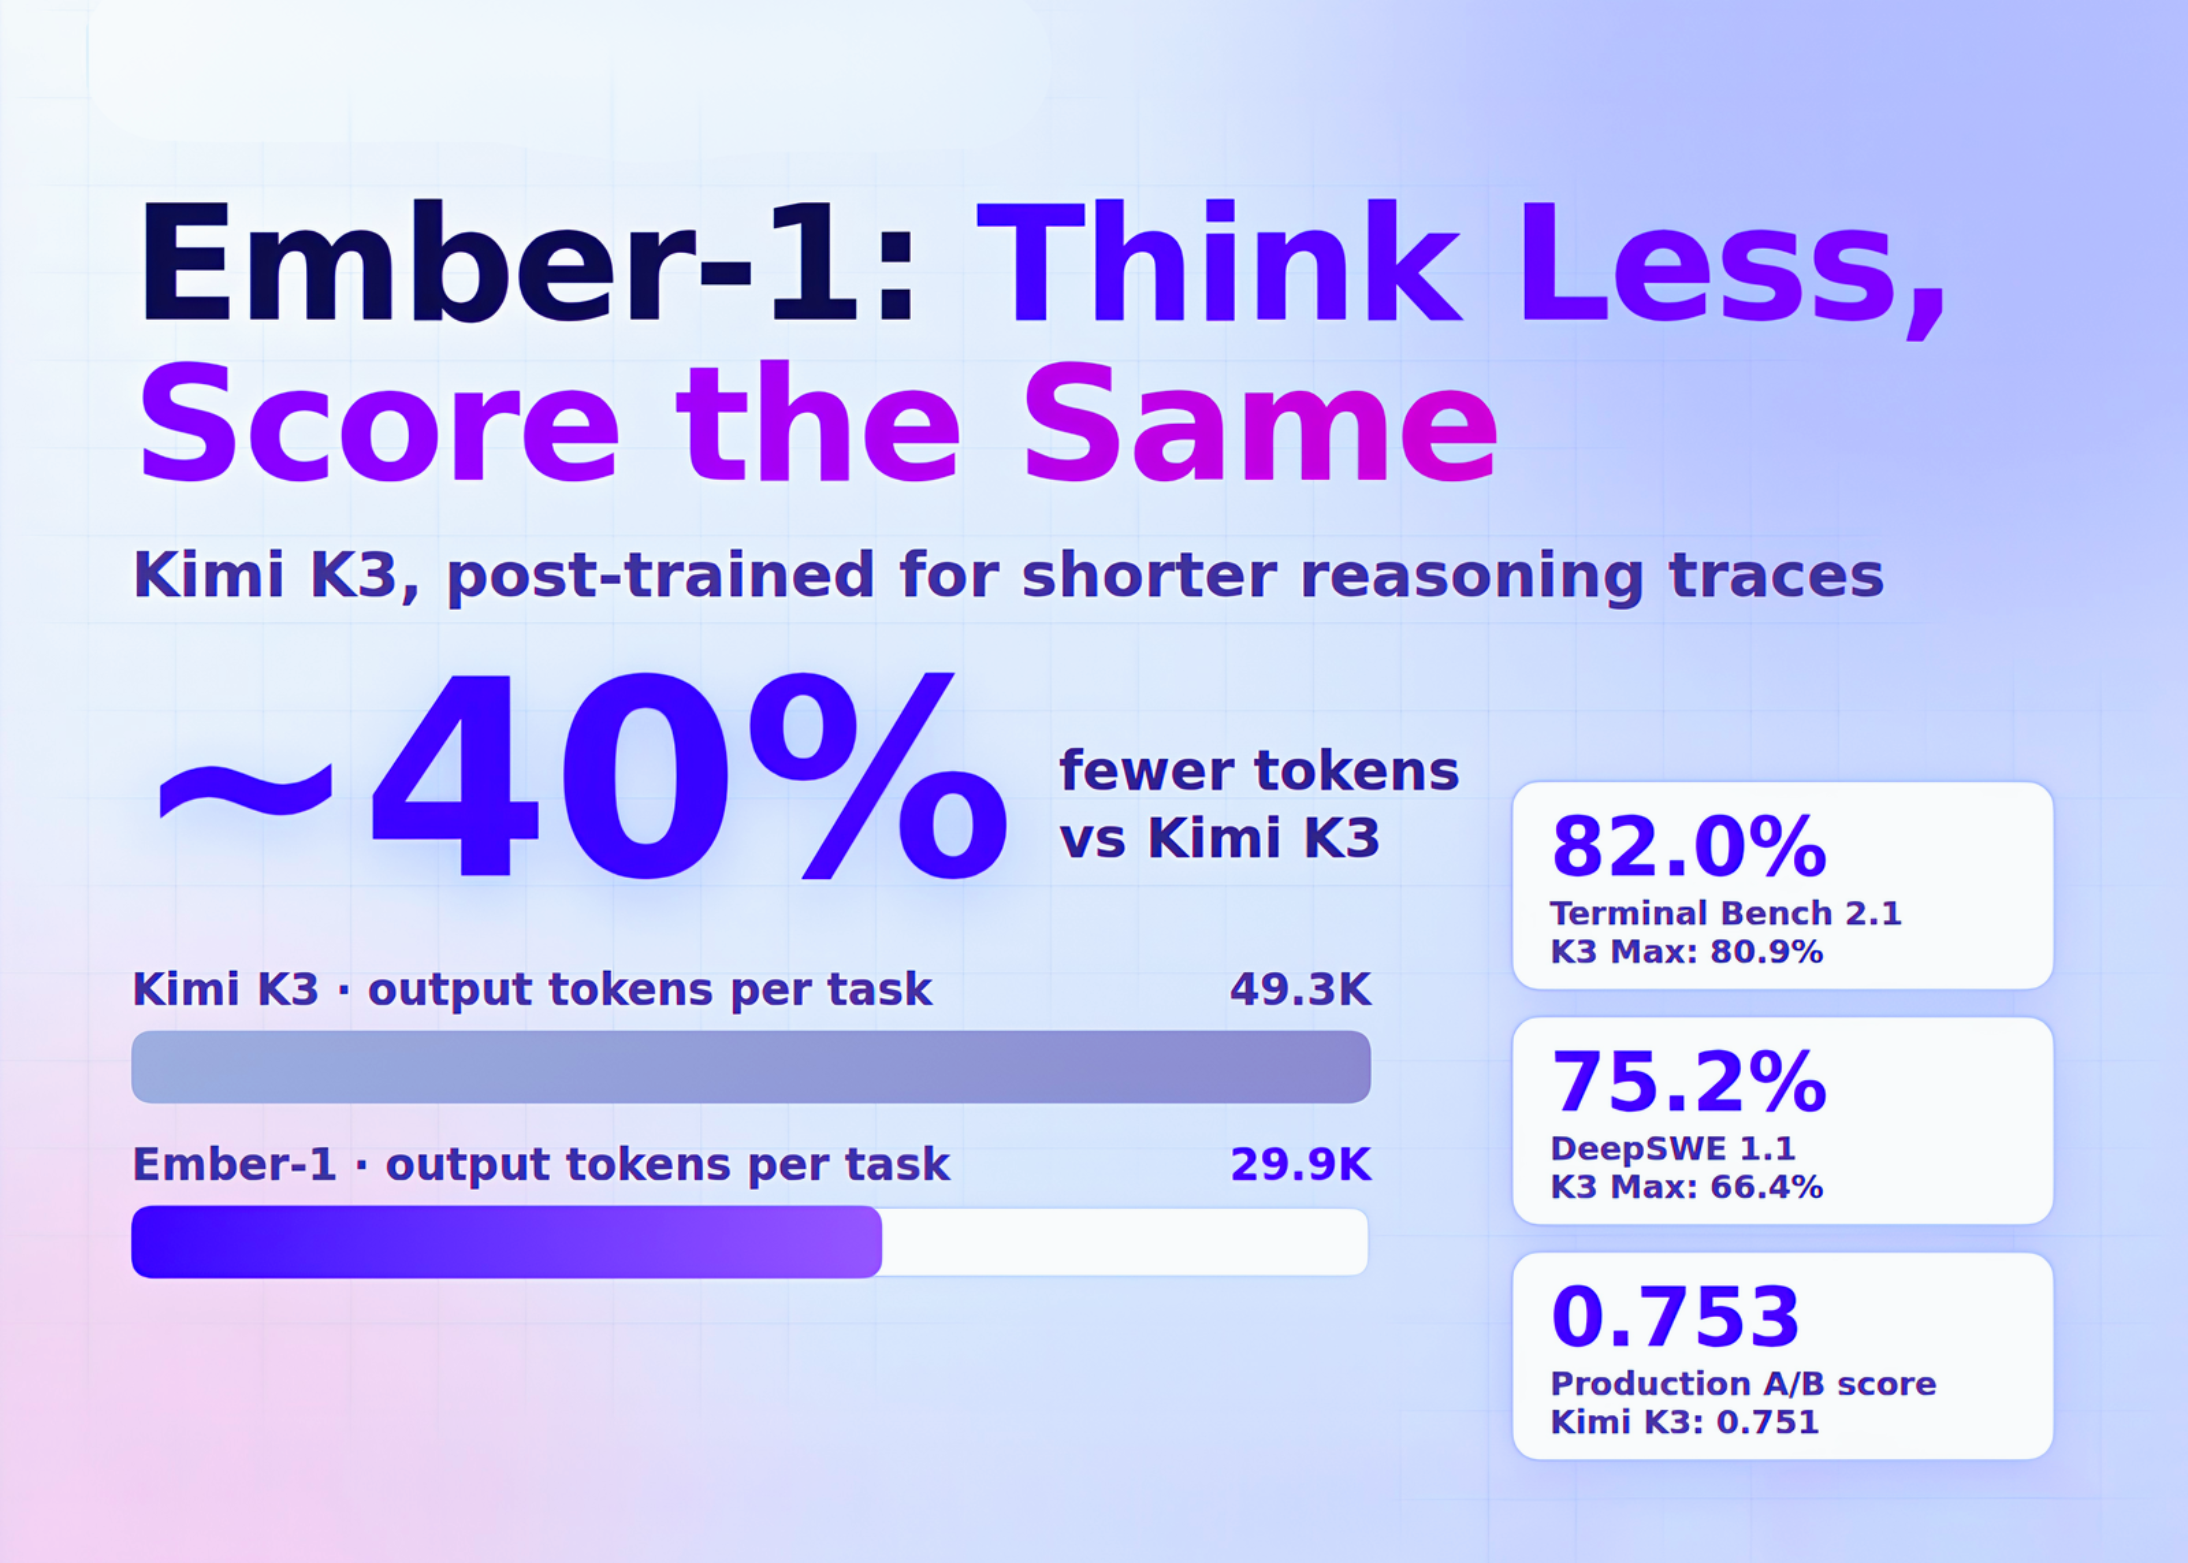
Fireworks AIの新しいAI「Ember-1」は、既存のAIの賢さを保ちながら、AIが考えるのに使う文章量(トークン)を約40%削減し、AIの利用コストを大幅に減らすことができます。
Fireworks AIは、Moonshot AIのオープンウェイトモデルKimi K3を後処理学習(post-training)することで構築された、Fireworks Researchによる特殊なモデルEmber-1をリリースしました。Ember-1は、タスクの精度を維持しながら、より短い推論の軌跡を生成するように学習します。これは、推論時に推論の労力設定を下げるのとは異なります。Fireworksのリリース投稿によると、Ember-1はKimi K3の品質を約40%少ないトークンで提供します。展開可能かというと、はい、ただしResearch PreviewとしてFireworks serverless APIを通じてのみです。FireworksはEmber-1のウェイト、トレーニングコード、または正確なトレーニングアルゴリズムを公開していないため、現時点では自己ホスティングは選択肢ではありません。 問題点:推論モデルは考えすぎることがある Fireworksチームは、Kimi K3のような推論モデルが、生成されるトークンの90%以上を内部推論に費やすことがあると報告しています。このコストは、複数ターンのagentic workloadsで複合的に増加します。各ターンで以前の推論がモデルに再生されます。コンテキストはターンの数に対してほぼ二次関数的に増加します。初期のターンからの長い軌跡は、その後のすべての呼び出しで再読み込みされ、再課金されます。Fireworksチームは、顧客がK3のコーディング能力をより低コストで求めていた経緯を説明しています。K3の推論労力を下げるだけでは解決しませんでした。労力設定を下げると、品質が大幅に低下したからです。そこでチームは、代わりにモデルをより効率的に推論するように訓練しました。 Fireworks ResearchがEmber-1を構築した方法 K3の推論のすべてが無駄というわけではありません。一部は、仮定を再検討したり、フィードバックに反応したりするような、有用な自己反省です。Ember-1は、冗長な推論や非生産的なループを削減しながら、その動作を維持します。トレーニングコレクションは、数学、コーディング、指示の追従、会話、検索、ツール使用、ソフトウェアエンジニアリングにわたります。これは、単独の問題と拡張された多段階のインタラクションの両方をカバーしています。タスクと環境からのフィードバックが、オンポリシーの計画と学習を導きます。Fireworksチームは50以上のトレーニング実験と200以上の評価を実施しました。彼らはまた、新しいトレーニングアルゴリズムも開発しました。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。