Anthropicが新AI発表、安く高性能
Anthropic Releases Claude Opus 5.5: Fable 5.1-Level Performance at 40% Lower Running Cost Than Opus 5
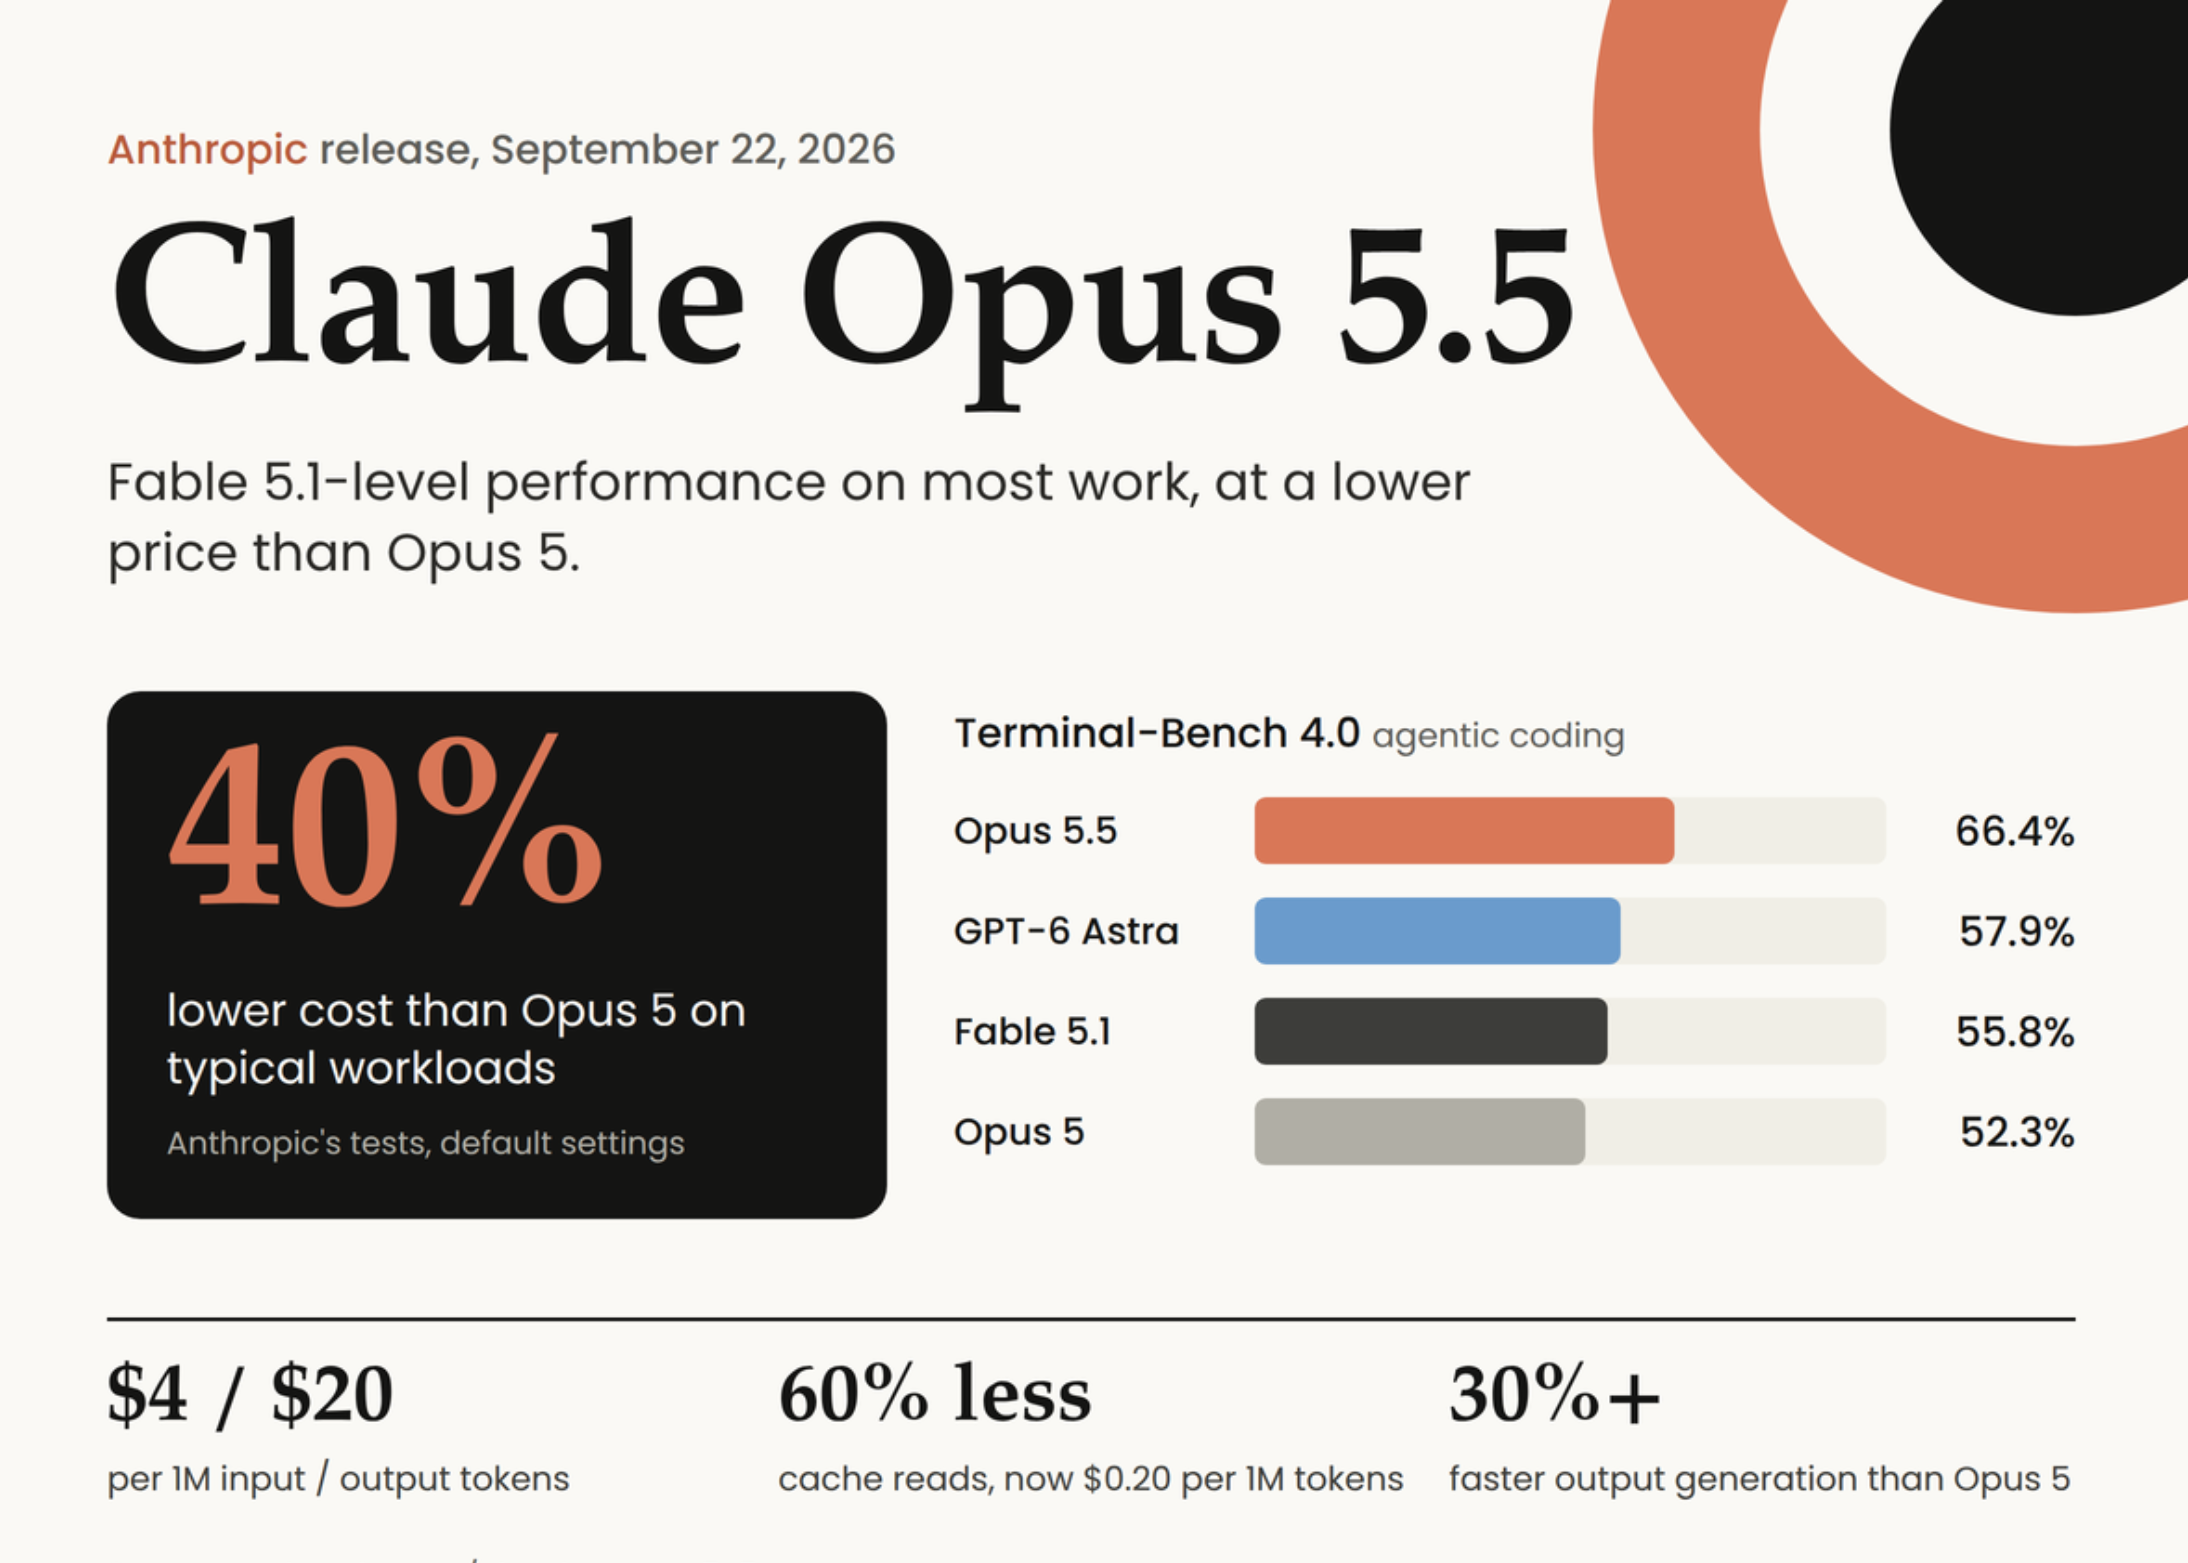
Anthropicが新しい文章AI「Claude Opus 5.5」を発表。以前の高性能版と同等の能力を持ちながら、動かす費用が40%安くなり、AI利用のコストが大幅に下がります。
Anthropicは、新しいClaude 5.5ファミリーの最初のモデルであるClaude Opus 5.5をリリースしました。 チームは、ほとんどの作業においてClaude Fable 5.1レベルのパフォーマンスを発揮すると述べています。また、デフォルト設定での一般的なワークロードにおいて、Opus 5よりも実行コストが40%低くなります。 Anthropic独自のベンチマークでは、agentic coding、computer use、およびknowledge workでリードしています。 展開可能か?はい、マネージドAPIモデルとして利用可能です。Anthropicはウェイトを公開していないため、セルフホスティングは選択肢ではありません。開発者は、Claude Platform、Amazon Web Services、Google Cloud、およびMicrosoft Azureでclaude-opus-5-5を呼び出すことができます。以前のOpusモデルと同様に、Zero data retentionが利用可能です。 強いリード、しかし完全な勝利ではない Opus 5.5のスコアは、最大努力での適応的思考を使用し、本番環境のセーフガードが有効になっています。 Benchmark Opus 5.5 Fable 5.1 Opus 5 GPT-6 Astra Terminal-Bench 4.0 66.4% 55.8% 52.3% 57.9% FrontierCode v1.1 54.4% 50.3% 48.0% 53.3% CursorBench 4.0 57.8% 51.8% 46.6% n/r GDPval-AA v2.1 (Elo) 1846 1735 1708 1542 OSWorld 2.0 81.8% 80.7% 74.0% n/r Terminal-Bench-Science 0.1 58.7% 52.6% 29.0% 64.6% AutomationBench 40.0% 31.4% 26.9% 41.4% Terminal-Bench 4.0は、Opus 5.5でxhigh effortで報告されています。GPT-6 Astraは、Terminal-Bench-ScienceとAutomationBenchで依然としてリードしています。Zapierは、フォールバックモデルなしでAutomationBenchを実行したため、セーフガードの介入は失敗としてカウントされました。 Anthropicはまた、ベンチマークのマージンが信頼性の低い指標になりつつあると警告しています。同社の使用では、Fable 5.1との差はスコアが示唆するよりも狭いとのことです。 コスト調整後の結果はより説得力があります。デフォルト(medium)effortでは、Opus 5.5はFrontierCodeで54.6%を記録します。これは、タスクあたりのコストが約5分の1で、GPT-6 Astraの最高スコア53.3%を上回ります。CursorBenchでは、medium effortで52.5%を記録します。これは、GPT-5.6 Solの最高スコアを11ポイント上回り、コストは約3分の1です。 価格と速度 Opus 5.5はOpus 5よりも提供に必要なcomputeが少なく、価格もそれを反映しています。 100万トークンあたり Opus 5.5 Opus 5 Input $4 $5 Output $20 $25 Cache reads $0.20 $0
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。