AIモデルの保存形式 GGUFなど比較
GGUF vs GPTQ vs AWQ vs EXL2: LLM Model Formats Explained (2026)
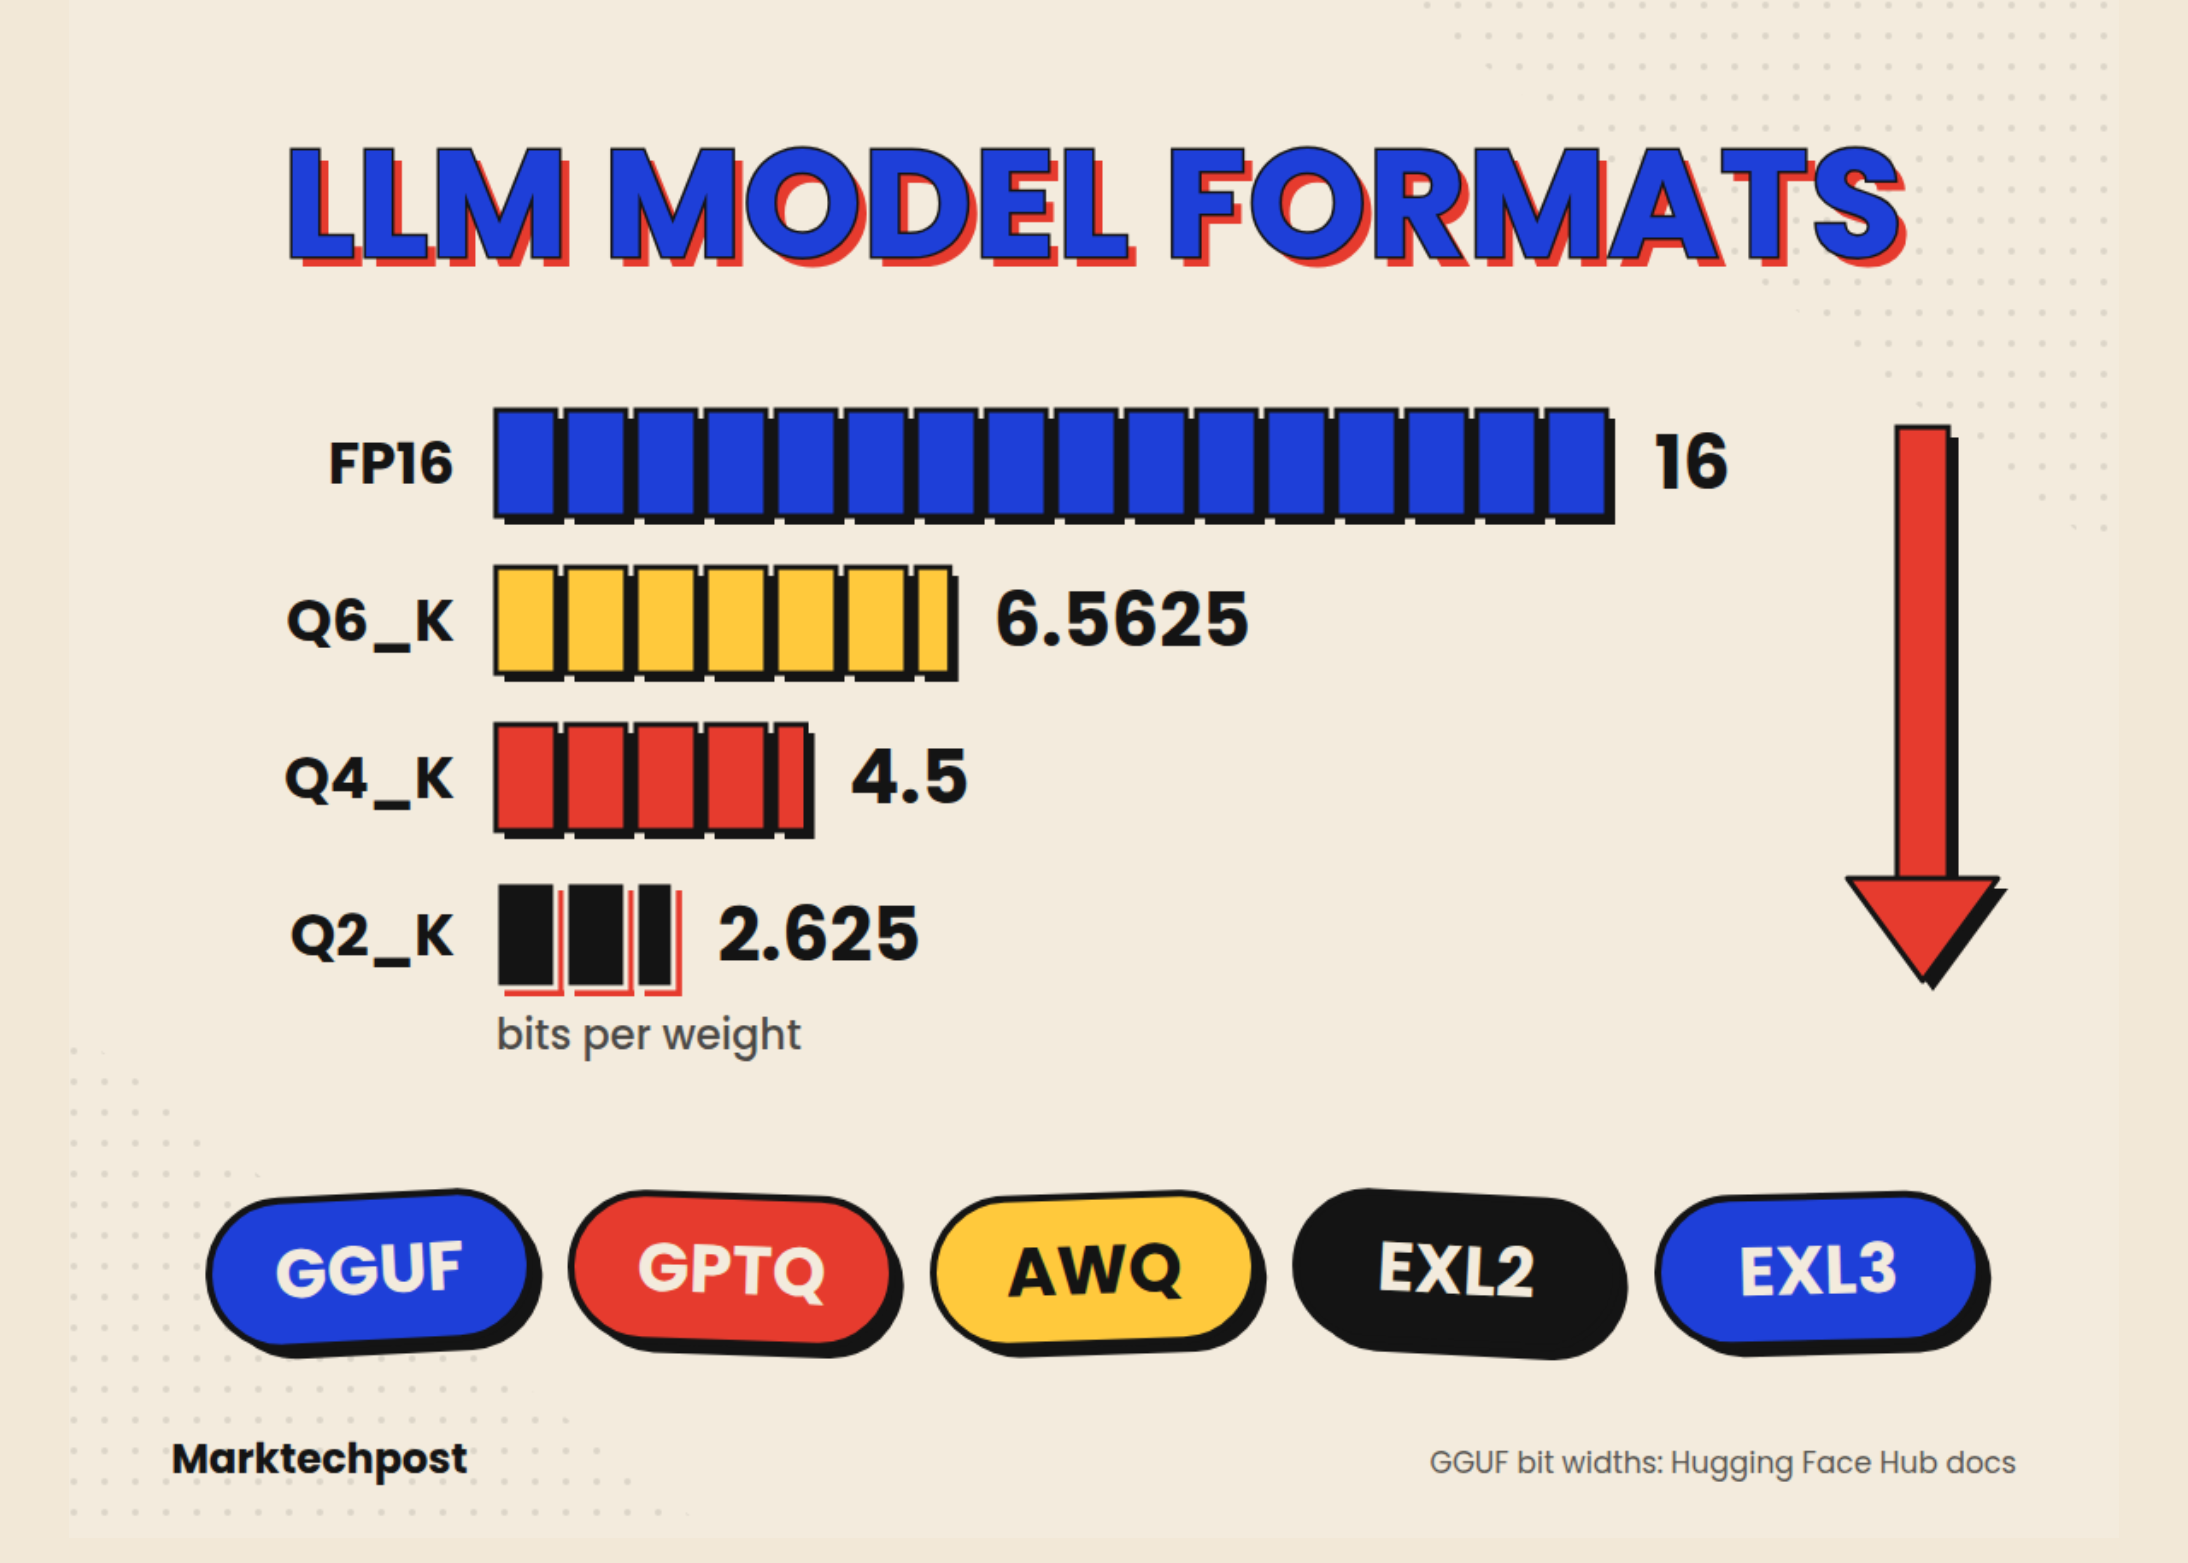
AIモデルのデータ形式であるGGUFやGPTQなどが、保存方法と圧縮方法の2つの視点から解説されました。これにより、AIを効率的に動かすための最適な形式選びに役立ちます。
まず、2つの考え方を区別します。コンテナと量子化手法です。ほとんどの混乱は、この2つの層を混同することから生じます。コンテナは、テンソルがディスク上にどのように保存されるかを定義します。量子化手法は、重みがより少ないビットにどのように圧縮されるかを定義します。コンテナ: safetensors、GGUF、PyTorch pickle ( .bin / .pt )。手法: GPTQ、AWQ、bitsandbytes NF4、llama.cpp K-quantsおよびI-quants。両方を兼ねるもの: EXL2とEXL3は、単一の推論ライブラリに結びついた手法とストレージレイアウトを組み合わせたものです。これらは算術的なものであり、ベンダーのベンチマークではありません。これは重みのみを対象としています。KV cacheとランタイムオーバーヘッドがさらに追加されます。メモリの簡単な経験則: 重みメモリ ≈ パラメータ数 × 1重みあたりのビット数 ÷ 8。モデル 16-bit ~4.5 bits per weight 8B ~16 GB ~4.5 GB 70B ~140 GB ~39 GB。これは算術的なものであり、ベンダーのベンチマークではありません。これは重みのみを対象としています。KV cacheとランタイムオーバーヘッドがさらに追加されます。1. フル精度: safetensorsとPyTorch .bin。量子化されていないモデルは通常、pytorch_model.binまたはmodel.safetensorsのいずれかで16-bitの重みとして提供されます。古い .bin / .pt ファイルはPython pickleを使用します。pickleファイルをロードすると任意のコードが実行される可能性があり、信頼できないチェックポイントはセキュリティリスクとなります。Hugging Faceで作成されたSafetensorsは、そのリスクを取り除きます。ファイルは小さなJSONヘッダーと生テンソルバッファで構成され、内部に実行可能なものは何もありません。テンソルはメモリマップされ、ファイル全体を読み込むことなく一度に1つずつロードできます。Safetensorsは現在、PyTorch Foundationプロジェクトとしてリストされています。重要なニュアンス: ほとんどのGPTQ、AWQ、EXL2、EXL3、およびMLXモデルも .safetensors ファイルに保存されます。量子化はテンソルの内容と設定ファイル内にあり、新しいコンテナ内にあるわけではありません。2. GGUF (llama.cpp)。GGUFとは: GGUFは、GGMLおよびllama.cppのようなGGMLベースのエグゼキュータでモデルを実行するためのバイナリ形式です。これはGeorgi Gerganovによって作成されました。彼はllama.cppも率いています ( Hugging Face docs )。これは2023年8月21日に、古いGGML形式の代替として導入されました。なぜGGMLを置き換えたのか: 古いGGML、GGMF、GGJTファイルは、モデルがどのアーキテクチャに属しているかを指定できませんでした。新しいハイパーパラメータを追加すると、既存のすべてのファイルが壊れていました。GGUFは型付きキーバリューメタデータに切り替わりました
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。