AIが動画監督、長い動画を生成
Google Research Introduces an AI Video Co-Director: 4 Agentic Frameworks for Coherent, Minutes-Long Video Generation
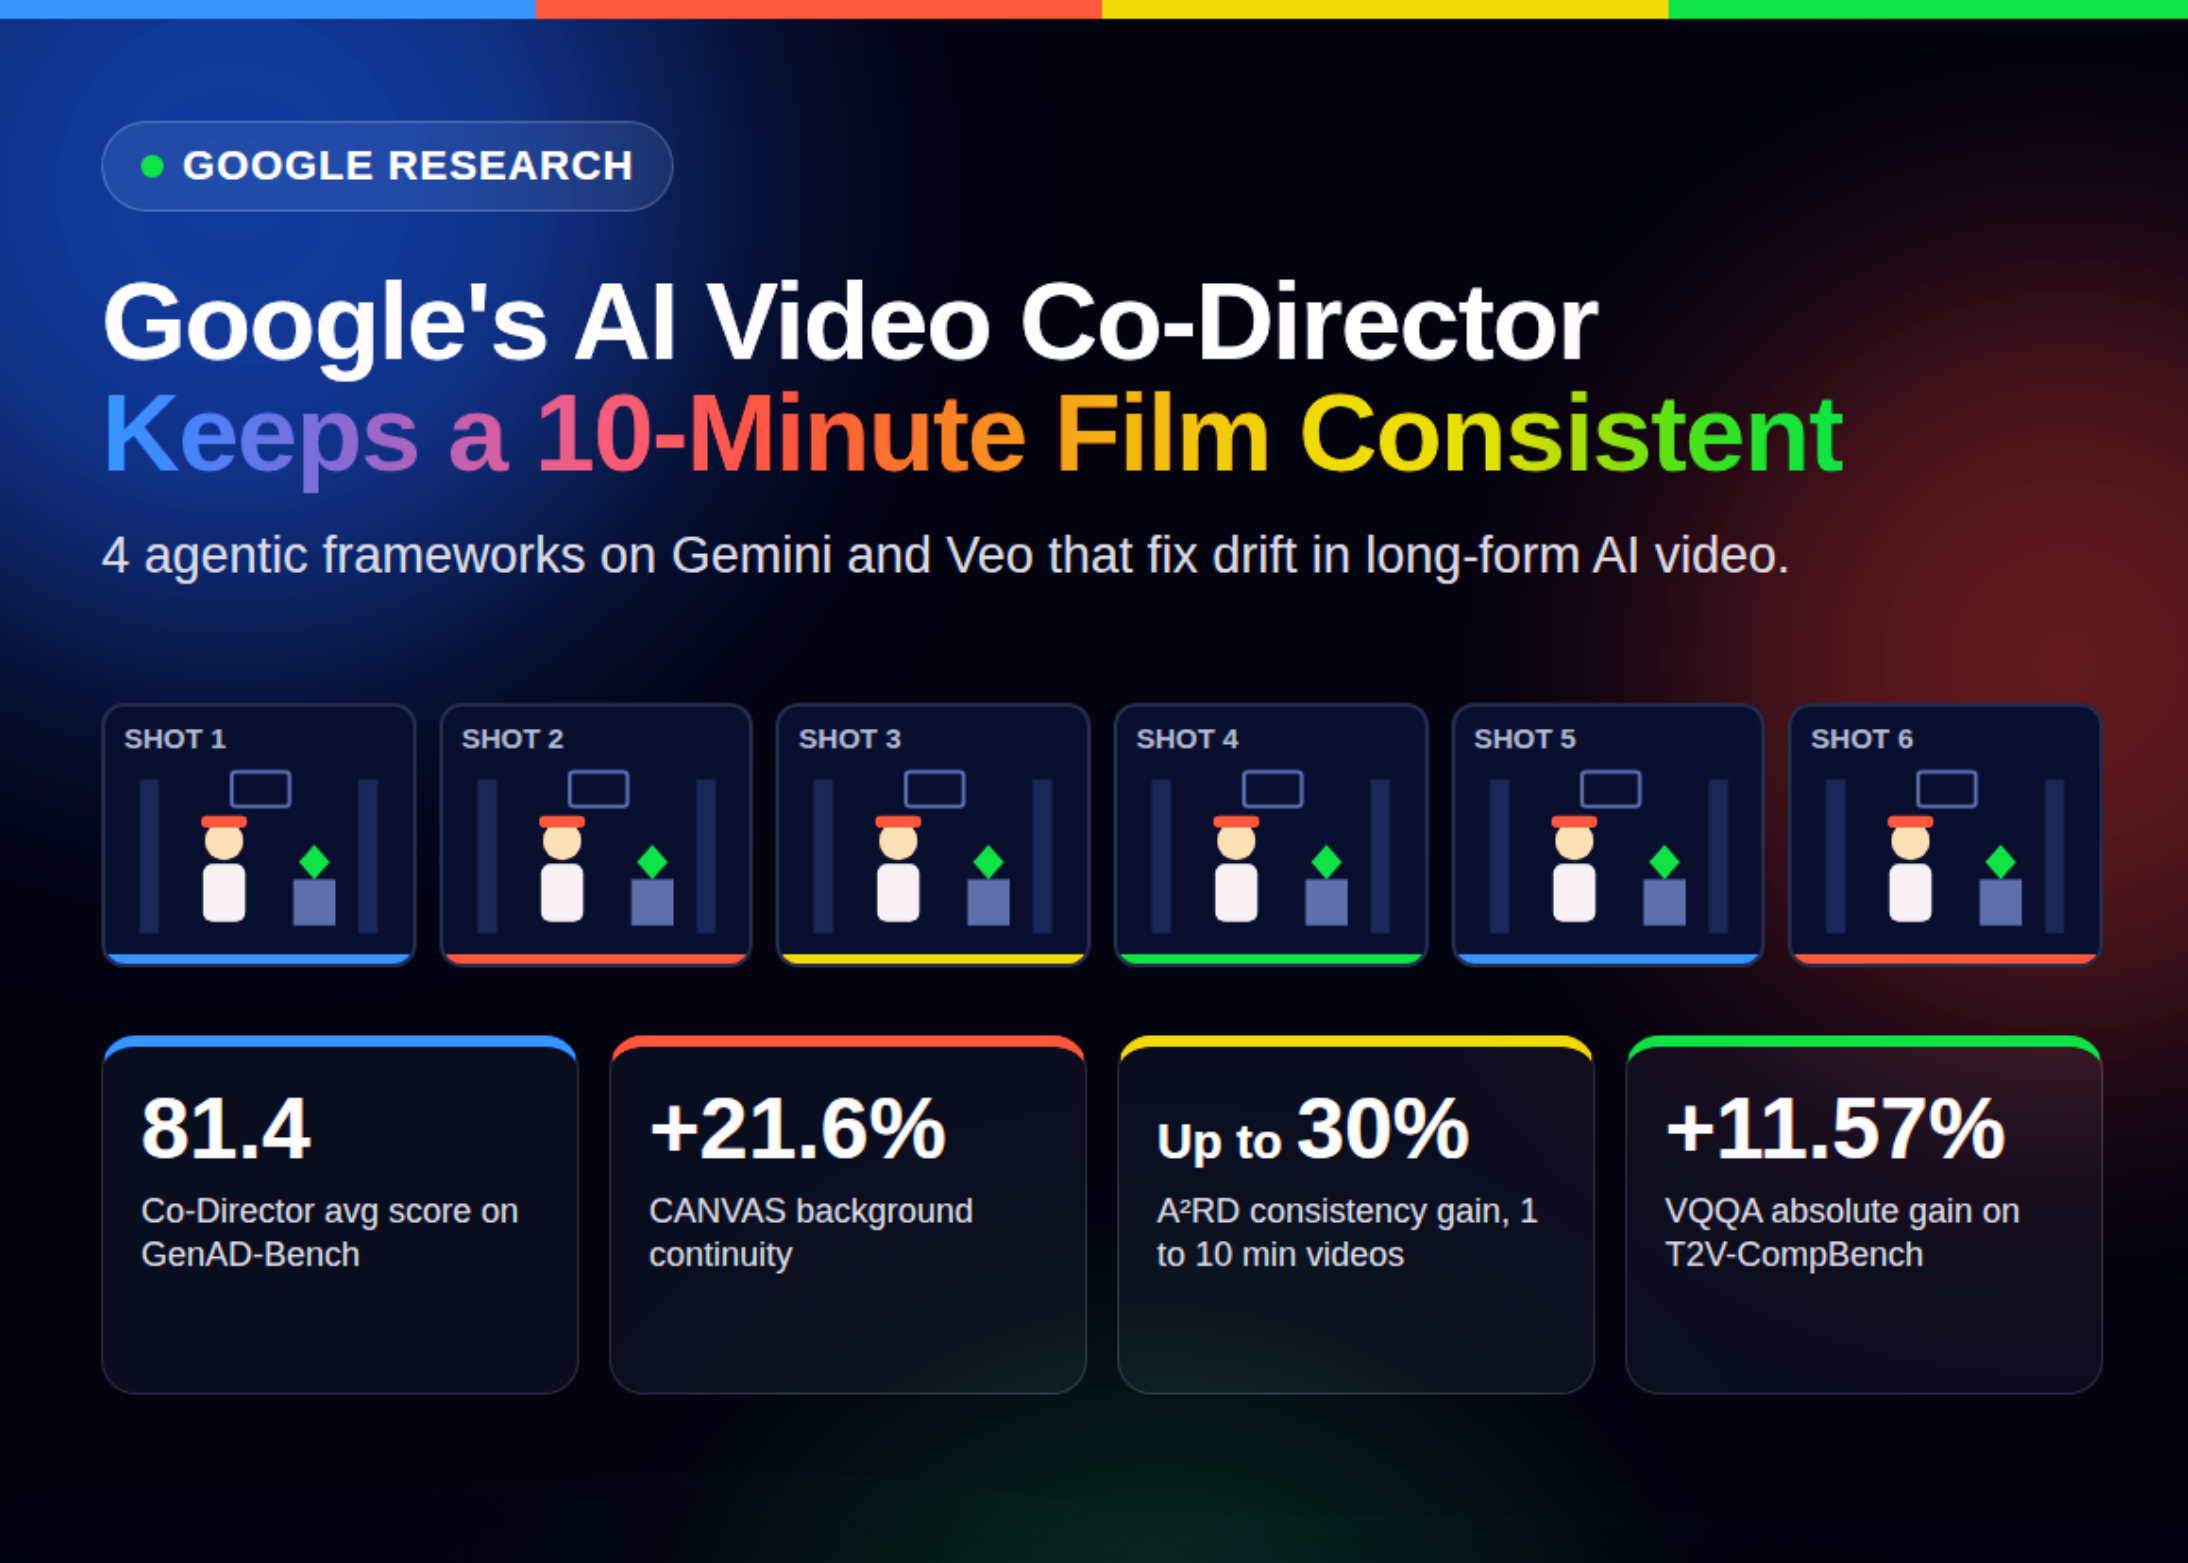
GoogleがAIに動画監督の役割を与え、登場人物や背景がブレない数分間の長尺動画を自動で作れるようにしたことで、AI動画生成の大きな課題を解決しました。
Google Researchは、長尺動画生成のためのAI動画共同監督システムを発表しました。この4つのagentic frameworksのスイートは、短いクリップを数分間のまとまりのある物語に変えます。これは、今日のほとんどのマルチショットAI動画パイプラインを破綻させる2つの失敗、identity drift(登場人物などの一貫性の喪失)とcascading errors(連鎖的なエラー)をターゲットとしています。なぜAIの長尺動画は破綻するのかDiffusion modelsは数秒で高精細なクリップを生成します。それらのクリップを物語に繋ぎ合わせるのはより困難です。ほとんどのagentic pipelinesは、独立した手作りのプロンプトを持つモジュールを連鎖させます。これにより、semantic drift(意味的なずれ)が生じ、ショット間で服装や風景が変化してしまいます。また、cascading failures(連鎖的な失敗)も引き起こし、1つの悪い上流のアセットがその後のすべてのショットを台無しにしてしまいます。Googleチームはこれをcredit assignment problem(原因帰属問題)として捉えています。破綻した最終動画の原因となったプロンプトを特定することは困難です。AI動画共同監督システムはどのように機能するかこのシステムはGeminiとVeoの上に構築されています。model-agnostic(モデルに依存しない)であるため、同じレイヤーで他のジェネレーターを駆動することも可能です。出力は、ベースモデルからSynthID watermarkingを継承します。1. Co-Director: バンディット探索としてのクリエイティブ計画COLM 2026で採択されたCo-Directorは、multi-armed bandit (MAB)を使用します。Orchestrator AgentがCreative Strategy、Narrative Mode、Aesthetic Archetypeにわたる構成を選択します。Pre-Production Agentがストーリーボードを構築します。Keyframe、Video、Audioの各sub-agentsがメディアを生成します。その後、MLLM Judgeがカットを評価し、factored rewardをバンディットに送り返します。2. CANVAS: 永続的な視覚記憶EMNLP 2026で採択されたCANVASは、物語の展開に合わせて登場人物、場所、オブジェクトの状態を追跡します。シーンが戻ってきたときには、保存された視覚的なアンカーを呼び出します。Googleの美術館強盗テストでは、AutoStudioは泥棒の帽子を失い、Gemini-3.1-Proは宝石を変更してしまいましたが、CANVASは両方の一貫性を保ちました。3. A²RD: セグメントごとの長尺動画A²RD (Agentic Autoregressive Diffusion)は、training-free(学習不要)なアーキテクチャです。各セグメントは、multimodal video memoryに対してRetrieve、Synthesize、Refine、Updateのループを実行します。エージェントは、extr
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。