MSがAI開発ツールを公開
Microsoft Open-Sources TauGrid: A Kubernetes-Native Stack for GPU AI Workloads
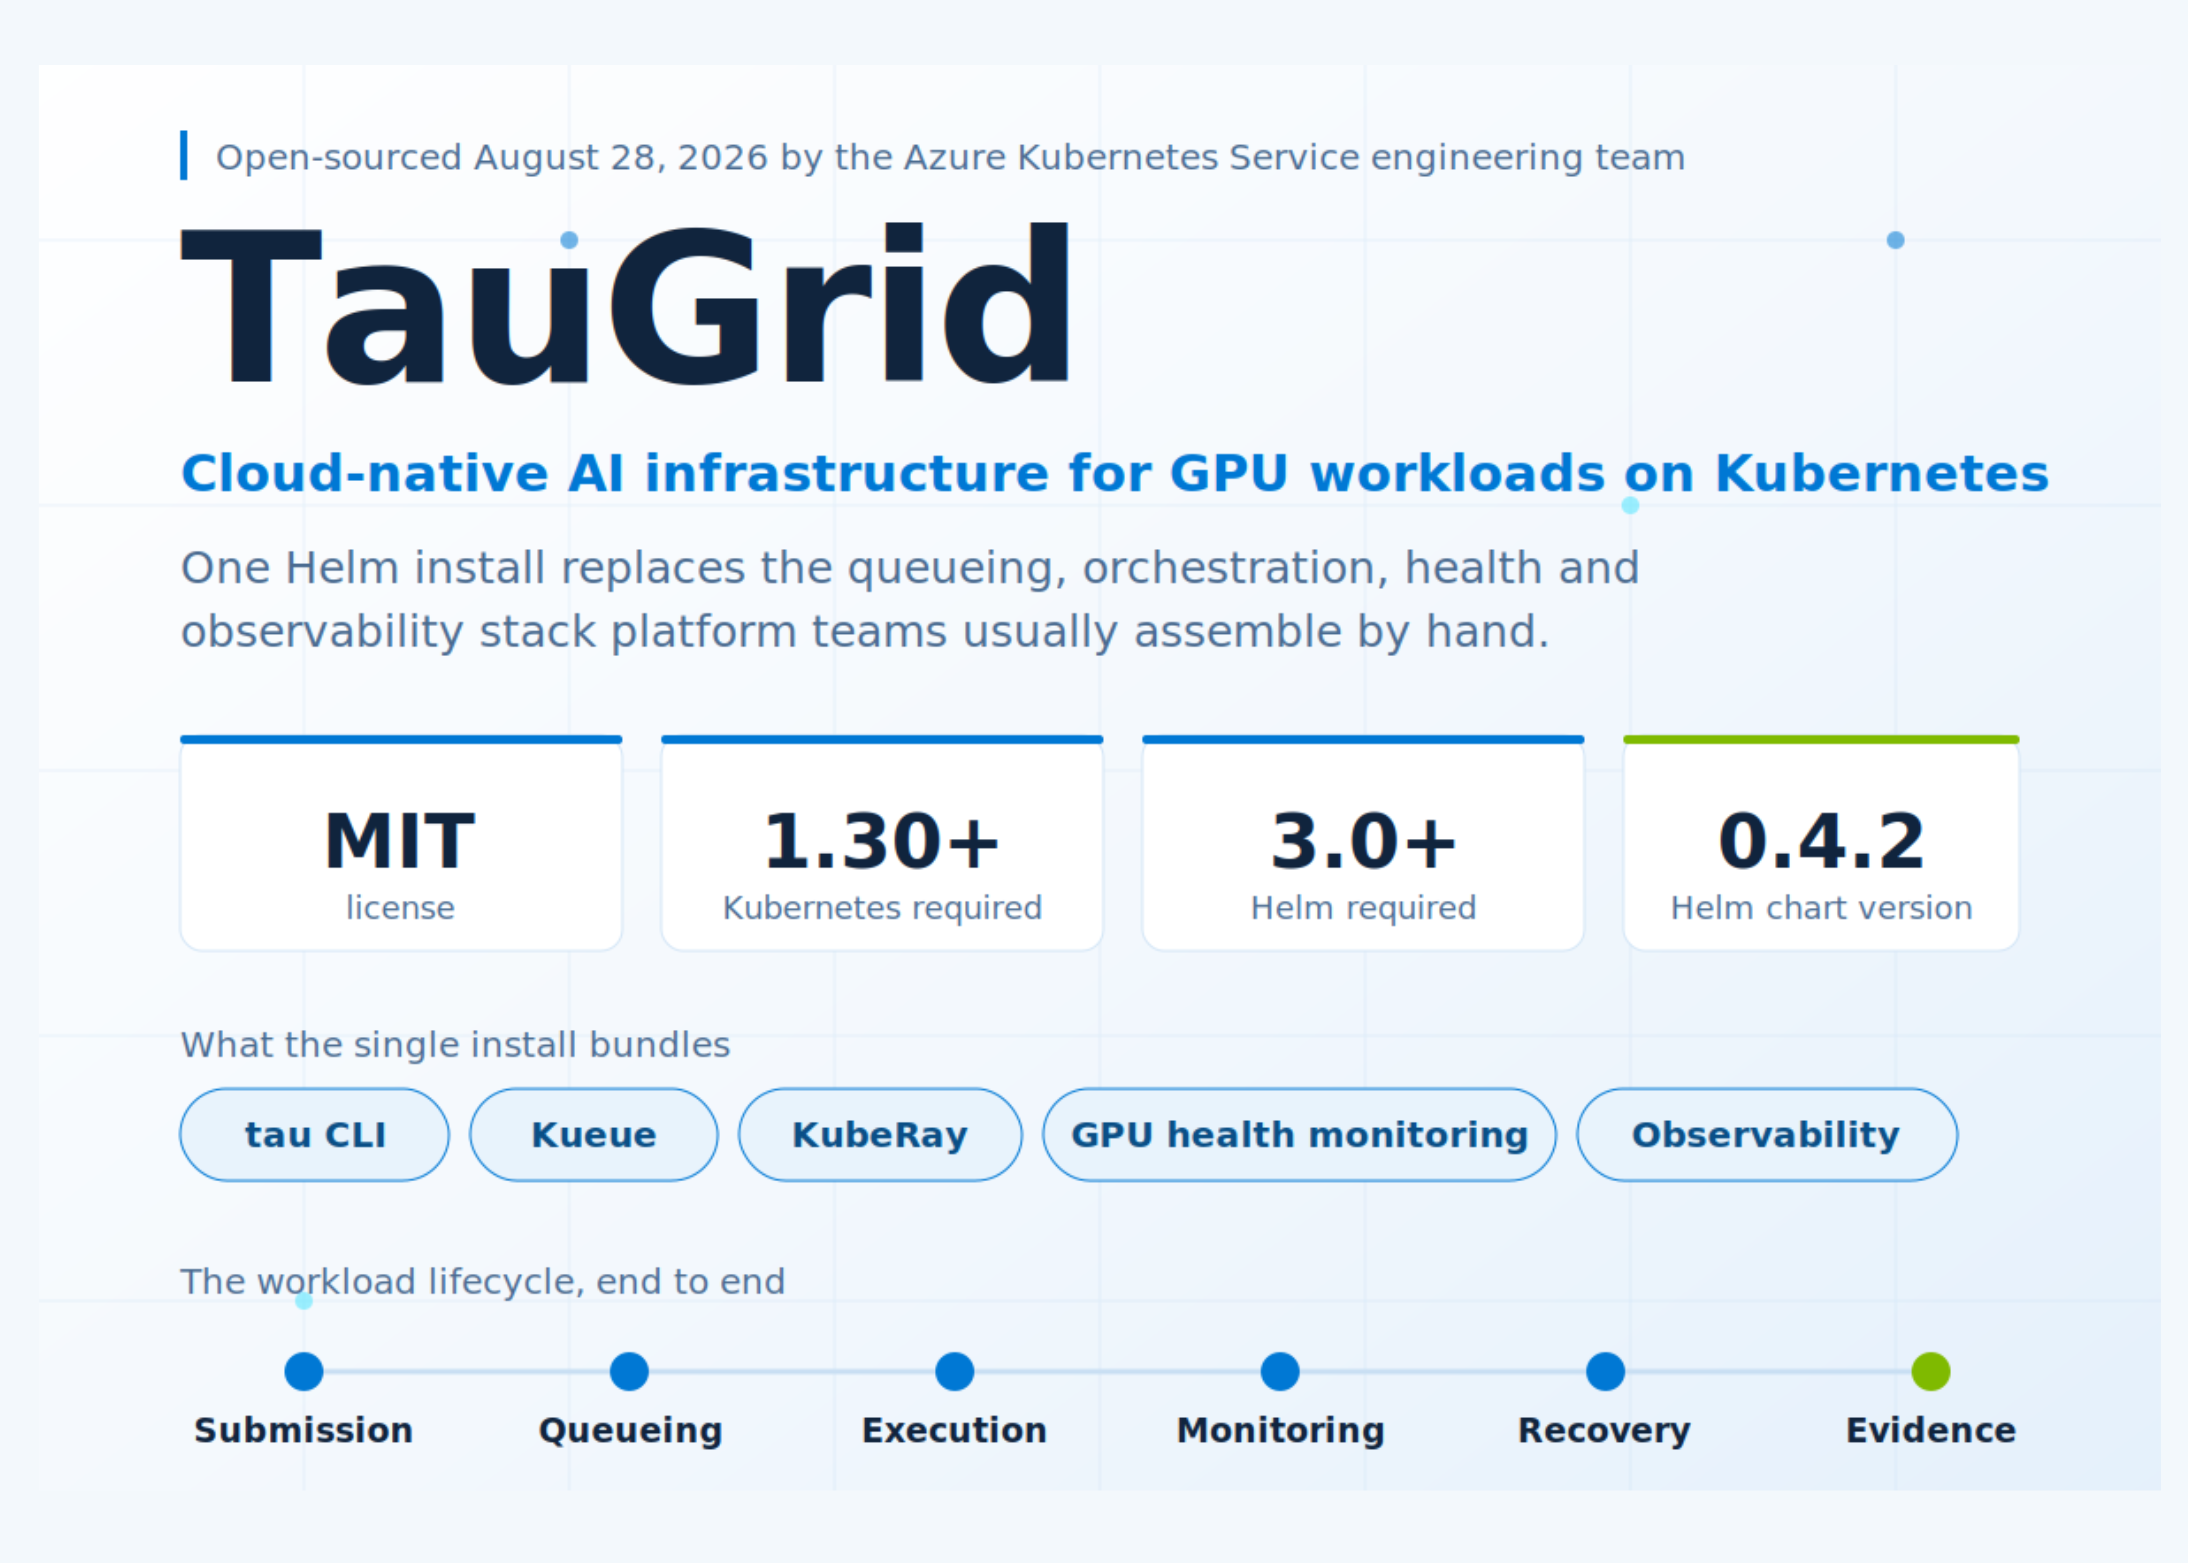
MicrosoftがAI開発を効率化する「TauGrid」を公開。KubernetesでのAI運用を簡素化し、開発者がより簡単にAIを動かせるようになるため重要です。
Kubernetes上でAIを運用するプラットフォームチームは、めったに一つのことだけを運用することはありません。彼らはキューイングシステム、分散ランタイム、GPUノードのヘルスチェック、ダッシュボード、そしてそれらすべてをまとめる提出スクリプトの層を運用しています。Azure Kubernetes Serviceのエンジニアリングチームは、その組み立て作業を単一のHelmインストールにまとめるTauGridをオープンソース化しました。 展開可能ですか?はい、TauGridはMITライセンスで、コンテナイメージとHelmチャートはMicrosoft Container Registryで公開OCIアーティファクトとして公開されています。前提条件は、GPUノードを備えたKubernetes 1.30+クラスター、kubectl、およびHelm 3.0以降です。 TauGridとは何か TauGridは、Kubernetes上でAIワークロードを実行するための自己ホスト型プラットフォームです。これは、プラットフォームチームが通常手動で統合する5つの要素を組み合わせています:tau CLI、Kueueによるワークロードのキューイングとアドミッション、KubeRayによるRayクラスターオーケストレーション、ノードレベルのGPUヘルスモニタリング、およびクラスターとワークロードの可観測性です。 責任の分割が設計のポイントです。プラットフォームチームはワークスペース、キュー、計算プロファイル、ストレージ、ID、および可観測性を所有します。研究者はリポジトリとCLIから作業し、Kubernetesを直接設定することなくワークロードを提出します。コードベースは主にGoで書かれています。 ジョブがどのように処理されるか ワークロードはtau.yamlファイルで記述されます。Microsoftが公開しているGPUトレーニングの例では、単一のA100上でPyTorchジョブを実行します。 Copy Code Copied Use a different Browser schema_version: 1 name: aks-gpu-quickstart run: entrypoint: train.py workload_kind: rayjob compute: gpus: 1 workers: 1 cpus: 16 memory: 64Gi runtime: image: mcr.microsoft.com/aks/ai-runtime/ray:py3.12-ray2.56.0-cuda13.0 pip: - torch>=2.4.0 tau runを実行すると、TauGridはプラットフォームポリシーを解決し、Kubernetes JobまたはKubeRay RayJobをレンダリングし、Kueueを通じてそれを提出します。Microsoftが文書化している6つのステージは、提出、キューイング、実行、モニタリング、リカバリ、およびエビデンスです。リカバリには、リトライ、チェックポイントからの再開、および障害診断が含まれます。エビデンスレコードはワークロードのメタデータをキャプチャします。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。