NVIDIA、AI計算にRust導入
NVIDIA Announces CUDA Rust with cuda-oxide (SIMT) and cutile-rs (Tile) for Compile-Time-Safe GPU Kernels
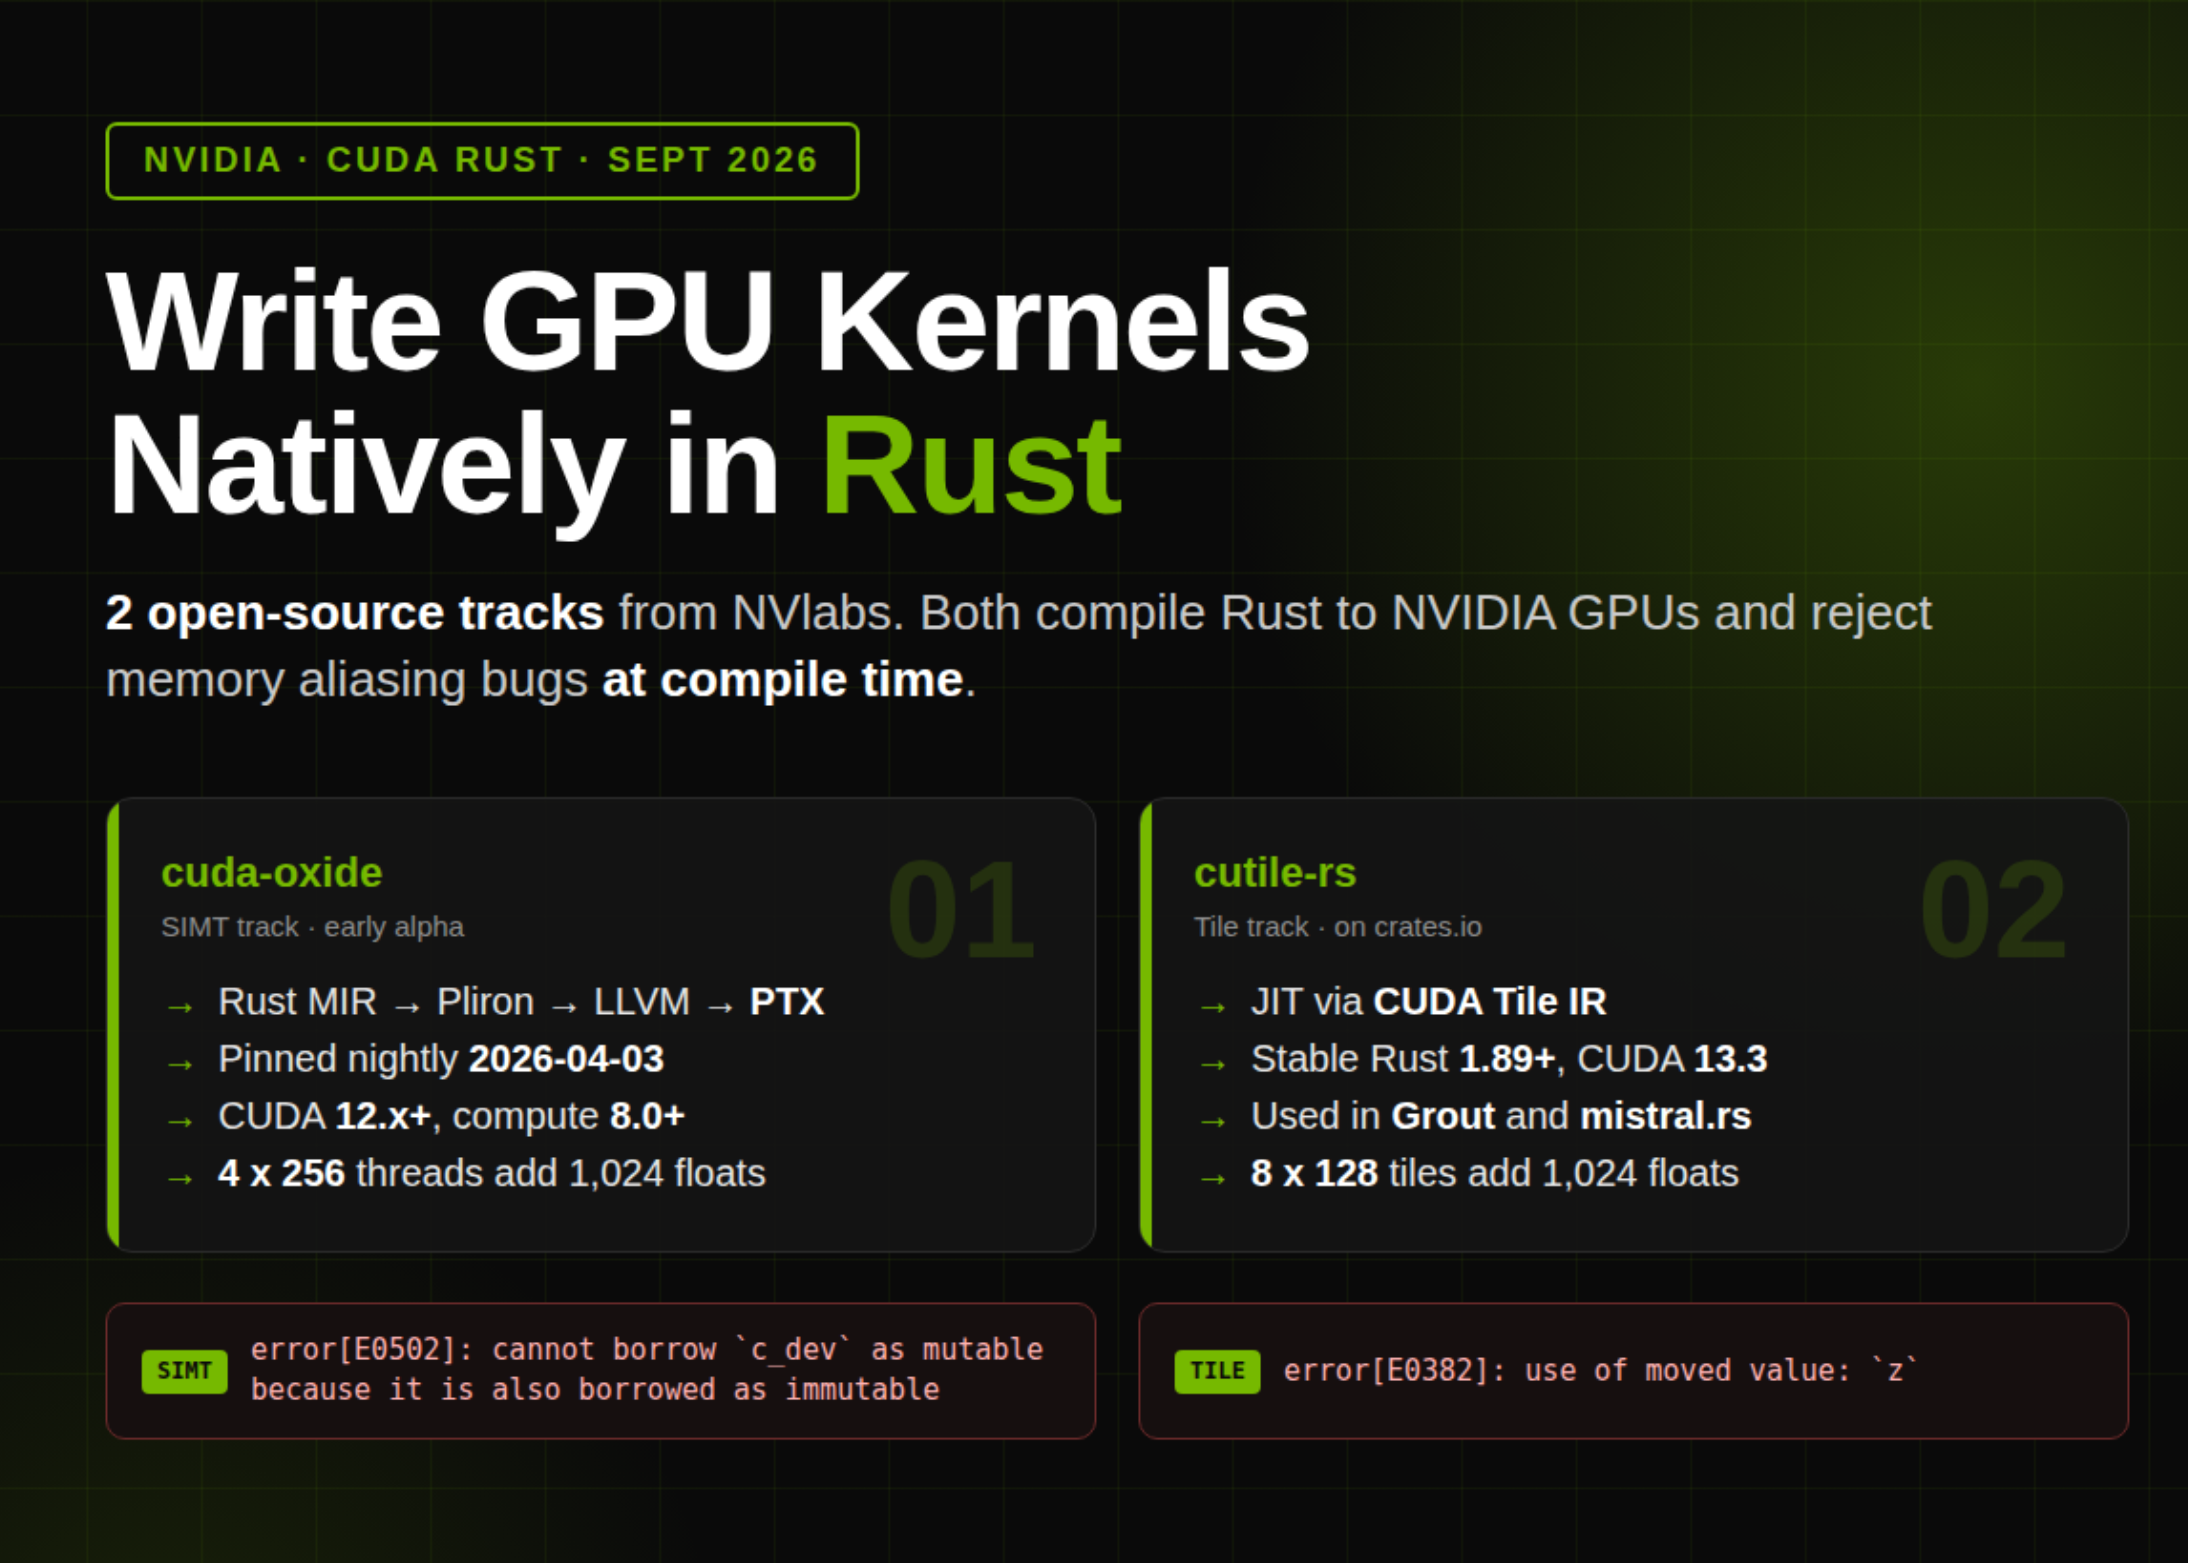
NVIDIAがAIの計算処理をRust言語で直接書けるようにしたことで、AIプログラム開発の安全性が高まり、間違いが減る可能性があります。
NVIDIAは、RustをGPU(AIの計算を行う部品)のプログラム(カーネル)を書くための主要な言語にする取り組みであるCUDA Rustを発表しました。RustコードはすでにCUDAカーネルを起動できましたが、カーネル本体は通常、他の場所で書く必要がありました。CUDA Rustは、NVlabsの2つのオープンソースプロジェクト、SIMTモデル用のcuda-oxideと、新しいTileモデル用のcutile-rsによって、そのギャップを埋めます。どちらもRustカーネルをネイティブにコンパイルし、Rustの所有権ルールを使用して、コンパイル時にエイリアシングバグを拒否します。これは展開可能でしょうか?部分的です。cutile-rsはcrates.ioで公開されており、安定版Rust 1.89+で動作し、Hugging FaceのGrout推論エンジンやmistral.rsですでに使用されています。cuda-oxideは初期のアルファ版です。両プロジェクトともアルファ段階であり、本番環境での使用は確認されていません。なぜGPUカーネルにRustを使うのかAIのシステム層、推論エンジンからドライバー、エージェントランタイムに至るまで、Rustで書かれることが増えています。NVIDIAのNova LinuxドライバーはRustで書かれており、NVIDIA DynamoはRustコアを持ち、NVTXにはRustバインディングがあります。GPUカーネルは例外でした。これら2つのトラックは、CUDAがすでに提供している2つのプログラミングモデルを反映しています。SIMTはCUDA C++やnumba-cudaで使用されているモデルです。1つのスレッドが何をするかを記述し、それを何千ものスレッドで起動します。Tileは新しいモデルで、C++やPythonでも利用できます。データの1つのタイルが何をするかを記述し、Tile IRコンパイラがスレッドマッピングとメモリレイアウトを処理します。NVIDIAは、明示的なスレッドとメモリ制御が必要な場合はSIMTを使用し、それ以外はTileを推奨しています。言語間の相互運用性が計画されているため、Rustを選択しても開発者がC++やPythonから締め出されることはありません。SIMTトラック: cuda-oxidecuda-oxideはカスタムのrustcコード生成バックエンドです。#[kernel]関数をRust MIR、コミュニティのPliron IRフレームワーク、LLVM IRを経由してPTXにルーティングし、それ以外のすべてを標準バックエンドに渡します。NVIDIAはPlironの上にGPU方言を作成しました。要件: Linux、compute capability 8.0以降のGPU、CUDA 12.x以降、libclang付きのclang、および固定されたnightly toolchain (nightly-2026-04-03)。cargo oxide doctor
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。