ロボット動かすAIが最高性能に
Black Forest Labs Releases FLUX 3 Action: A 7B Open-Weights World Action Model That Tops RoboLab-120
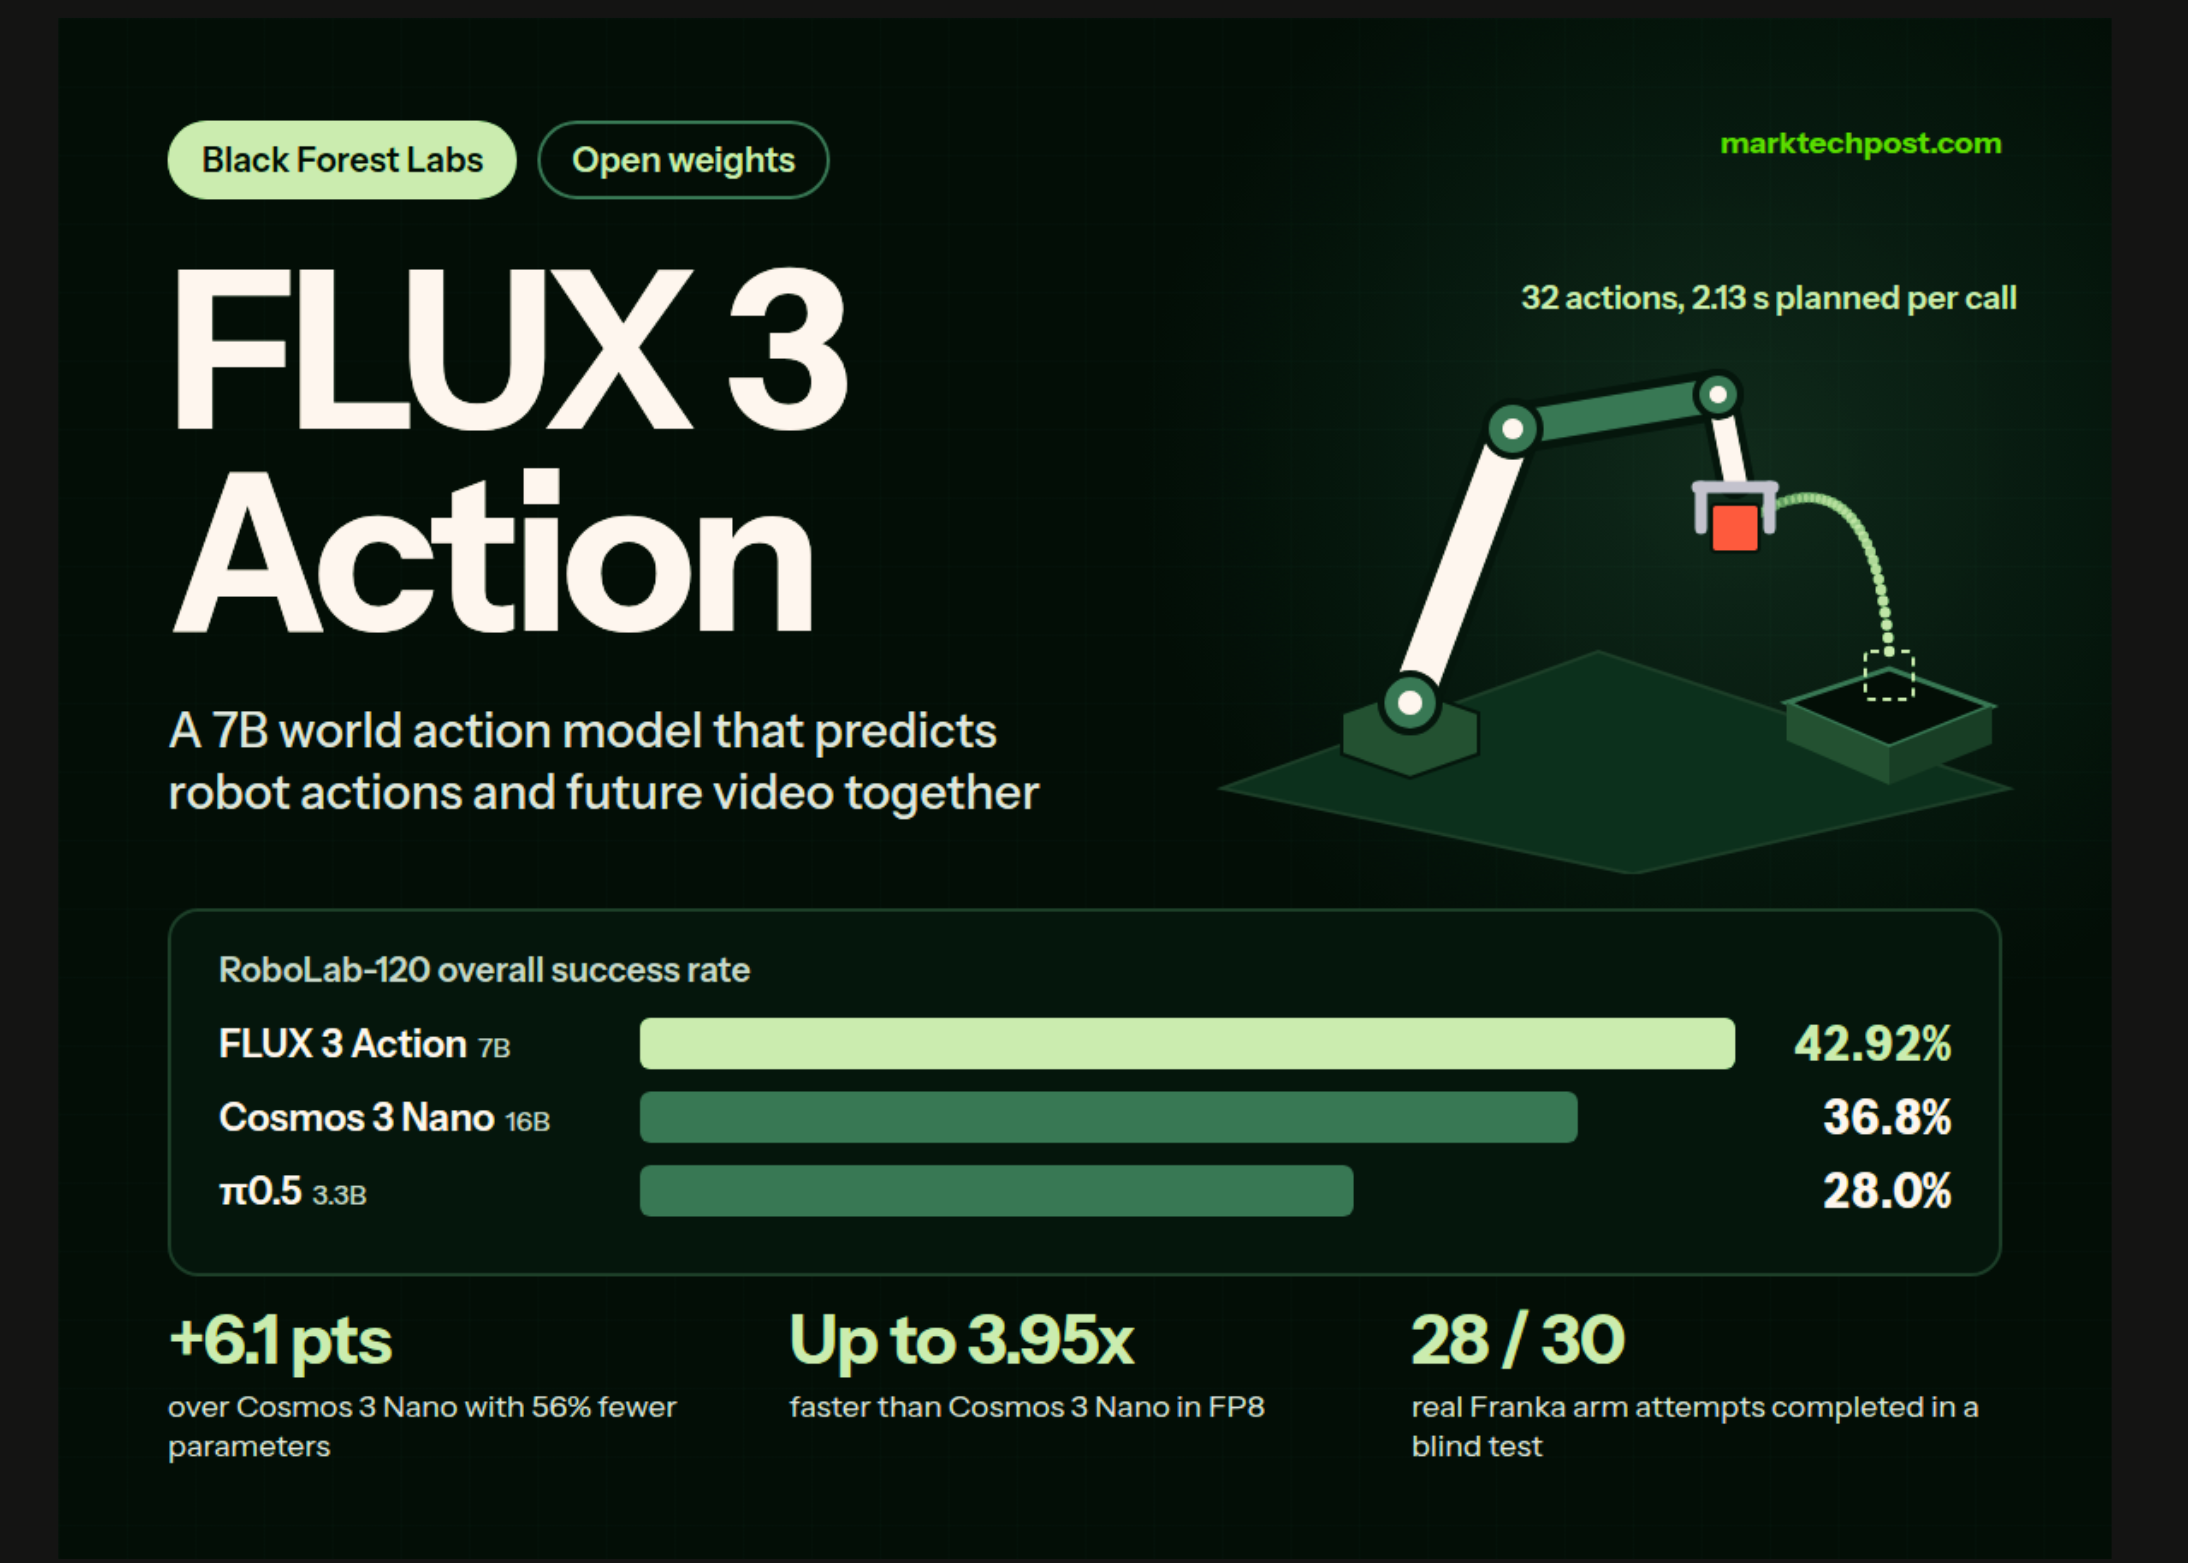
ロボットを動かすAI「FLUX 3 Action」が公開され、テストで42.92%の成功率でトップに。ロボットがより賢く動けるようになります。
Black Forest Labs (BFL)は、FLUX画像モデルを開発した研究室ですが、この度FLUX 3 Actionをリリースしました。これはロボット制御用の7BオープンウェイトWorld Action Model (WAM)です。このモデルは、カメラ映像、ロボットの状態、そしてテキスト指示を読み込みます。その後、将来のビデオフレームと次のアクションの塊を同時に予測します。RoboLab-120のリーダーボードでは、42.92%のタスク成功率で1位を獲得しています。 展開可能か?はい、条件付きで可能です。DROIDポリシーは、H200上でBF16の場合、約32GBのGPUメモリを必要とします。FP8量子化とテキストエンコーダーのオフロードを使用すれば、24GBのカードにも適合します。FLUX Kommunity Licenseは非商用利用を許可しています。 The Trade-off FLUX 3 Action Targets オープンなロボットポリシーは通常、選択を迫られます。NVIDIAのCosmos 3 NanoのようなWAMはRoboLabで36.8%の成績を収めますが、ビデオの予測はコストがかかります。π0.5のようなVLAは高速ですが、28.0%しか達成しません。B200上でBFLが測定したところ、Cosmos 3 Nano (FP8)は、ロボットの動き1秒あたりにπ0.5 (BF16)よりも約4.7倍の処理時間を必要としました。FLUX 3 Actionは、ビデオとアクションの同時予測を維持しています。BFLは、代わりに小型のバックボーンと蒸留によって速度のギャップを埋めています。 Architecture and Training FLUX 3 Actionは、マルチモーダルなFLUX 3バックボーンから派生しています。事前学習には画像、ビデオ、オーディオデータが使用され、ビデオがトレーニングトークンの95%以上を占めました。テキスト、ビデオ、ロボットの状態はトークンにエンコードされます。バックボーンの将来のトークンはビデオフレームにデコードされ、そのアクションのトークンはロボットのアクションにデコードされます。中間トレーニングでは、事前学習データ(サンプルの36.95%)とアクションに合わせたビデオ(63.05%)が混合されました。アクションデータには、ゲームの記録、一人称視点の人間の手のビデオ、ハンドヘルドグリッパー、14のエンボディメントにわたる遠隔操作が含まれていました。ほとんどのロボットデータは、EE50と呼ばれる共有の50次元エンドエフェクターアクション空間を使用しています。事前学習はここで非常に重要です。事前学習なしでは、DROIDのみのトレーニングはRoboLabで1%未満にとどまりました。事前学習を行うと、同じプロトコルで11.6%に達しました。 Benchmark Results RoboLab-120は、Isaac Sim内の120の卓上タスクで構成されており、DROIDスタイルのFrankaセットアップで各タスク10回の試行が行われます。M
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。