Google、AIが動画を賢く理解
Google Launches Agentic Video Understanding for Gemini Flash Models, Cutting Video Tokens by Up to 88%
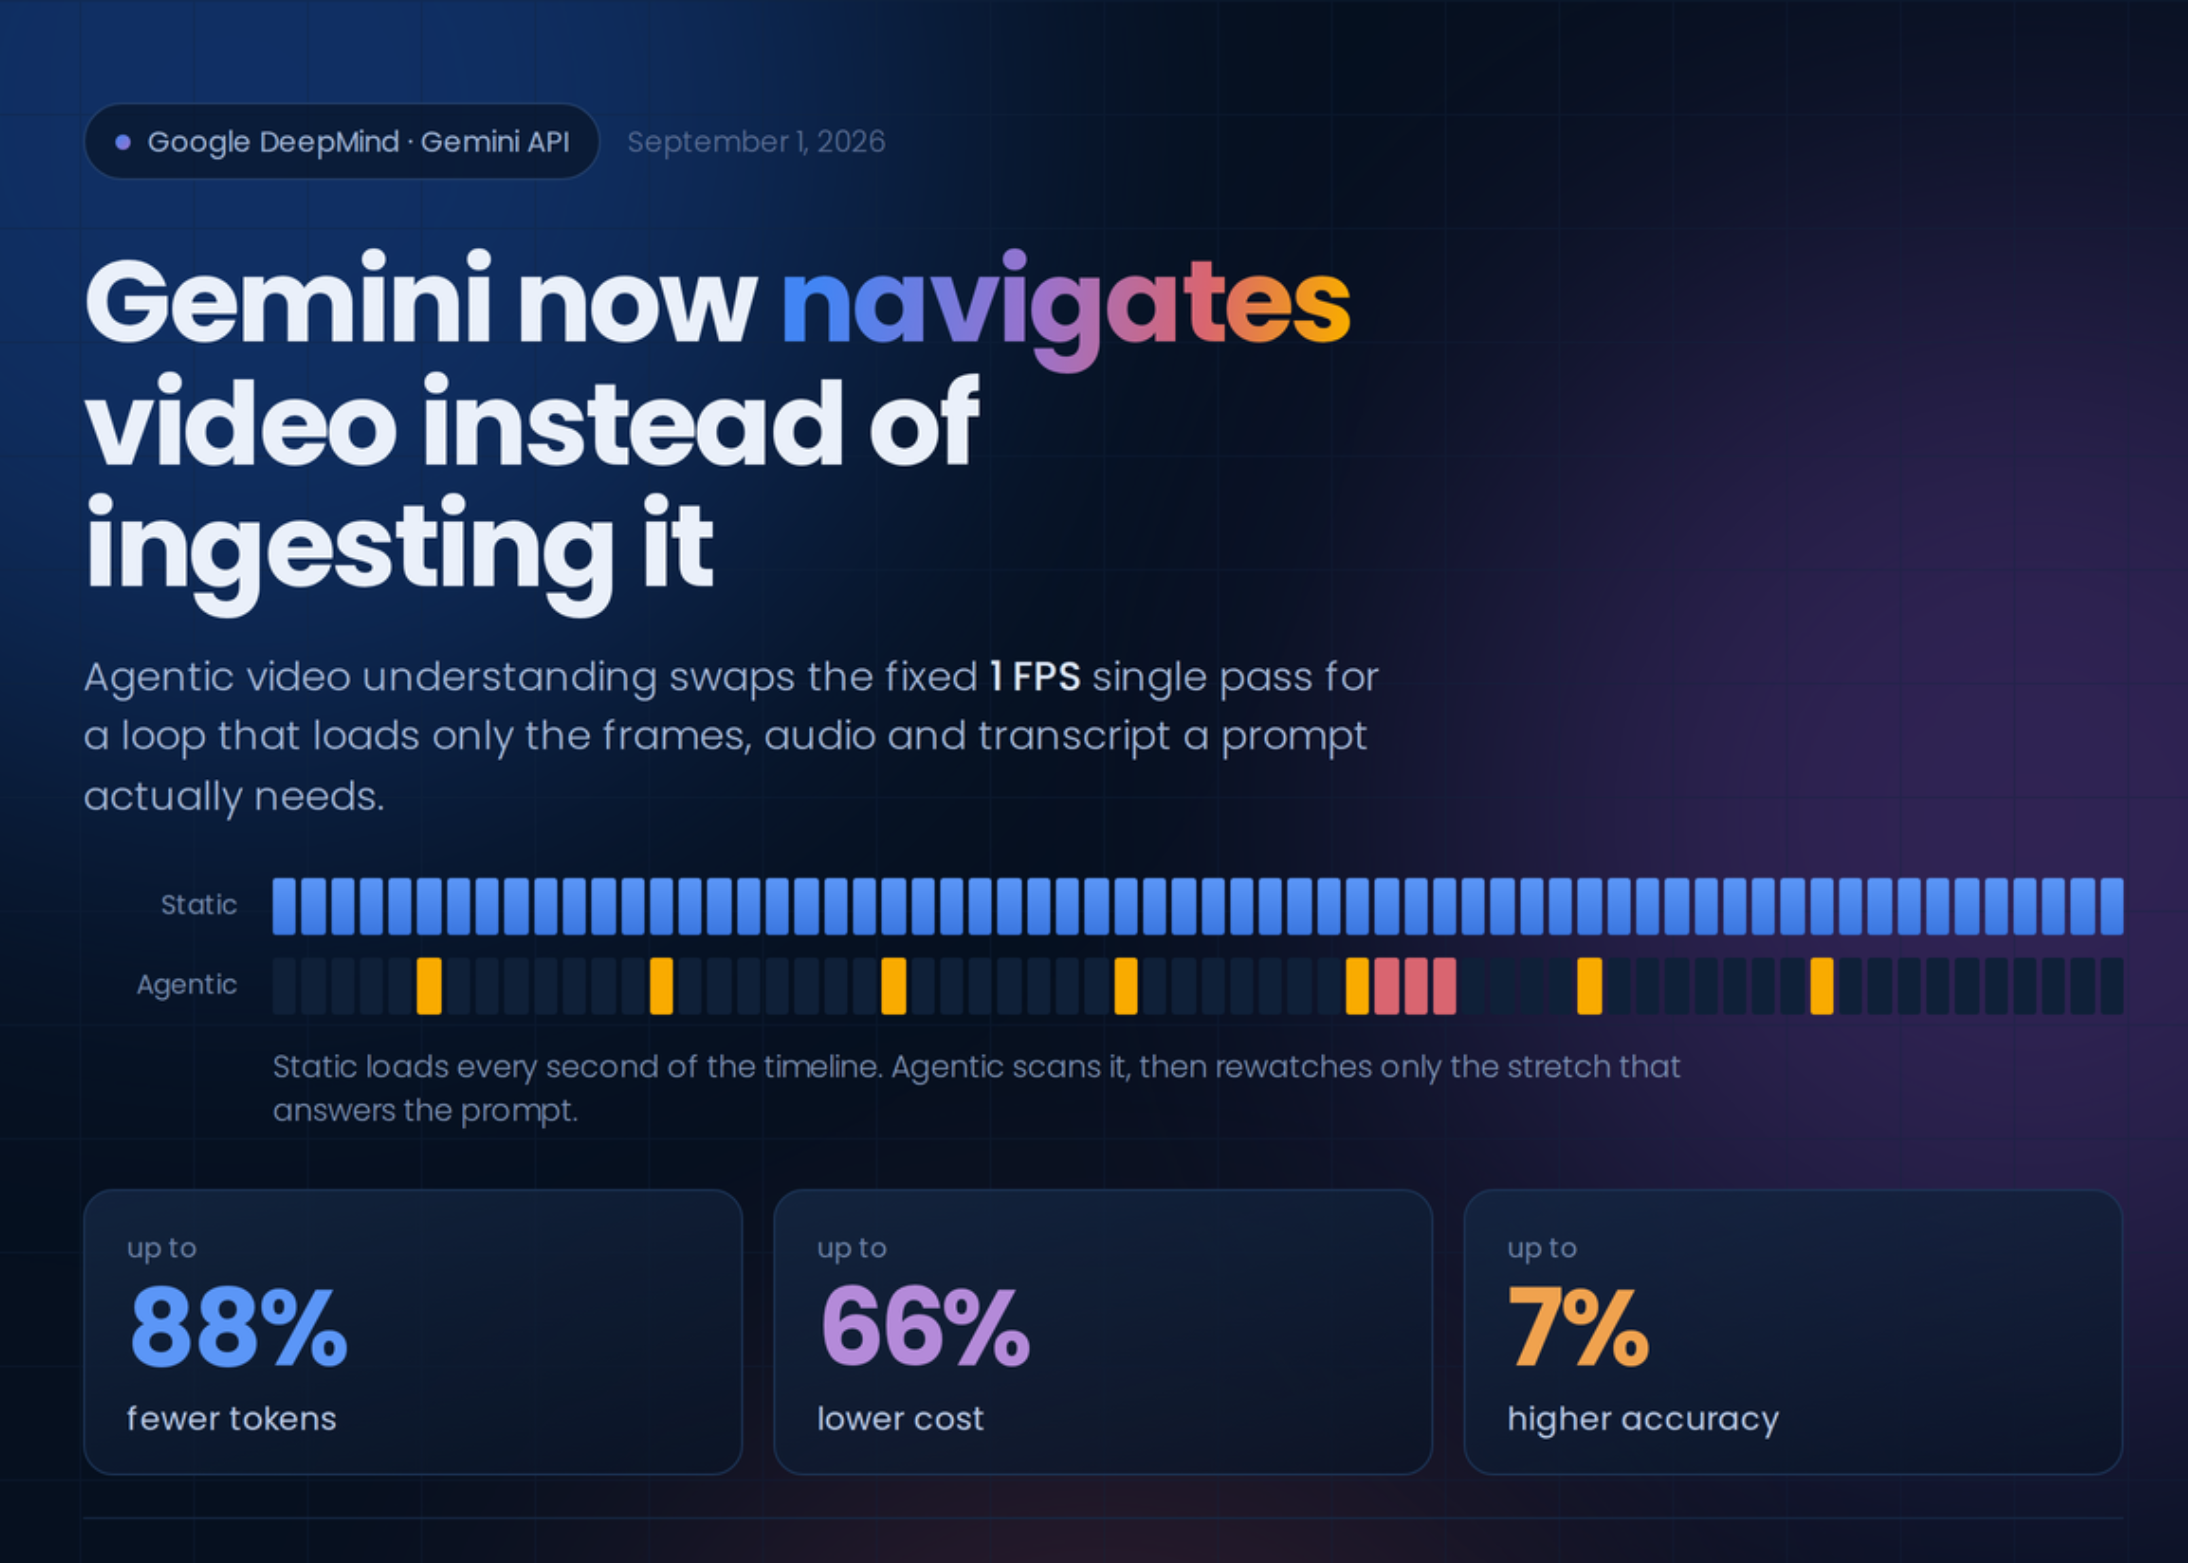
GoogleのAI「Gemini Flash」が、動画全体を見ずに必要な部分だけを分析する新機能を導入。AIが処理する情報量を最大88%減らし、コストを最大66%削減できます。
動画はこれまで、AIが内容を理解する上で最もコストのかかる形式でした。90分の講義動画をGeminiモデルに与えた場合、これまでAIは「これを要約して」という質問でも「発表者が価格スライドに切り替わるのは何時か」という質問でも、1秒あたり1フレームという固定のレートで動画全体を取り込んでいました。この一回限りの処理設計は、文脈全体を把握するために全タイムラインのコストを支払うか、動画を事前に分割して重要な詳細を見落とすリスクを冒すかという、望ましくないトレードオフを強いていました。今週、GoogleはFlashモデル全体でagentic video understandingを開始しました。Geminiはタイムライン全体を取り込む代わりに、何を見るべきか、どのフレームレートで、どのモダリティ(形式)で見るべきかを判断しながら動画内を移動します。Googleは、標準的な動画ベンチマークにおいて、最大88%のトークン削減、最大66%のコスト削減、そして最大7%の精度向上を報告しています。これは展開可能でしょうか?はい、ただしホストされたAPI機能としてのみです。オープンウェイトはなく、自己ホストできるものもありません。Google AI StudioのGemini APIおよびGemini Enterprise Agent Platformを通じて提供され、ファイルアップロードと公開YouTube URLの両方に対応し、追加機能料金なしで標準のGemini APIトークン料金で課金されます。何が実際に変わったのか?すべてのGeminiモデルで依然としてデフォルトである静的処理は、1秒あたり1フレームでフレームを抽出し、1 Kbpsのシングルチャンネルで音声を処理し、毎秒タイムスタンプを挿入します。agentic processingはこれをループに置き換えます。モデルは自身の推論とネイティブの動画ツールを組み合わせて、フレーム、音声、トランスクリプト全体でターゲットセグメントを検索、スキャン、検査し、プロンプトが必要とするものだけを読み込みます。開発者はこれまでこれを手作業で組み立てることもできましたが、変更点はGeminiが内部でこのループを実行するため、開発のオーバーヘッドがなくなる点です。Googleの評価全体において、agentic understandingを備えたGemini 3.7 Flashは、テストされたモデルの中で動画分析における精度対コストのPareto frontierに到達しています。この効率向上は、10分のハウツーガイドから数時間にわたる録画まで、長尺コンテンツに集中しています。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。