NVIDIA、AI処理を分散する新ツール
NVIDIA Releases Personal AI Router (PAIR): An Open Source Virtual Inference Router that Distributes Local AI Requests Across RTX, DGX Spark, and Mac Nodes
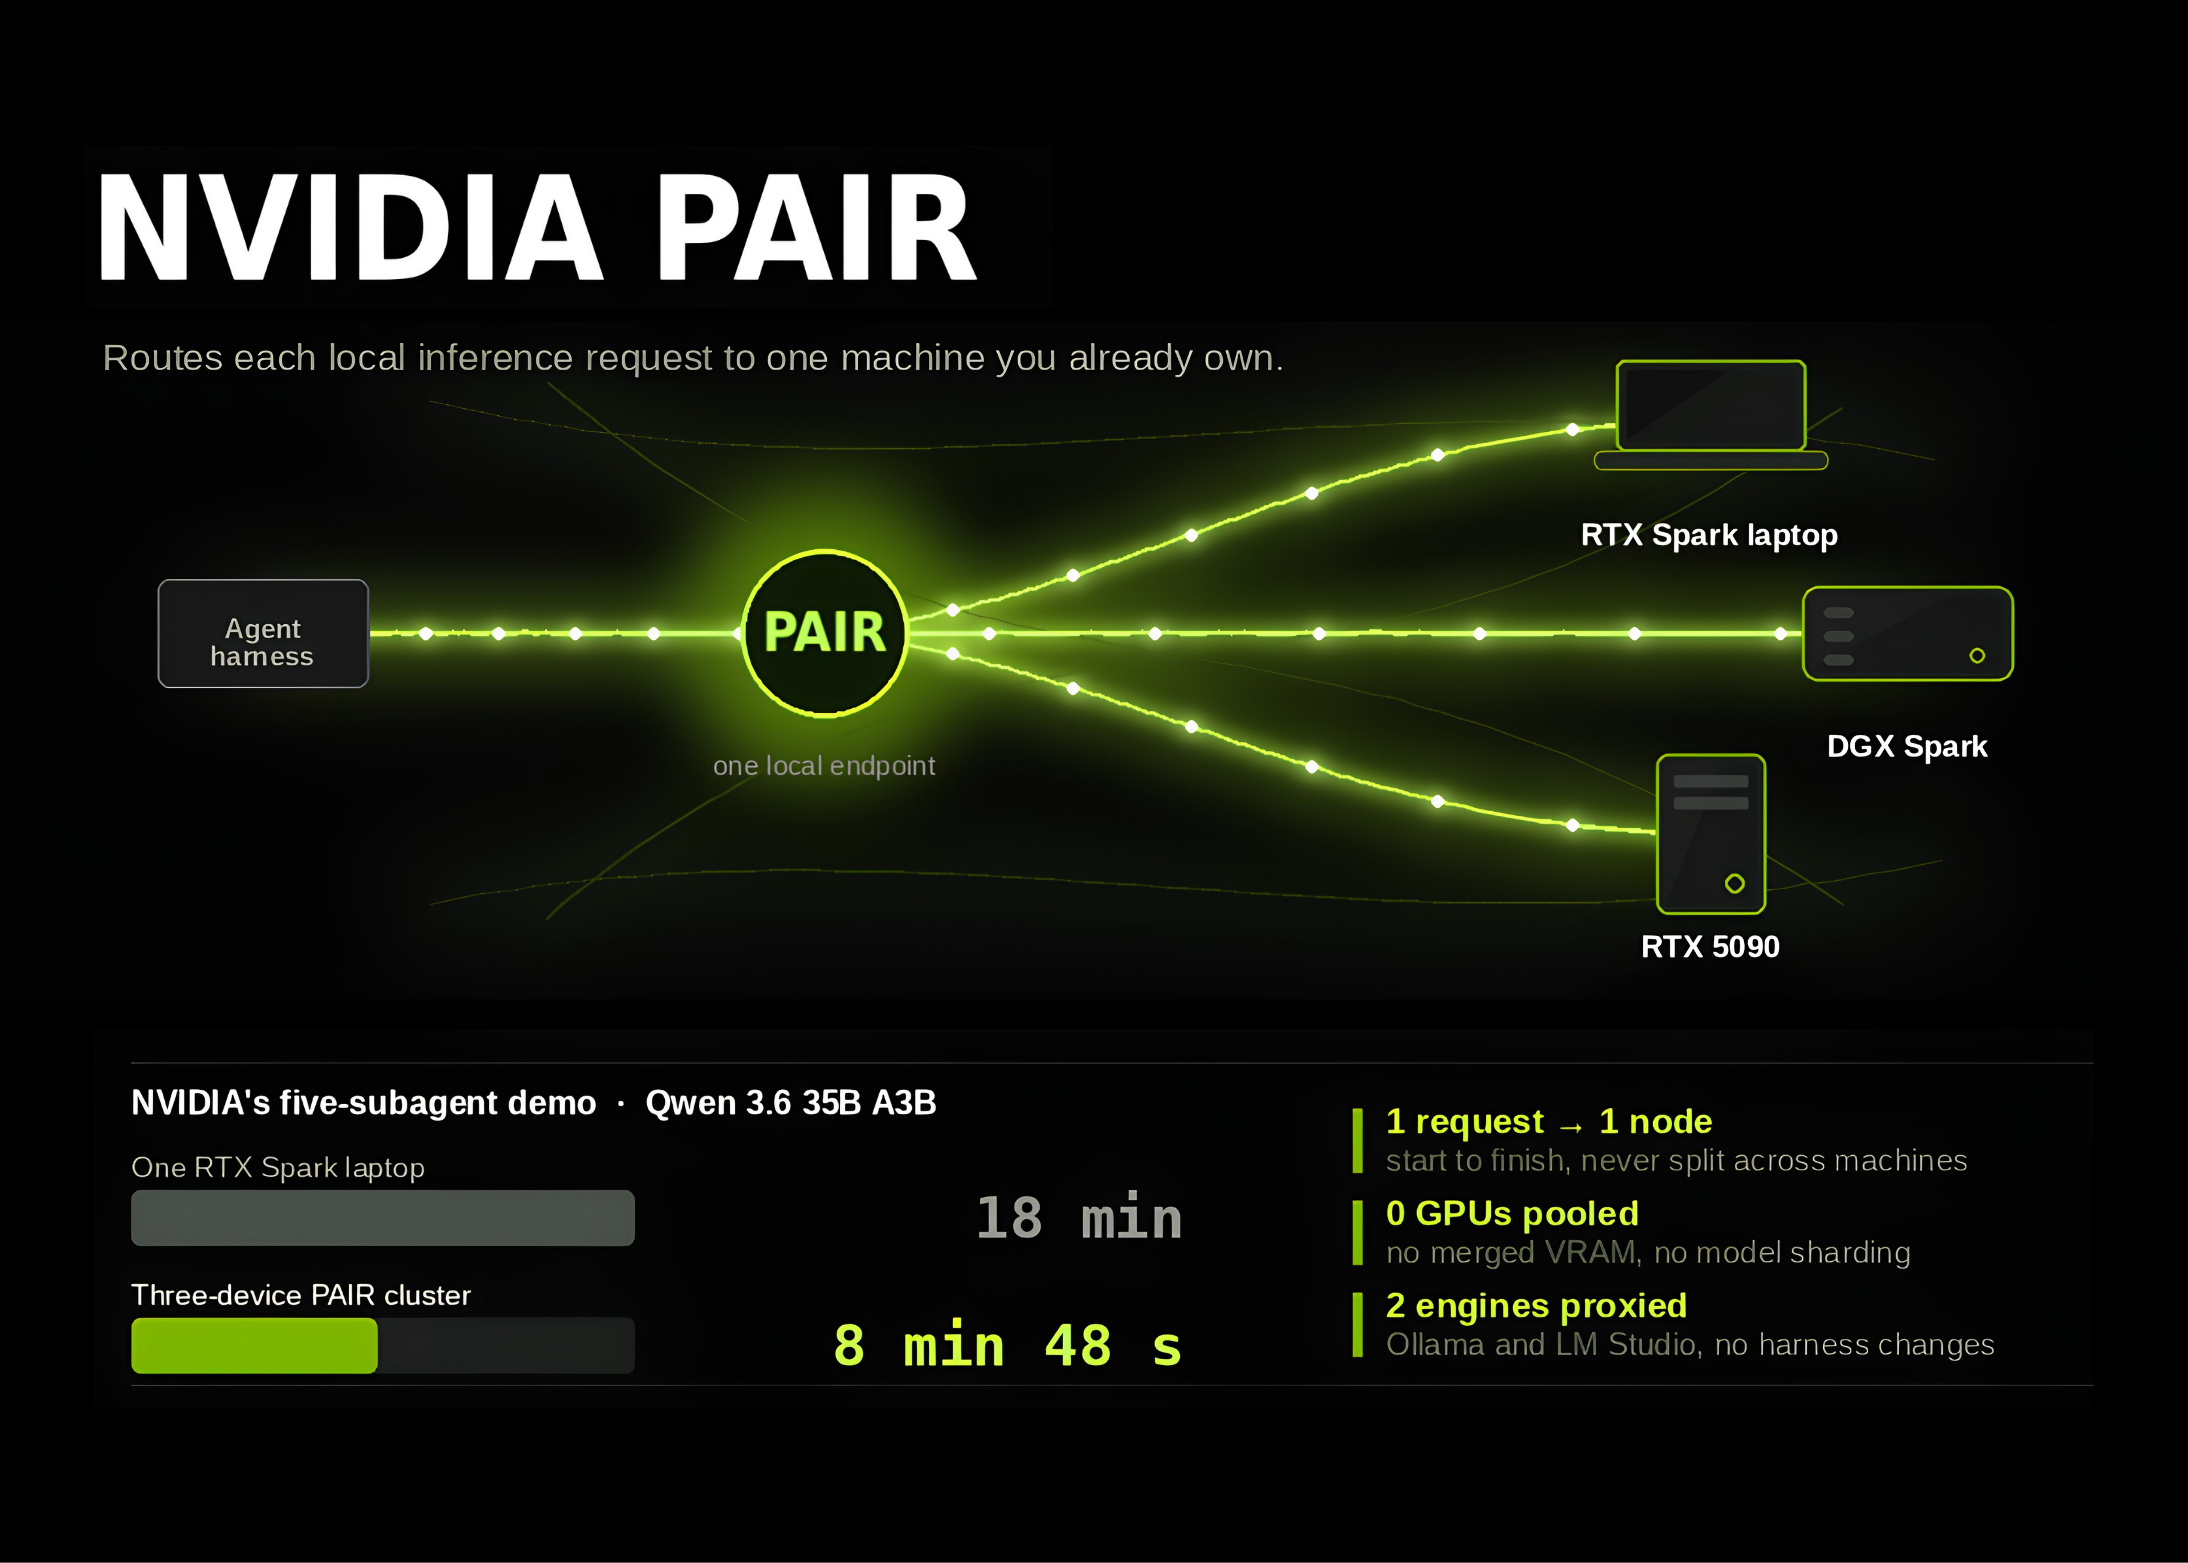
NVIDIAがAIの処理を家庭内の複数のパソコンに分散させる「PAIR」を公開。これにより、AIが考える待ち時間を減らし、より多くの作業を効率的に行えるようになります。
マルチエージェントのワークフローは、ローカル inference の形を変えました。リードエージェントがタスクを分解し、サブエージェントを生成します。1つのユーザーリクエストに見えたものが、何十もの独立した model calls になります。これらが単一のローカル engine に向けられると、同じ実行スロットを奪い合います。キューが伸びる一方で、同じネットワーク上のワークステーション、ラップトップ、または DGX Spark はアイドル状態になります。NVIDIA Personal AI Router (PAIR) は、まさにそのボトルネックを解消します。今週発表された PAIR は、仮想 inference router です。ホームネットワーク上の互換性のあるマシンを検出し、それらの間で独立した inference requests をスケジュールします。これは新しい inference engine ではありません。Ollama または LM Studio は、PAIR が選択したどの node 上でもモデルを実行します。デプロイ可能ですか?はい。PAIR は本日、Windows、macOS、Linux 用の署名付きインストーラーを備えたパブリックベータ版 (v0.1.1) として出荷され、完全なソースコードは Apache 2.0 ライセンスの下で GitHub に公開されています。インターネットはモデルのダウンロードにのみ必要で、完全にローカルネットワーク上で動作します。新しい API はありません。最も重要な設計上の決定は、PAIR が cluster API を導入しないことです。エージェントが既に話す Ollama 互換および LM Studio 互換のインターフェースをプロキシし、各 engine が使用するデフォルトポートを引き継ぎます。もし harness が別の場所でリッスンしている場合、プロキシポートは PAIR の engine 設定で構成可能です。このリポジトリは OpenAI 互換のプロキシエンドポイントも公開しています。その結果、既存の agent harness は変更を必要としません。エージェントはどのような作業を要求するかを決定し、PAIR はそれがどこで実行されるかを決定します。検出、ペアリング、および転送 PAIR は mDNS を使用して近くのシステムを自動的に見つけます。検出に失敗した場合、IPアドレスで node を追加できます。信頼は、招待するマシンに表示される6桁の PIN を招待されるマシンに入力することで確立されます。このペアリングが完了するまで、すべての node 間通信はブロックされます。ペアリングされた node 間のトラフィックは、生成された証明書を使用して mTLS で保護されます。各 node は Ollama または LM Studio を実行します。PAIR は、ペアリングされたシステムに engine をインストールし、モデルのダウンロードを開始できます。これにより、m
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。