カーソル、AI学習技術を公開
Cursor Open-Sources Mixture-of-Kittens (MoK): A Deterministic MoE Training Megakernel for GB300 NVL72 Racks
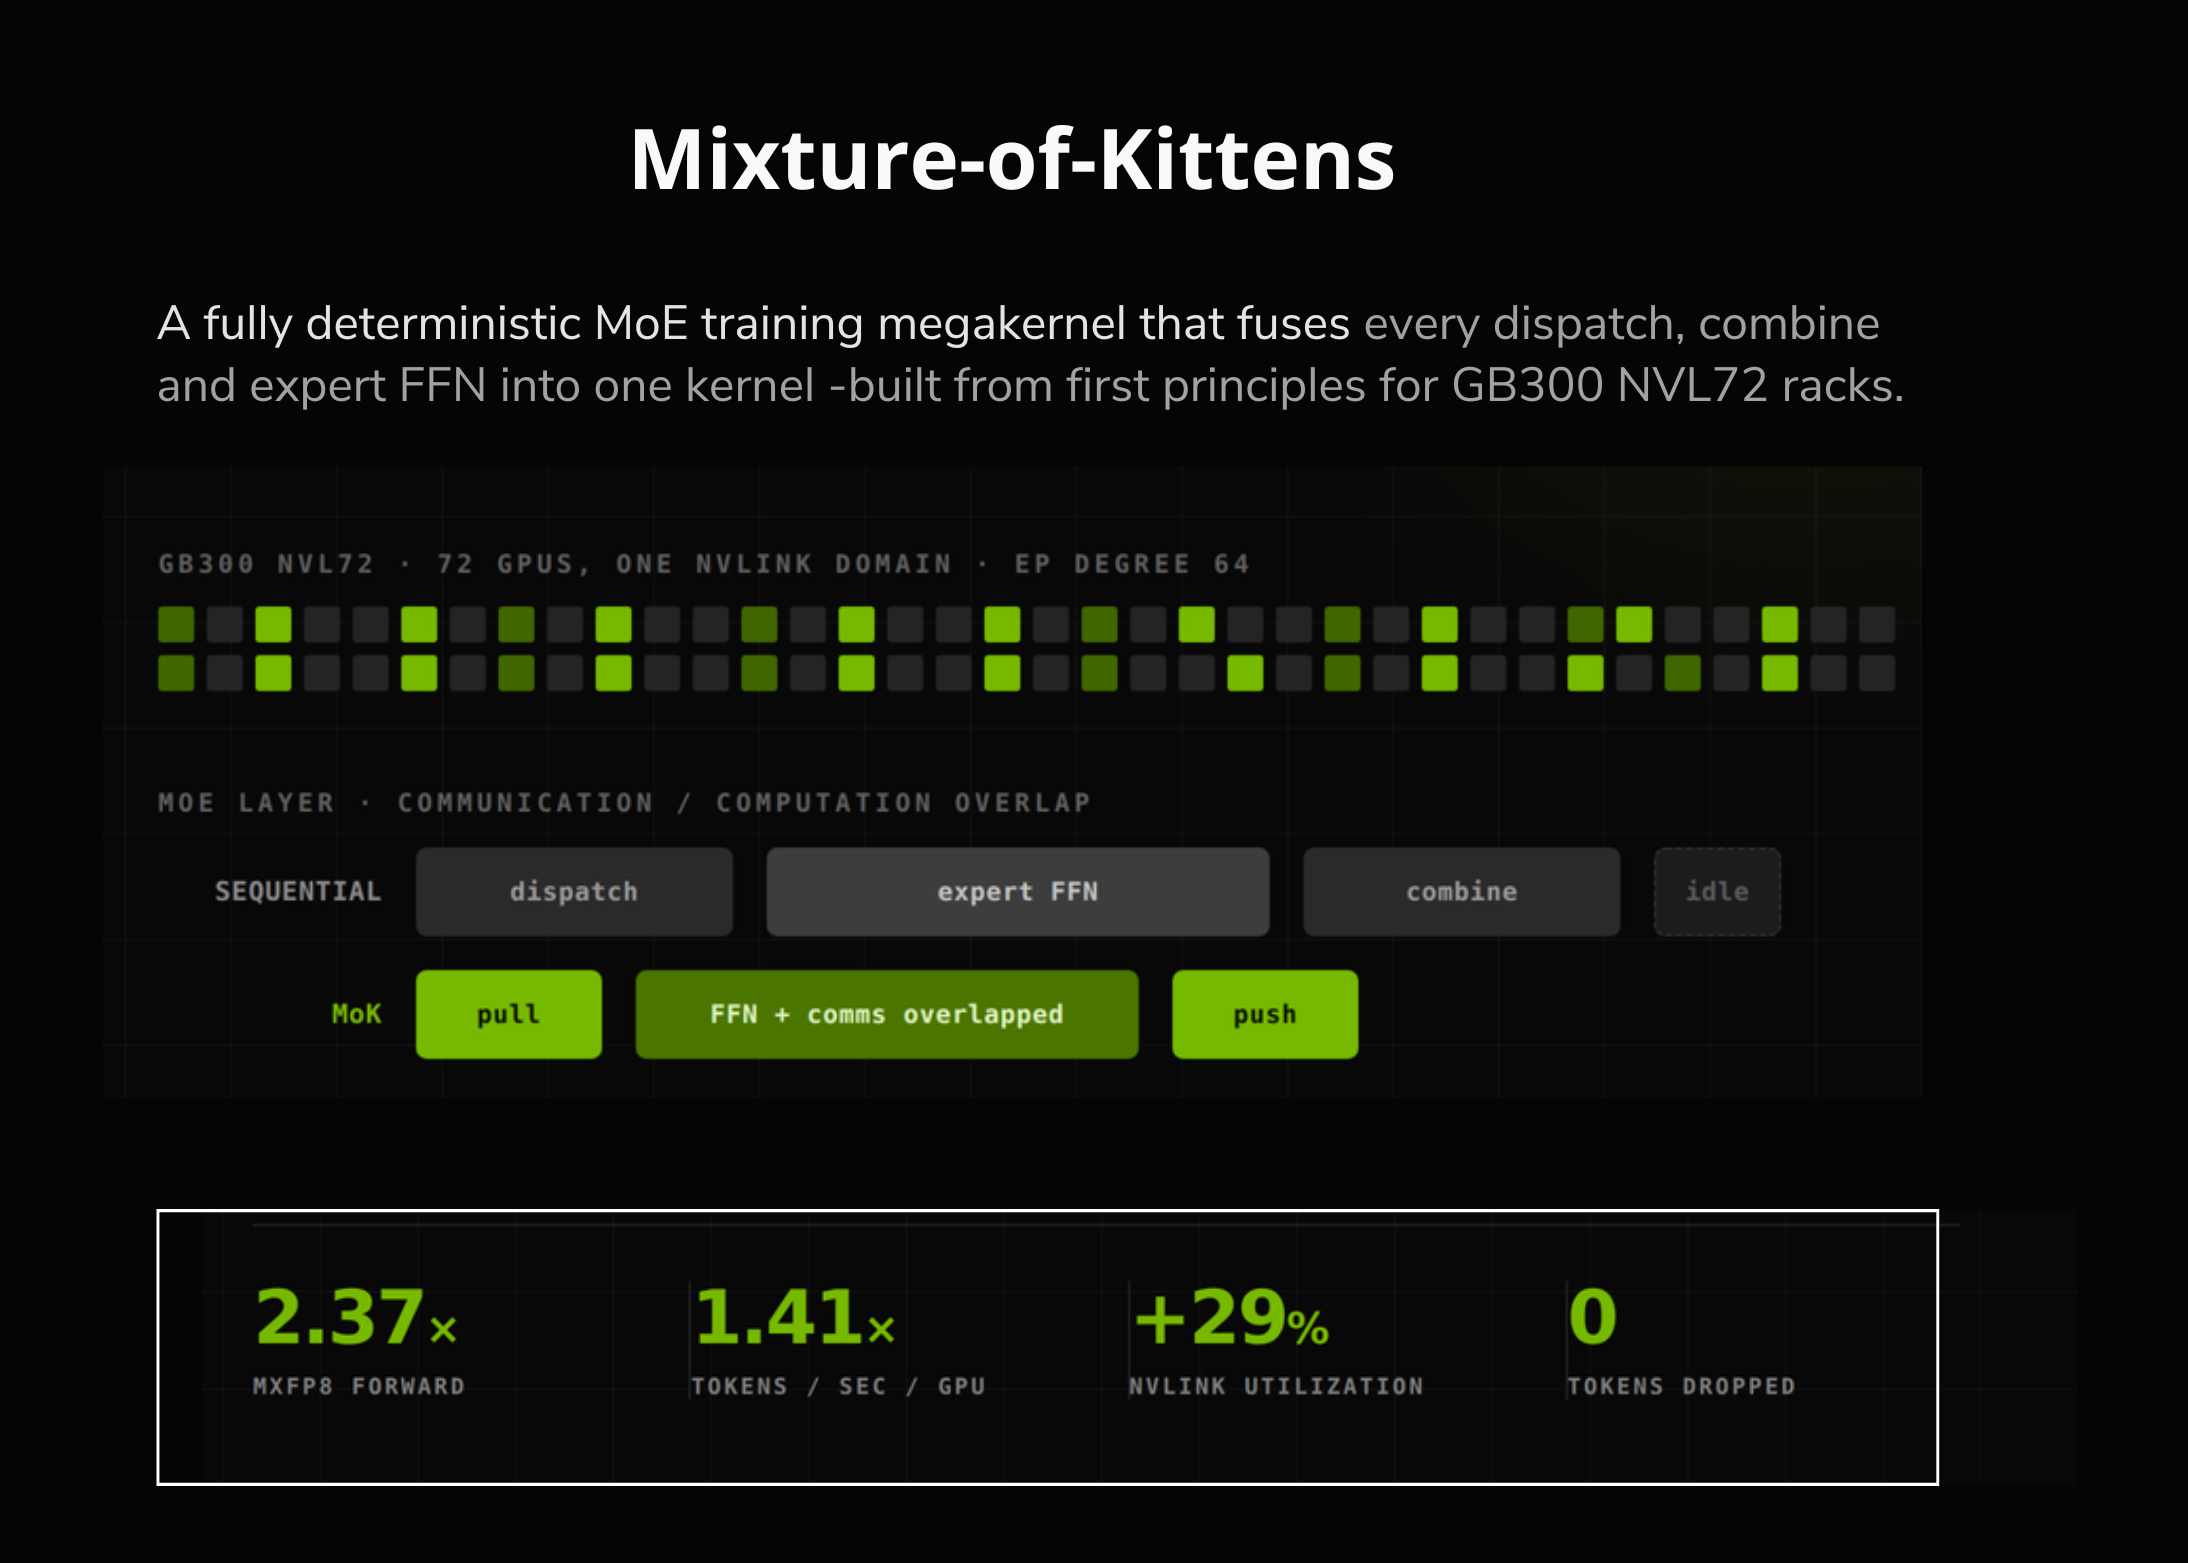
CursorがAI学習を2.37倍高速化する技術MoKを公開。大規模なAI開発において、より効率的なモデル作成が可能になる。
Cursor Researchは、そのComposerモデルの背後にあるmixture-of-expertsトレーニングmegakernelであるMixture-of-Kittens (MoK)をオープンソース化した。MoKは、すべてのMoE通信および計算ステップを単一の決定論的kernelに統合する。Cursorチームは、最強の公開ベースラインと比較して最大2.37倍高いスループットを報告している。これはすでに数万のGPUにわたるComposerトレーニングを支えている。展開可能か?はい、しかしハードウェアの敷居は高い。MoKはApache-2.0ライセンスのもとGitHubで公開されている。NVIDIA Blackwell SM100またはSM103 GPUが必要であり、これはGB200 NVL72またはGB300 NVL72ラックを意味する。また、Python 3.12+、PyTorch 2.10+、およびCUDA toolkit 13.0+も必要となる。GPU間のバッファはPyTorch symmetric memoryに依存する。これにより、現実的な採用者はNVL72の容量を所有またはレンタルしている組織に限定される。フロンティアラボ、資金提供を受けたモデルスタートアップ、GPUネオクラウド、および国立計算センターはこれに該当する。単一ノードチームや8-GPUショップは該当しない。アプリケーションは狭いが価値が高い。これにはDeepSeek-V3スタイルのMoEモデルの事前学習および事後学習が含まれる。決定論的であるため、on-policy RL事後学習や内部アブレーションにも有用である。関連する業界は、AIモデル開発、クラウドGPUインフラストラクチャ、コード生成ツール、および定量的研究である。MoE層がボトルネックCursorの以前の作業は計算側をカバーしていた。研究チームは独自のMXFP8およびNVFP4トレーニングkernelと、MoE推論用の「warp decode」パスを作成した。これらはGPU間通信が個別に処理されることを前提としていた。しかし、本番環境では通信が制限要因となった。MoE層は、エンドツーエンドのトレーニング時間の半分以上を消費する可能性がある。GB300 NVL72への移行により、問題は再び変化した。1つのラックは1つのNVLinkドメイン内に72個のGPUがあり、きめ細かなオーバーラップを可能にする。しかし、統合されたGrace CPUはGPUと比較して遅い。したがって、CPU-GPU同期は積極的に最小限に抑える必要がある。重要な3つの設計上の決定:通信方向は操作ごとに選択される。DeepEPなどの既存のアプローチは
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。