IFMがK2 Horizonを公開: 大小6種類のAIモデル
IFM Releases K2 Horizon: Six Apache 2.0 Models From 0.9B to 375B
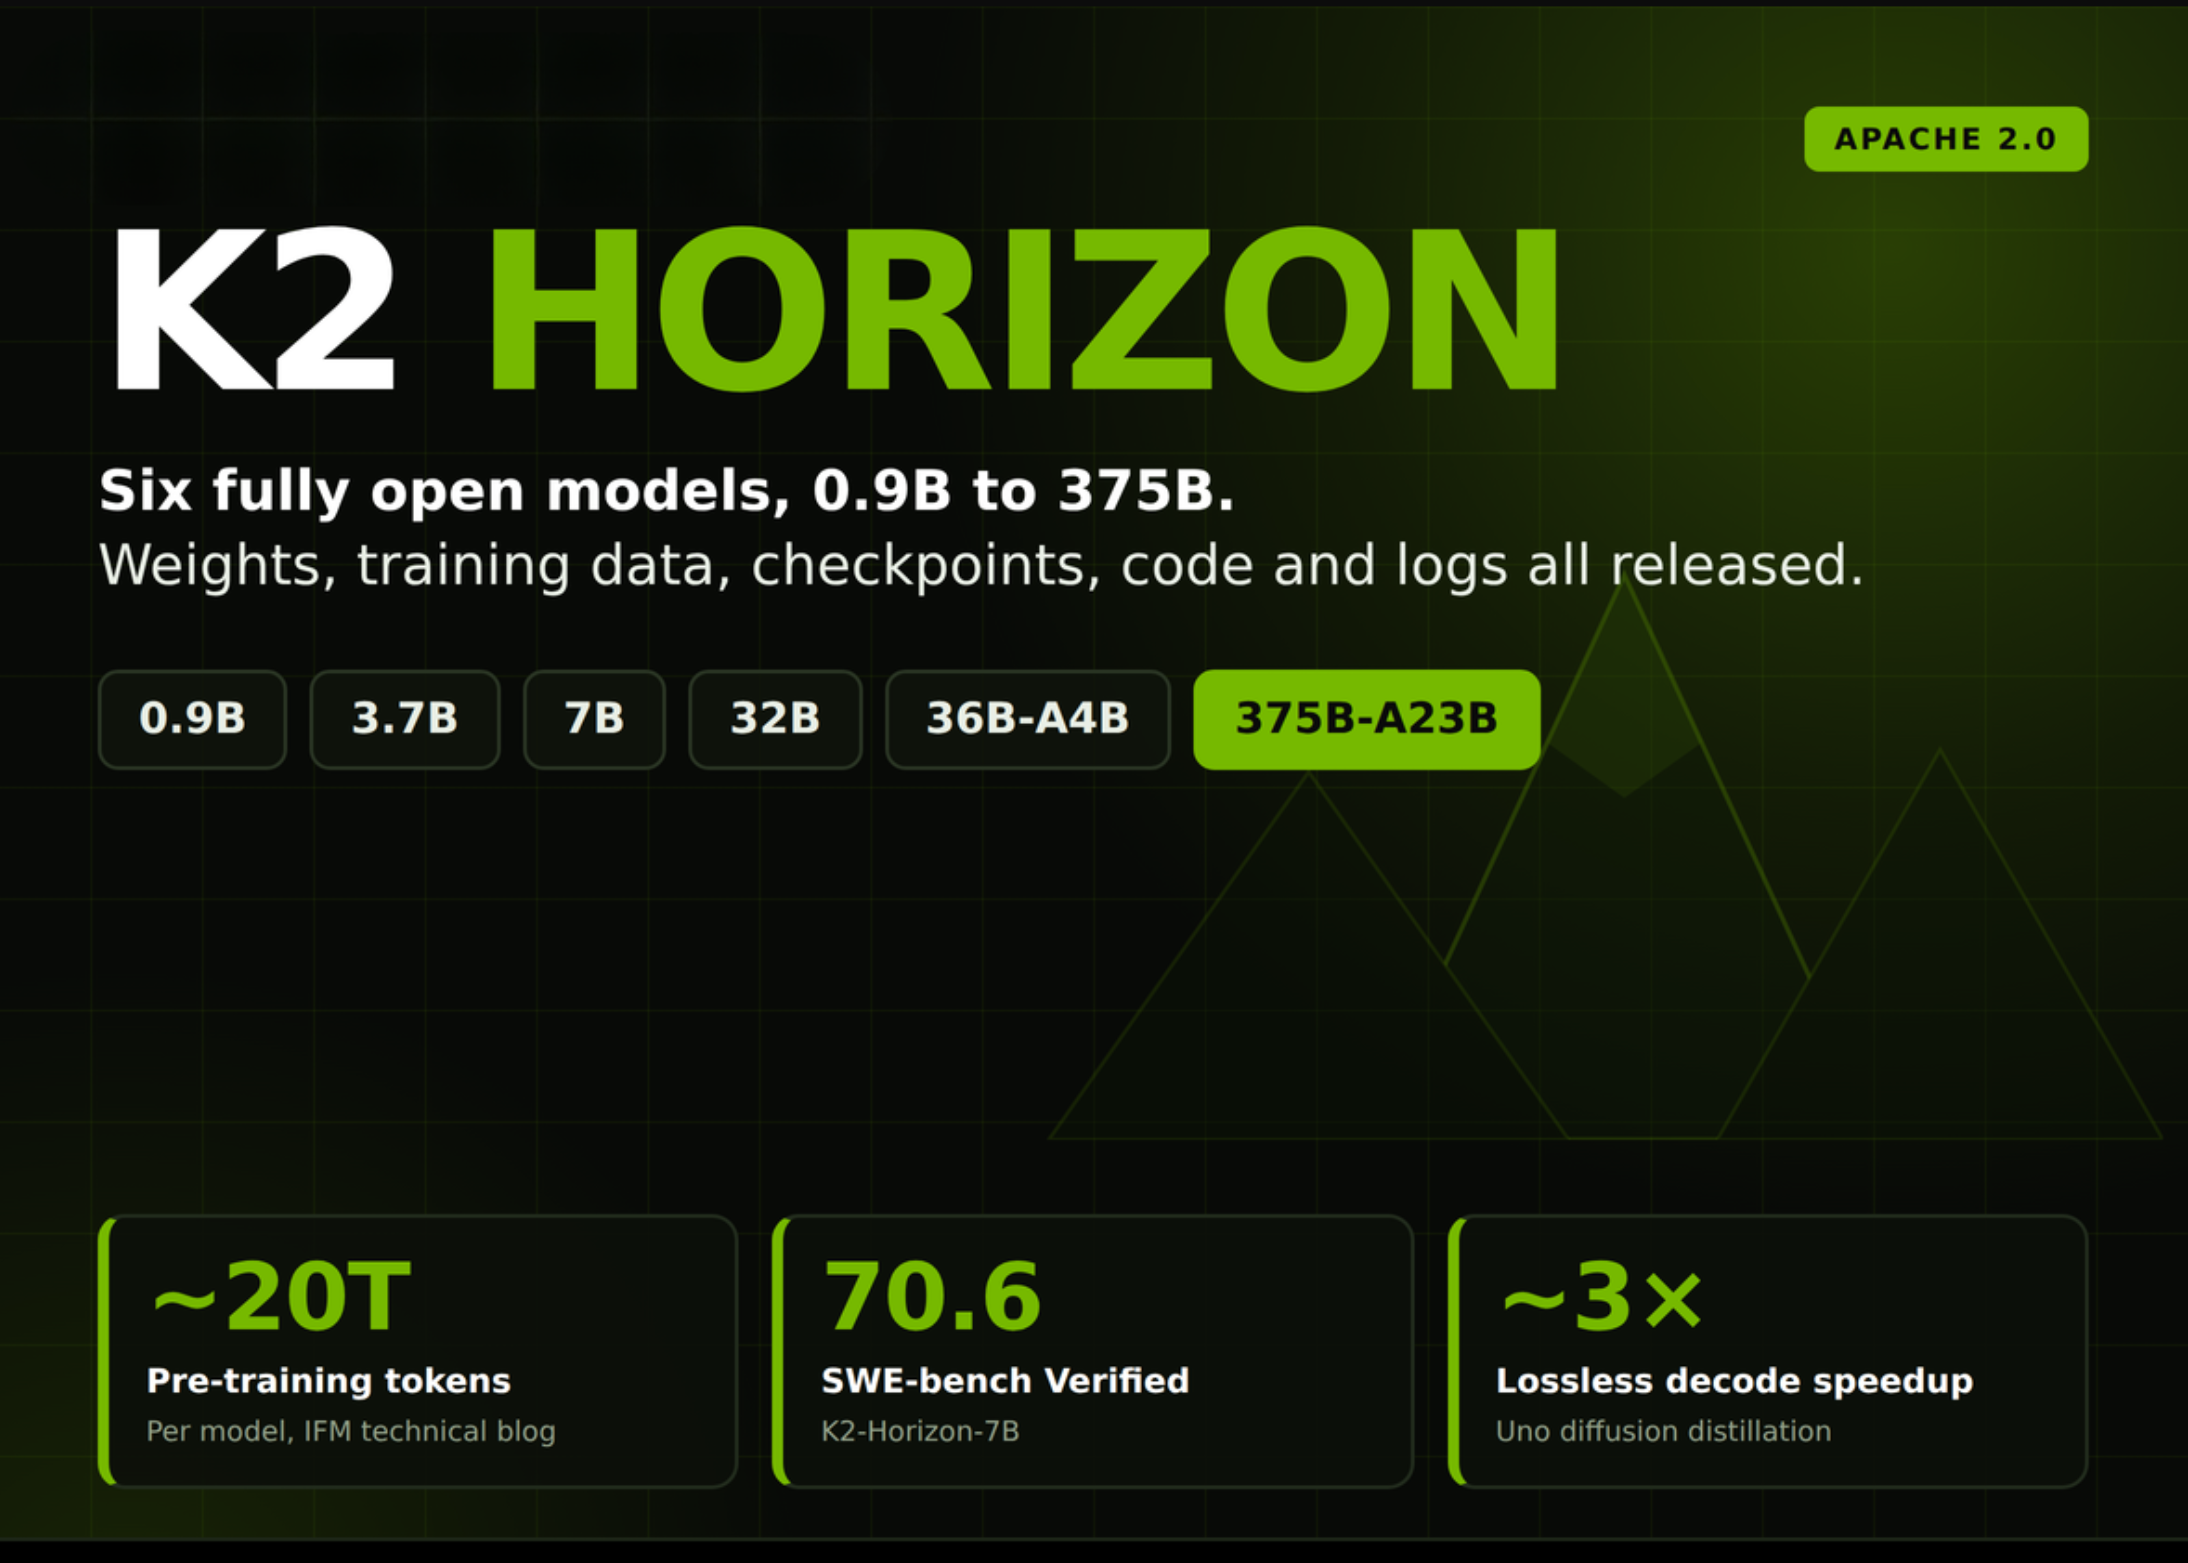
IFM研究所が、大小6種類のAIモデル「K2 Horizon」と学習データを全て公開。開発者は小規模から大規模まで、一貫したAI開発を効率的に進められるようになります。
ほとんどのオープンモデルの発表では、1つのチェックポイントとベンチマーク表が公開されます。しかし、Institute of Foundation Models (IFM) は先週、より広範なものをリリースしました。IFMは、2025年5月にMBZUAIによって立ち上げられたフロンティアラボです。K2 Horizonは、375B-A23B、36B-A4B、32B、7B、3.7B、0.9Bの6つのモデル群です。これらと共に、事前学習コーパス、中間チェックポイント、トレーニングコード、設定ファイル、詳細なログも提供されます。IFMはこれをAI史上最大の完全オープンソースモデルのリリースと呼んでいます。 展開可能でしょうか?はい、これら6つのモデルはすべてApache 2.0ライセンスのもとHugging Faceで利用可能であり、FP8およびGGUFビルドも提供されています。vLLM、SGLang、Ollamaのデイゼロサポートが、NVIDIA、AMD、Cerebrasのハードウェアで利用できます。ホスト型APIは、platform.ifm.aiを介してCompass、Cerebras、Nebiusを通じて実行されます。 実際に提供されたもの これら6つのモデルは、コアアーキテクチャ、語彙、トレーニング方法論、インターフェース、デプロイメントツールを共有しています。0.9Bモデルはより小さな語彙を使用しています。この一貫性が重要であり、チームはサービングスタックを変更することなく、3.7Bでプロトタイプを作成し、375B-A23Bにスケールアップできます。各モデルは、およそ20兆トークンで事前学習されています。事前学習コーパスの約17%は、明確な推論を伴う問題解決の軌跡で構成されています。約10兆トークンは合成データでした。後処理データは、トレーニングの途中で組み込まれ、最後に保存されることはありませんでした。IFMの研究チームは、1億を超える独自の合成タスクを報告しています。ツールの定義は、トレーニング中にJSON、XML、Markdownで提示され、モデルが構文ではなく意味を学習するようにしました。Markdownは推論のデフォルトとなり、IFMのデータではJSONよりも約18.5%トークン効率が向上しました。 MoVA: Attentionに導入されたスパース性 従来のMixture-of-Expertsは、フィードフォワード層にスパース性を適用します。Mixture-of-Value Attention (MoVA) は、エキスパートルーティングをマルチヘッドアテンション自体に拡張し、容量をスケーリングするための第2の軸を開きます。これはFlashAttention、grouped-query attention、sparse attentionと互換性があります。その結果がK2-Horizon-MoVA-36B-A4B: 36B totです。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。