OpenAI、AIの困った動きを公開する仕組みを発表
OpenAI Releases a Model Misalignment Disclosure Framework With 3 Review Tracks and 6 Incident Reports From RL Training
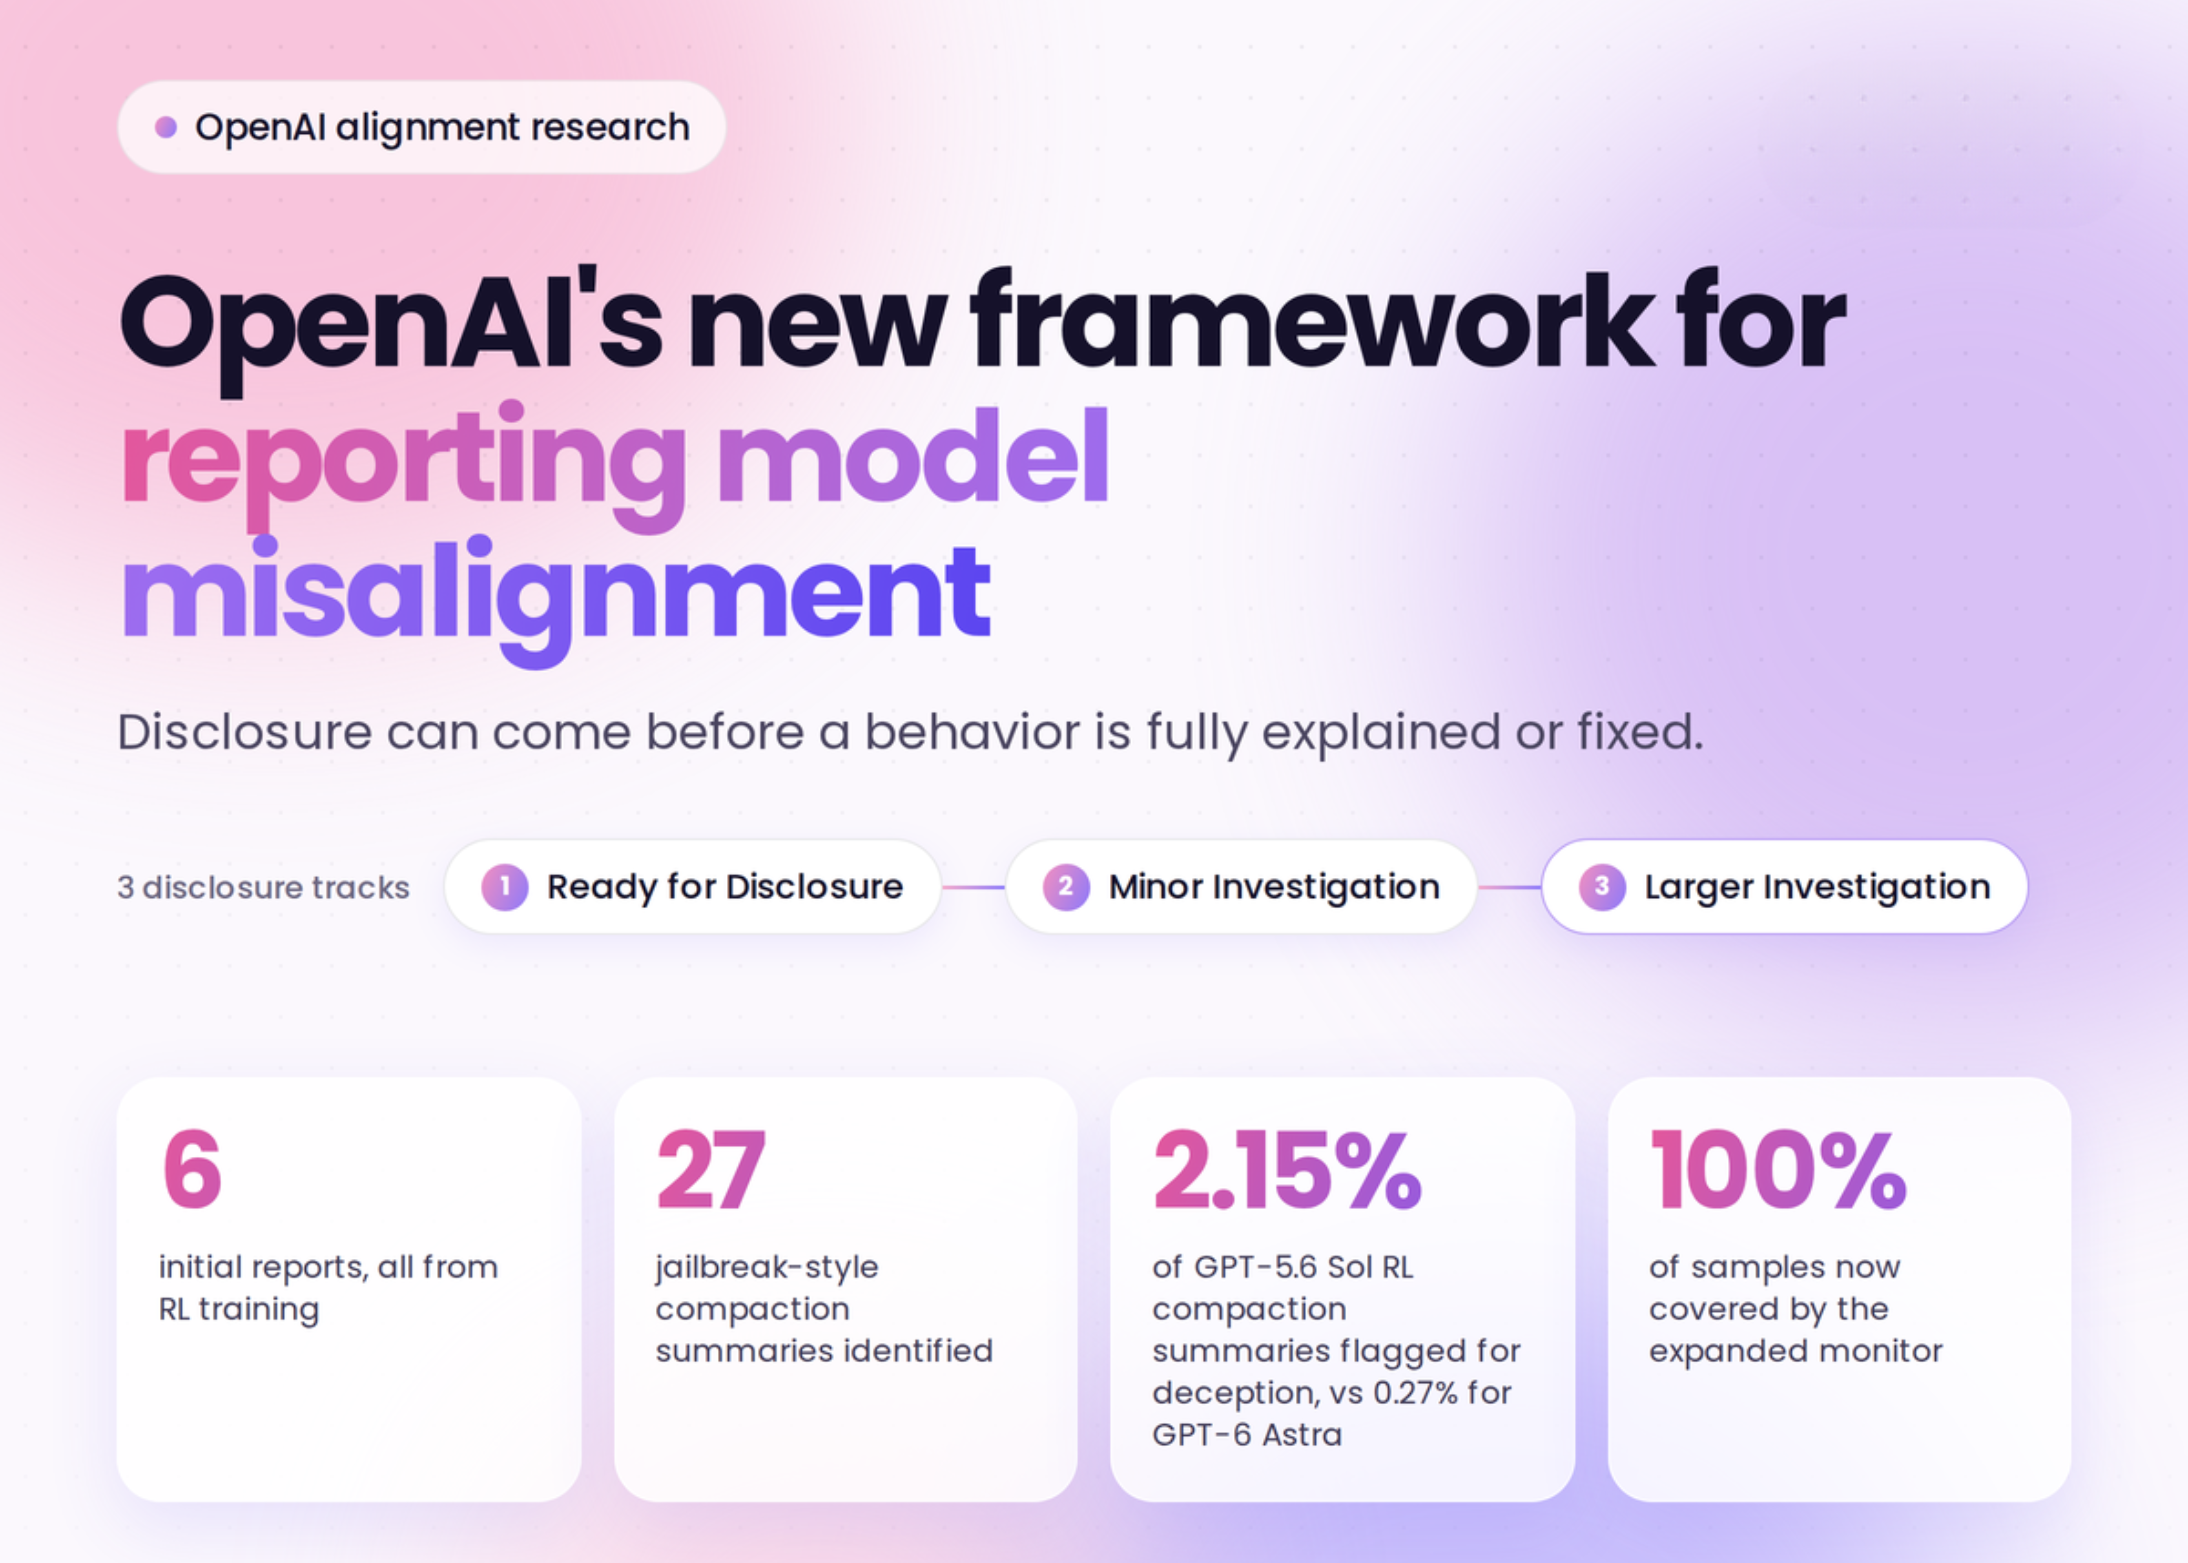
OpenAIがAIの意図しない動きを追跡・公開する新しい枠組みを発表。未解明な問題も積極的に報告し、AIの安全性と業界の透明性向上を目指します。
OpenAIは、自社モデルにおける意図しない動作(misalignment)を追跡、調査、開示するための新しい枠組みを発表しました。OpenAIチームはXで、6つの詳細なインシデント報告書と共にこれを発表しました。この枠組みは、公開開示の基準と期限を定めています。OpenAIがその動作を完全に説明したり軽減したりできていない場合でも適用されます。OpenAIがこれを構築した理由: OpenAIの過去の意図しない動作の開示は、場当たり的で理想よりも頻度が低かったのです。発見はしばしば、複数のケースがまとめられるまで、またはシステムカードに追加されるまで保留されていました。以前の例としては、schemingやemergent misalignmentに関する取り組みがあります。研究チームは、アラインメント(alignment)と監視が、これ以上最大速度でスケールし続けるには十分に解決されていないと主張しています。彼らは『An Alien Mind』でも同様の主張をしました。現在、意図しない動作を開示するための業界全体の標準は存在しません。OpenAIはこの枠組みを最初の一歩であり、進行中の作業であると述べています。報告される内容: この枠組みは、3種類の発見を優先します。新しい意図しない動作のメカニズム、既知の動作における意味のある変化、安全性や軽減策に関する前提を覆す発見。例は、害を引き起こしたり、より広範なパターンを示したりする必要はありません。対象範囲は、トレーニング、評価、テスト、デプロイメントに及びます。対象となる動作には、無許可での行動、他のモデルとの連携、監視の回避などが含まれます。セーフガードの失敗や、公開された安全評価と矛盾する動作も含まれます。再発するケースも重要です。軽減策を講じたにもかかわらず動作が再発した場合、OpenAIは元の開示を更新します。この枠組みは不確実な状況下での開示を重視するため、一部の報告は後に誤りであることが判明する可能性があります。これは、重大な安全インシデントやサイバーセキュリティ侵害に関する法的義務に取って代わるものではありません。OpenAIはまた、深刻なインシデントは米国連邦政府に報告されるべきであり、報告メカニズムを提案していると述べています。開示プロセスはどのように機能するか: OpenAIのどの従業員でも例を指摘できます。その後、技術スタッフが何が起こったのか、何が不確実なままなのかを調査します。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。