H社、画像と文章を効率的に理解するAIを発表
H Company Releases NeoMME: A Family of 260M and 800M Single-Tower Multimodal Encoders That Drop the Vision Tower and Causal Decoder
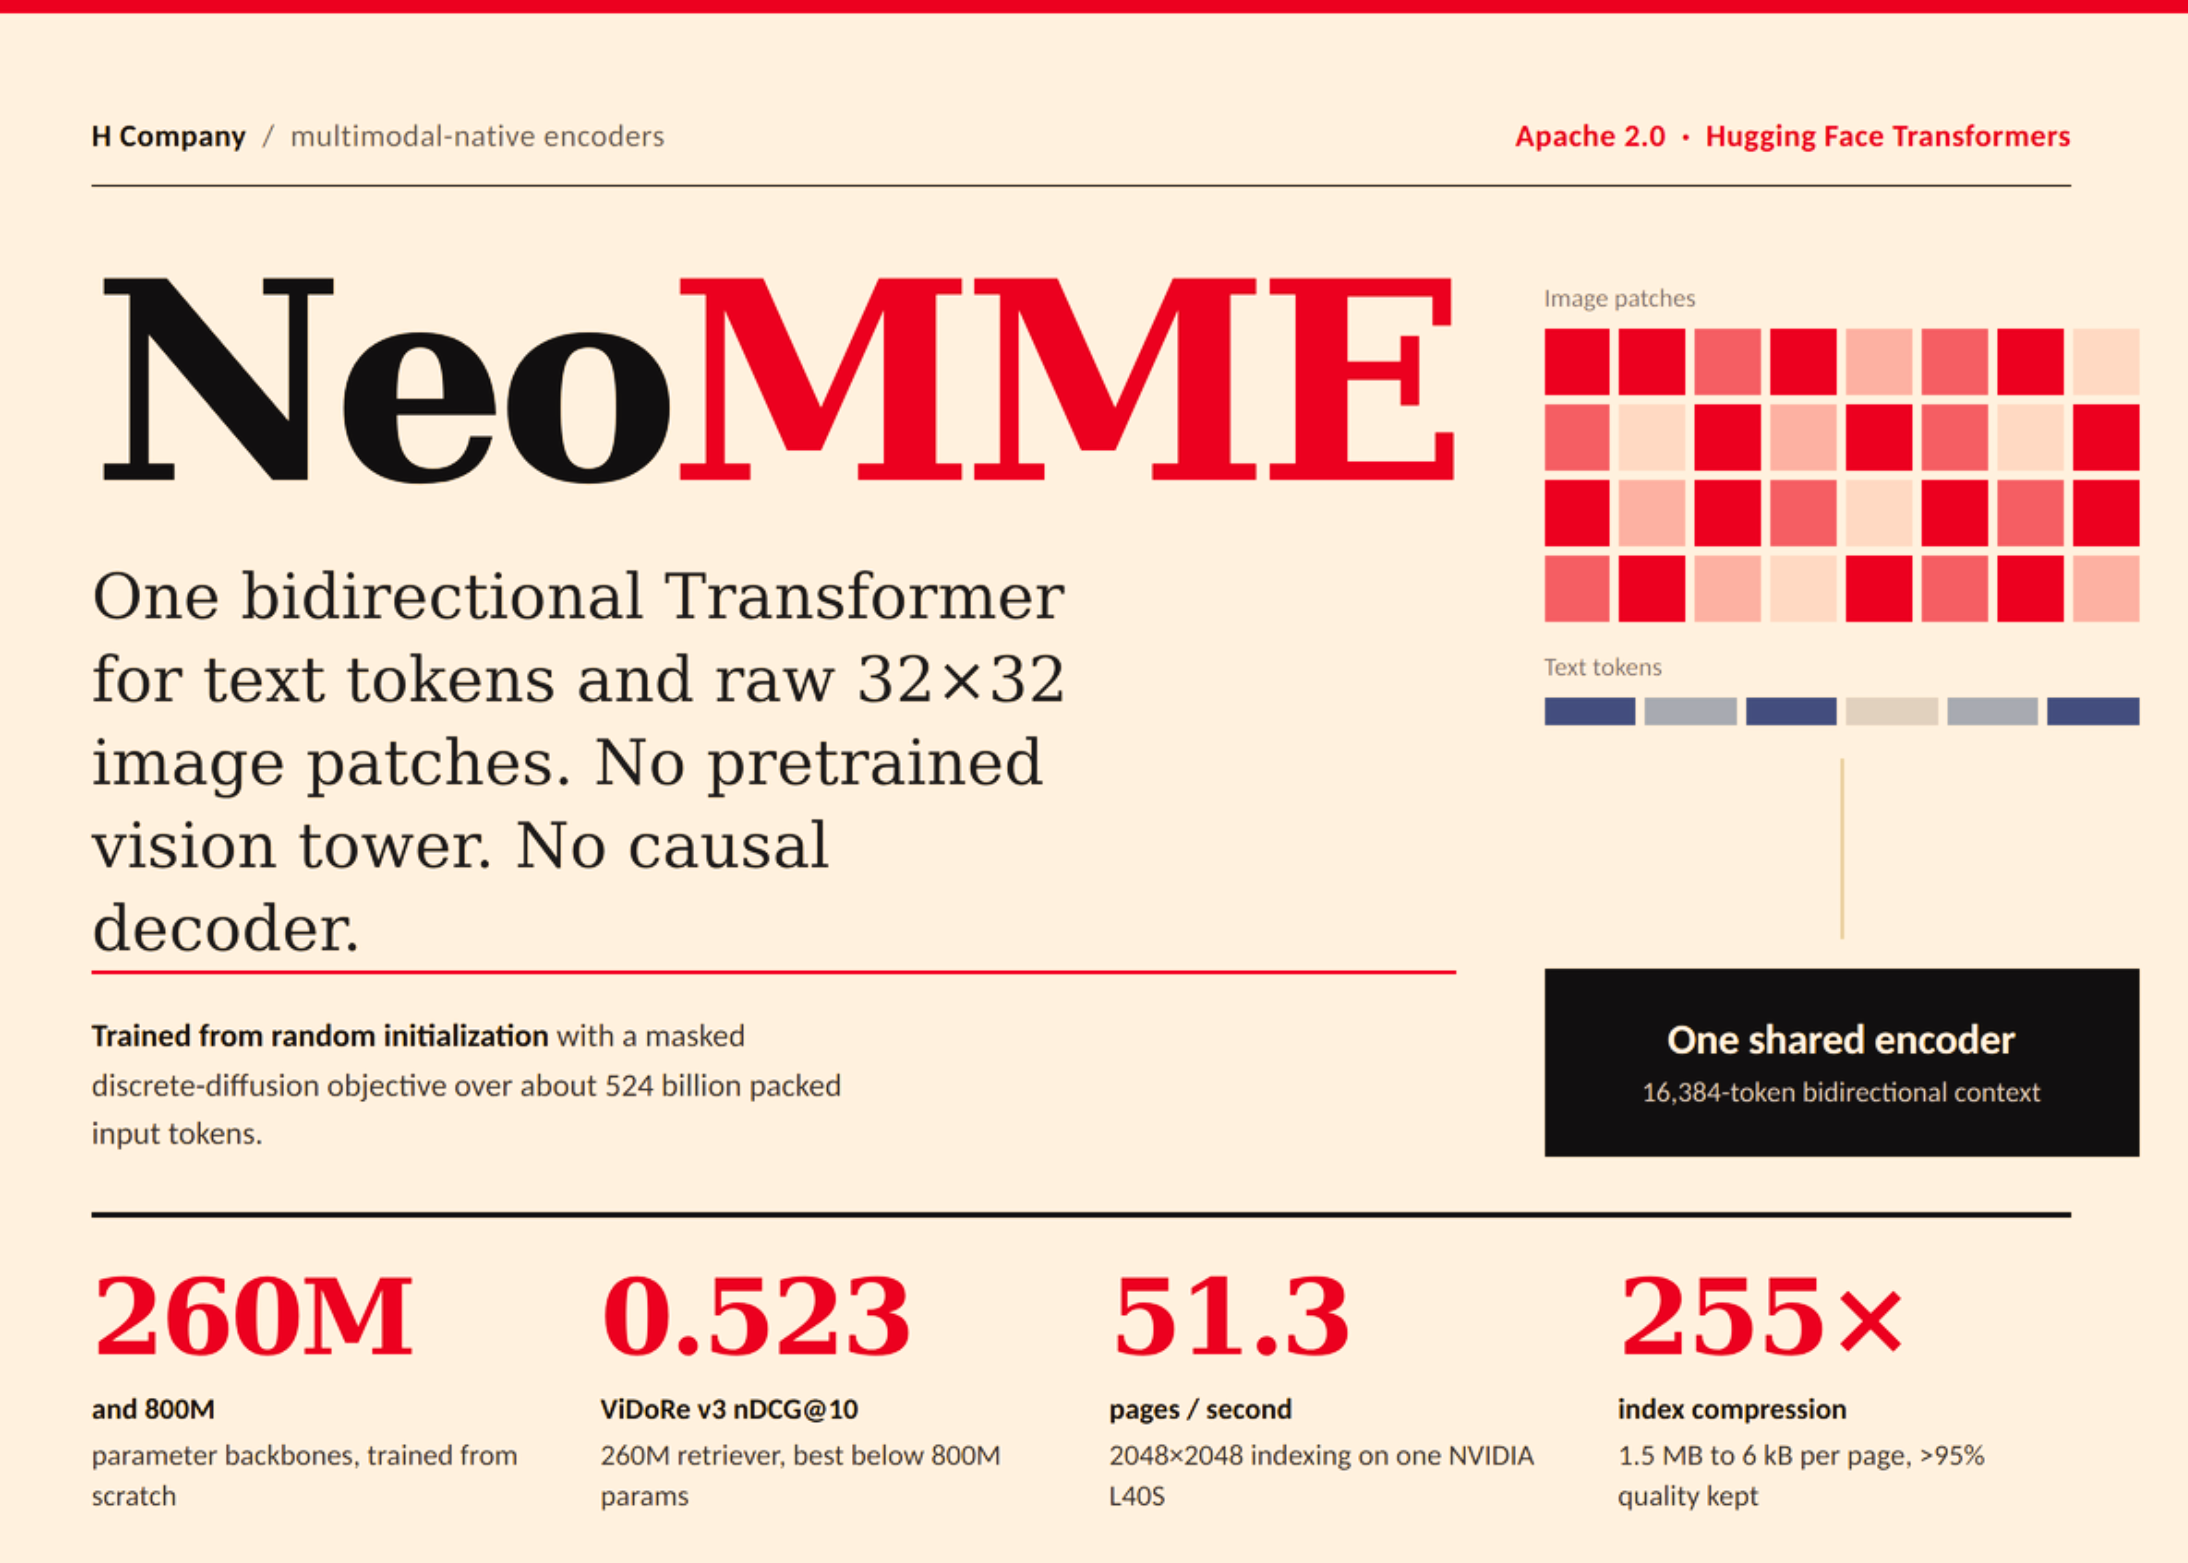
H社が、画像と文章を効率的に理解するAI「NeoMME」を発表。無駄な部分をなくし、少ない計算力で速く動くため、AIの利用がより手軽になります。
現在、実運用されているほとんどの視覚文書検索システムは、古い設計を引き継いでいます。ColPaliやそれに続くモデルは、生成的なvision-language modelをエンコーダーとして再利用しています。その結果、別途事前学習されたvision towerと、一度もトークンを生成しないcausal decoderが依然として残っています。これは、表現(representations)のみを必要とするタスクにとって、パラメーターと計算のオーバーヘッドとなります。H Companyは、これらの両方のコンポーネントを削除した260Mおよび800Mの双方向エンコーダーのファミリーであるNeoMMEをリリースしました。一つのTransformerが、多言語テキストトークンと生の32×32 RGB画像パッチを同じ層で処理し、ランダムな初期化から学習されます。検索に特化したfine-tuneモデルであるNeoMME-Retrieverは、260MパラメーターでViDoRe v3において0.523 nDCG@10を達成します。これはデプロイ可能でしょうか?はい。すべてのチェックポイントはApache 2.0ライセンスで提供され、Hugging Face Transformersでリリース初日からサポートされます。260Mモデルは、単一のNVIDIA L40S上で毎秒51.3ページをインデックス化し、CPUのみのホスト上で78.3ミリ秒でクエリをエンコードします。https://arxiv.org/pdf/2609.01657
一つのタワー、二つのモダリティ
テキストはALBERT-styleのfactorized embedding(モデル幅に投影される256次元のルックアップ)を介して入力されます。画像は重ならない32×32パッチに分割され、スクラッチから学習された2層のMLPによって投影されます。パッチマージモジュールもSigLIP2 towerもありません。両モデルは16,384トークンのコンテキストをサポートしており、パッチ適用後には標準的な3,840×2,160の4K UHD画像2枚分に十分です。ほとんどの層はsymmetric sliding-window attentionを使用し、6層ごとに1層と最終層はglobal attentionを使用します。スタックはgrouped-query attention、query-key normalization、gated attention、2D rotary position embeddings、およびsquared-ReLU MLPsを使用します。正確なパラメーター数は262,937,906と793,715,032です。トークナイザーは、スクラッチから学習された131,072エントリの語彙を持つ、空白文字に制約されないBPEです。FLORES-200 devtestの14のターゲット言語全体で、ModernBERTよりも44.4%少ないトークンを生成します。
masked diffusion denoiserとして事前学習
事前学習は、テキストに対する離散的なmasked diffusionであり、オプションで条件付けされます。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。