Liquid AI、AIの応答速度を最大3.18倍に
Liquid AI Releases LFM2.5-DSpark Draft Models That Deliver Up to 3.18x Faster Decoding Without Changing Model Outputs
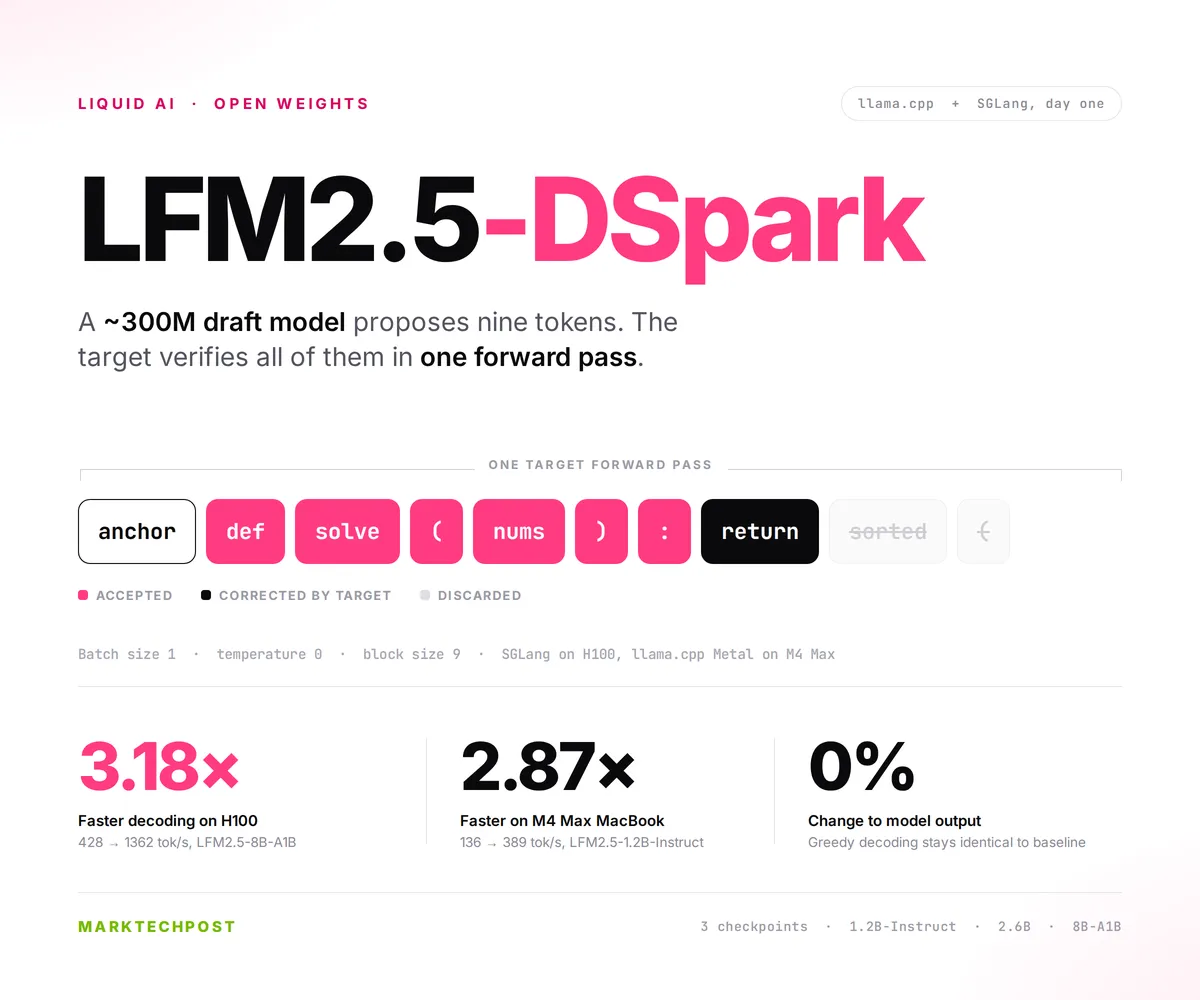
Liquid AIはAIの応答速度を最大3.18倍速くする技術を発表。AIの答えは変わらず、高速化でより多くの場所でAIが使いやすくなります。
Liquid AIは、LFM2.5ファミリーの3つのモデル、LFM2.5-1.2B-Instruct、LFM2.5-2.6B、およびLFM2.5-8B-A1B向けに、DSpark draft model checkpointsをリリースしました。それぞれのdrafterは、既存のtarget modelにspeculative decodingパスを追加します。約3億パラメータのdraftが9つの候補トークンのブロックを提案し、target modelは単一のforward passでブロック全体を検証します。このトレードオフは、わずかなメモリ増加と引き換えに、大幅なdecoding速度の向上をもたらします。H100では最大3.18倍、M4 Max MacBook Proでは最大2.87倍の高速化です。出力は変更されません。greedy decodingでは、出力されるシーケンスはtarget modelが単独で実行した場合と同一であるため、ベンチマークの精度は変わりません。llama.cppとSGLangの両方が初日からサポートしています。デプロイ可能か?はい、自己ホストする場合です。ウェイトはSafetensorsとGGUFとして提供され、drafter checkpointsは現在、Hugging Face上のどのホスト型推論プロバイダーからも提供されていません。これらを実行するには、LFM2ターゲット向けのDSparkサポートを備えたSGLangまたはllama.cppのビルドが必要です。企業レベル:LFM Open License v1.0は、年間収益が1000万ドル未満の企業に限り、無料での商用利用を許可しています。個人開発者、スタートアップ、中小企業は対象となります。大企業はまずLiquid AIに商用ライセンスについて問い合わせる必要があります。産業:開発者ツール、ローカルで動作する消費者向けアプリ、ロボティクスおよび組み込みシステム、さらにデータがオンプレミスまたはオンデバイスに保持されるヘルスケア、金融、防衛のワークロード。アプリケーション:ローカルのコーディングアシスタント、各ツール呼び出し前に推論を行うオンデバイスエージェント、バッチサイズが1のシングルユーザーチャット、ラップトップクラスのハードウェアでのオフラインコパイロット。Draftersとは?speculative decodingは、小さなモデルを使用してトークンを提案し、より大きなモデルがそれを検証するものです。各LFM2.5 drafterは約3億パラメータです。具体的には、1.2B-Instructターゲットでは2億9570万、2.6Bおよび8B-A1Bターゲットでは3億2770万です。バックボーンは、hidden_size=2048、intermediate_size=6144、8つのKVヘッドに対して32ヘッドのGQA、ブロックサイズが9の5つのfull-attention layersです。drafterは語彙ウェイトを供給しません。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。