メタ、音声認識AIを一つに統合
Meta Superintelligence Labs Releases Muse Voice Transcribe: One Real-Time Model for Streaming ASR, Diarization, and Endpointing
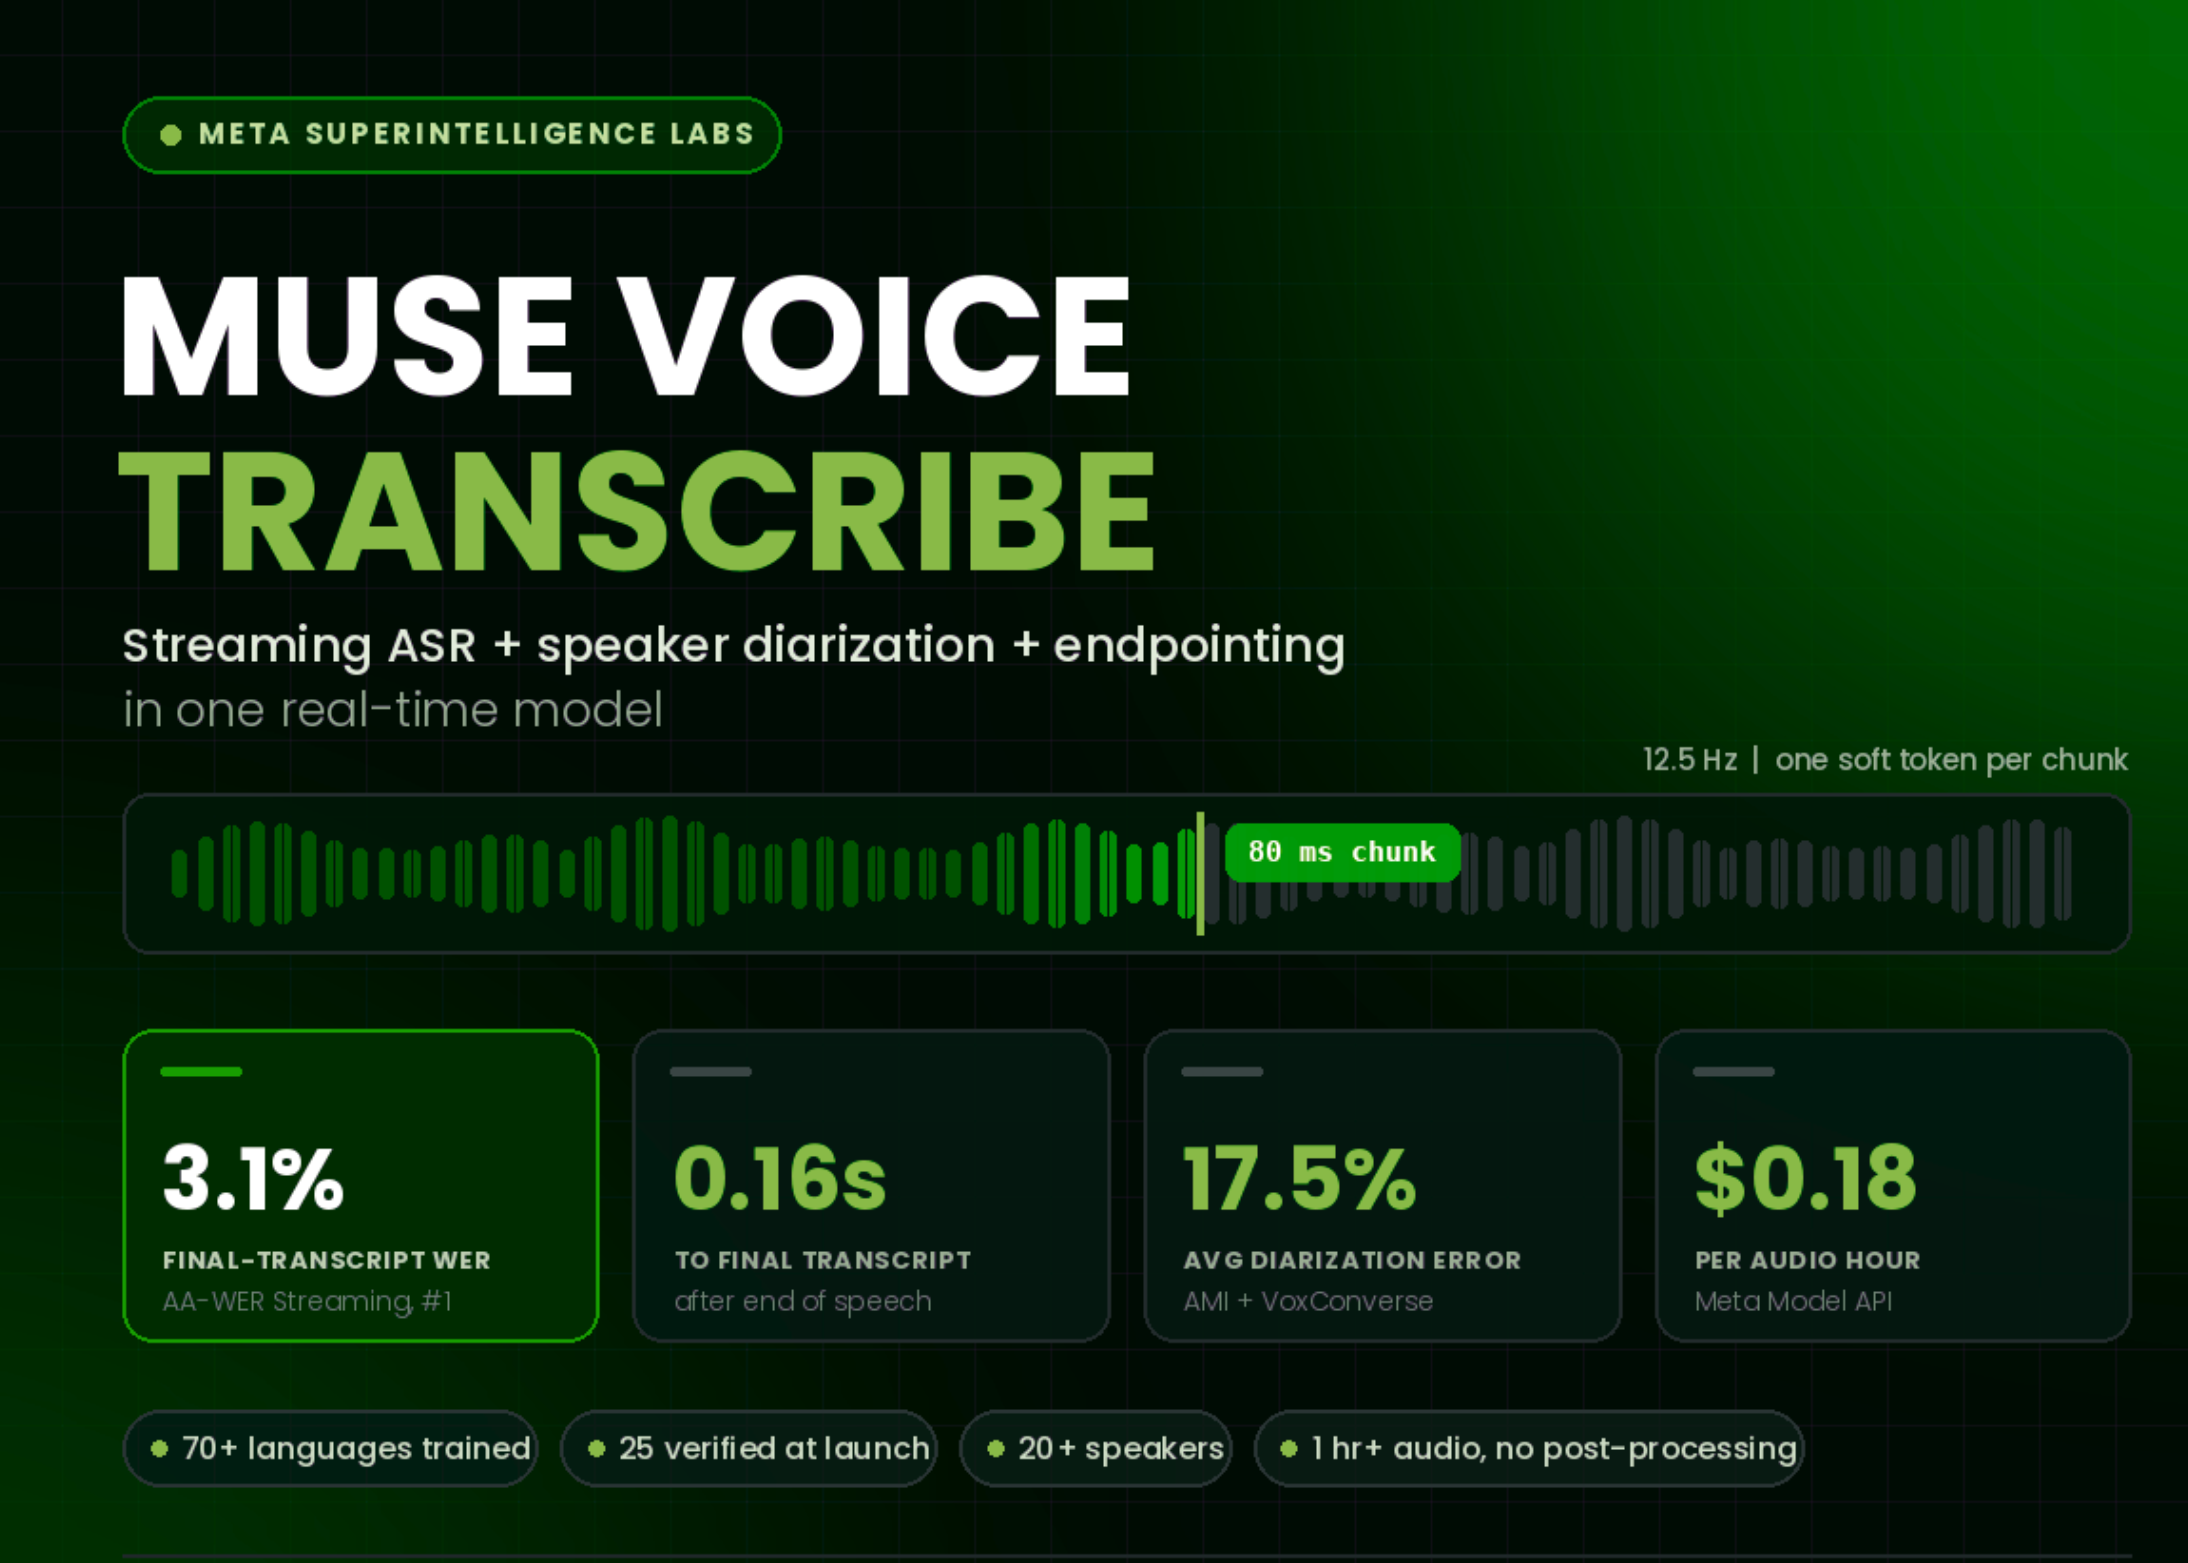
Metaが音声認識、話者分離、終了判定を1つのAIに統合した「Muse Voice Transcribe」を発表。これにより、音声AIの遅延が減り、よりスムーズな対話が可能になります。
ほとんどの商用音声システムは、3つのシステムを組み合わせたものです。1つのモデルが文字に起こし、2つ目が話者を分離し、検出器がユーザーが話し終えたかどうかを判断します。それぞれの引き渡しは遅延と新たな障害モードを追加します。Meta Superintelligence Labsが今週発表したMuse Voice Transcribeは、これら3つの仕事を単一のautoregressiveモデルに統合します。Metaはこれを初のリアルタイム音声認識モデルと呼んでいます。これは、ストリーミングASR、20人以上の話者に対するspeaker diarization、そしてendpointingを1回の処理で行い、後処理は不要です。これは展開可能か?はい、ただしホスト型APIとしてのみです。Meta Model APIでmuse-voice-transcribe-1.0として、音声1,000分あたり3.00ドル(1時間あたり0.18ドル)で利用可能で、すでにMeta AI for MacおよびMuse Codeの音声入力機能に採用されています。ウェイトは公開されていないため、自己ホストの道はありません。Streaming ASRを基盤として、Muse Voice TranscribeはMuse Sparkファミリーのautoregressive multimodalモデルです。音声は80msのチャンクで12.5 Hzで到着します。各チャンクは単一のソフトトークンに変換されます。各チャンクの後、モデルは1つの二者択一を行います。それは<|next_audio|>トークンを予測して聞き続けるか、テキストトークンを出力するかのどちらかです。モデルが<|next_audio|>を予測すると、そのトークンは入力内の実際の次の音声チャンクに置き換えられます。ストリームが終了すると、<|empty_audio|>トークンが挿入され、モデルは追加の音声を要求することなく残りのテキストをすべて出力します。聞き取りと書き込みは1つのdecoder loopを共有するため、ズレるような別々のalignment stageはありません。RLで訓練された適応型遅延。モデルはいつ聞くかを制御するため、各単語の背後にある音声コンテキストの量も制御します。Metaはこのギャップを「delay」と呼んでいます。delayが長いほど、より正確な文字起こしと高いlatencyを意味します。Metaはそのトレードオフを固定する代わりに、それを訓練します。Reinforcement learningは単語エラー率報酬とdelay報酬を乗法的に組み合わせ、難易度に応じて単語ごとのdelayを変化させるポリシーを生成します。Metaはこれを報告しています。
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。