AIが自分で賢くなる新技術
Google Research Open-Sources RRSI: AI Agents That Improve Their Own Harness Without Overfitting
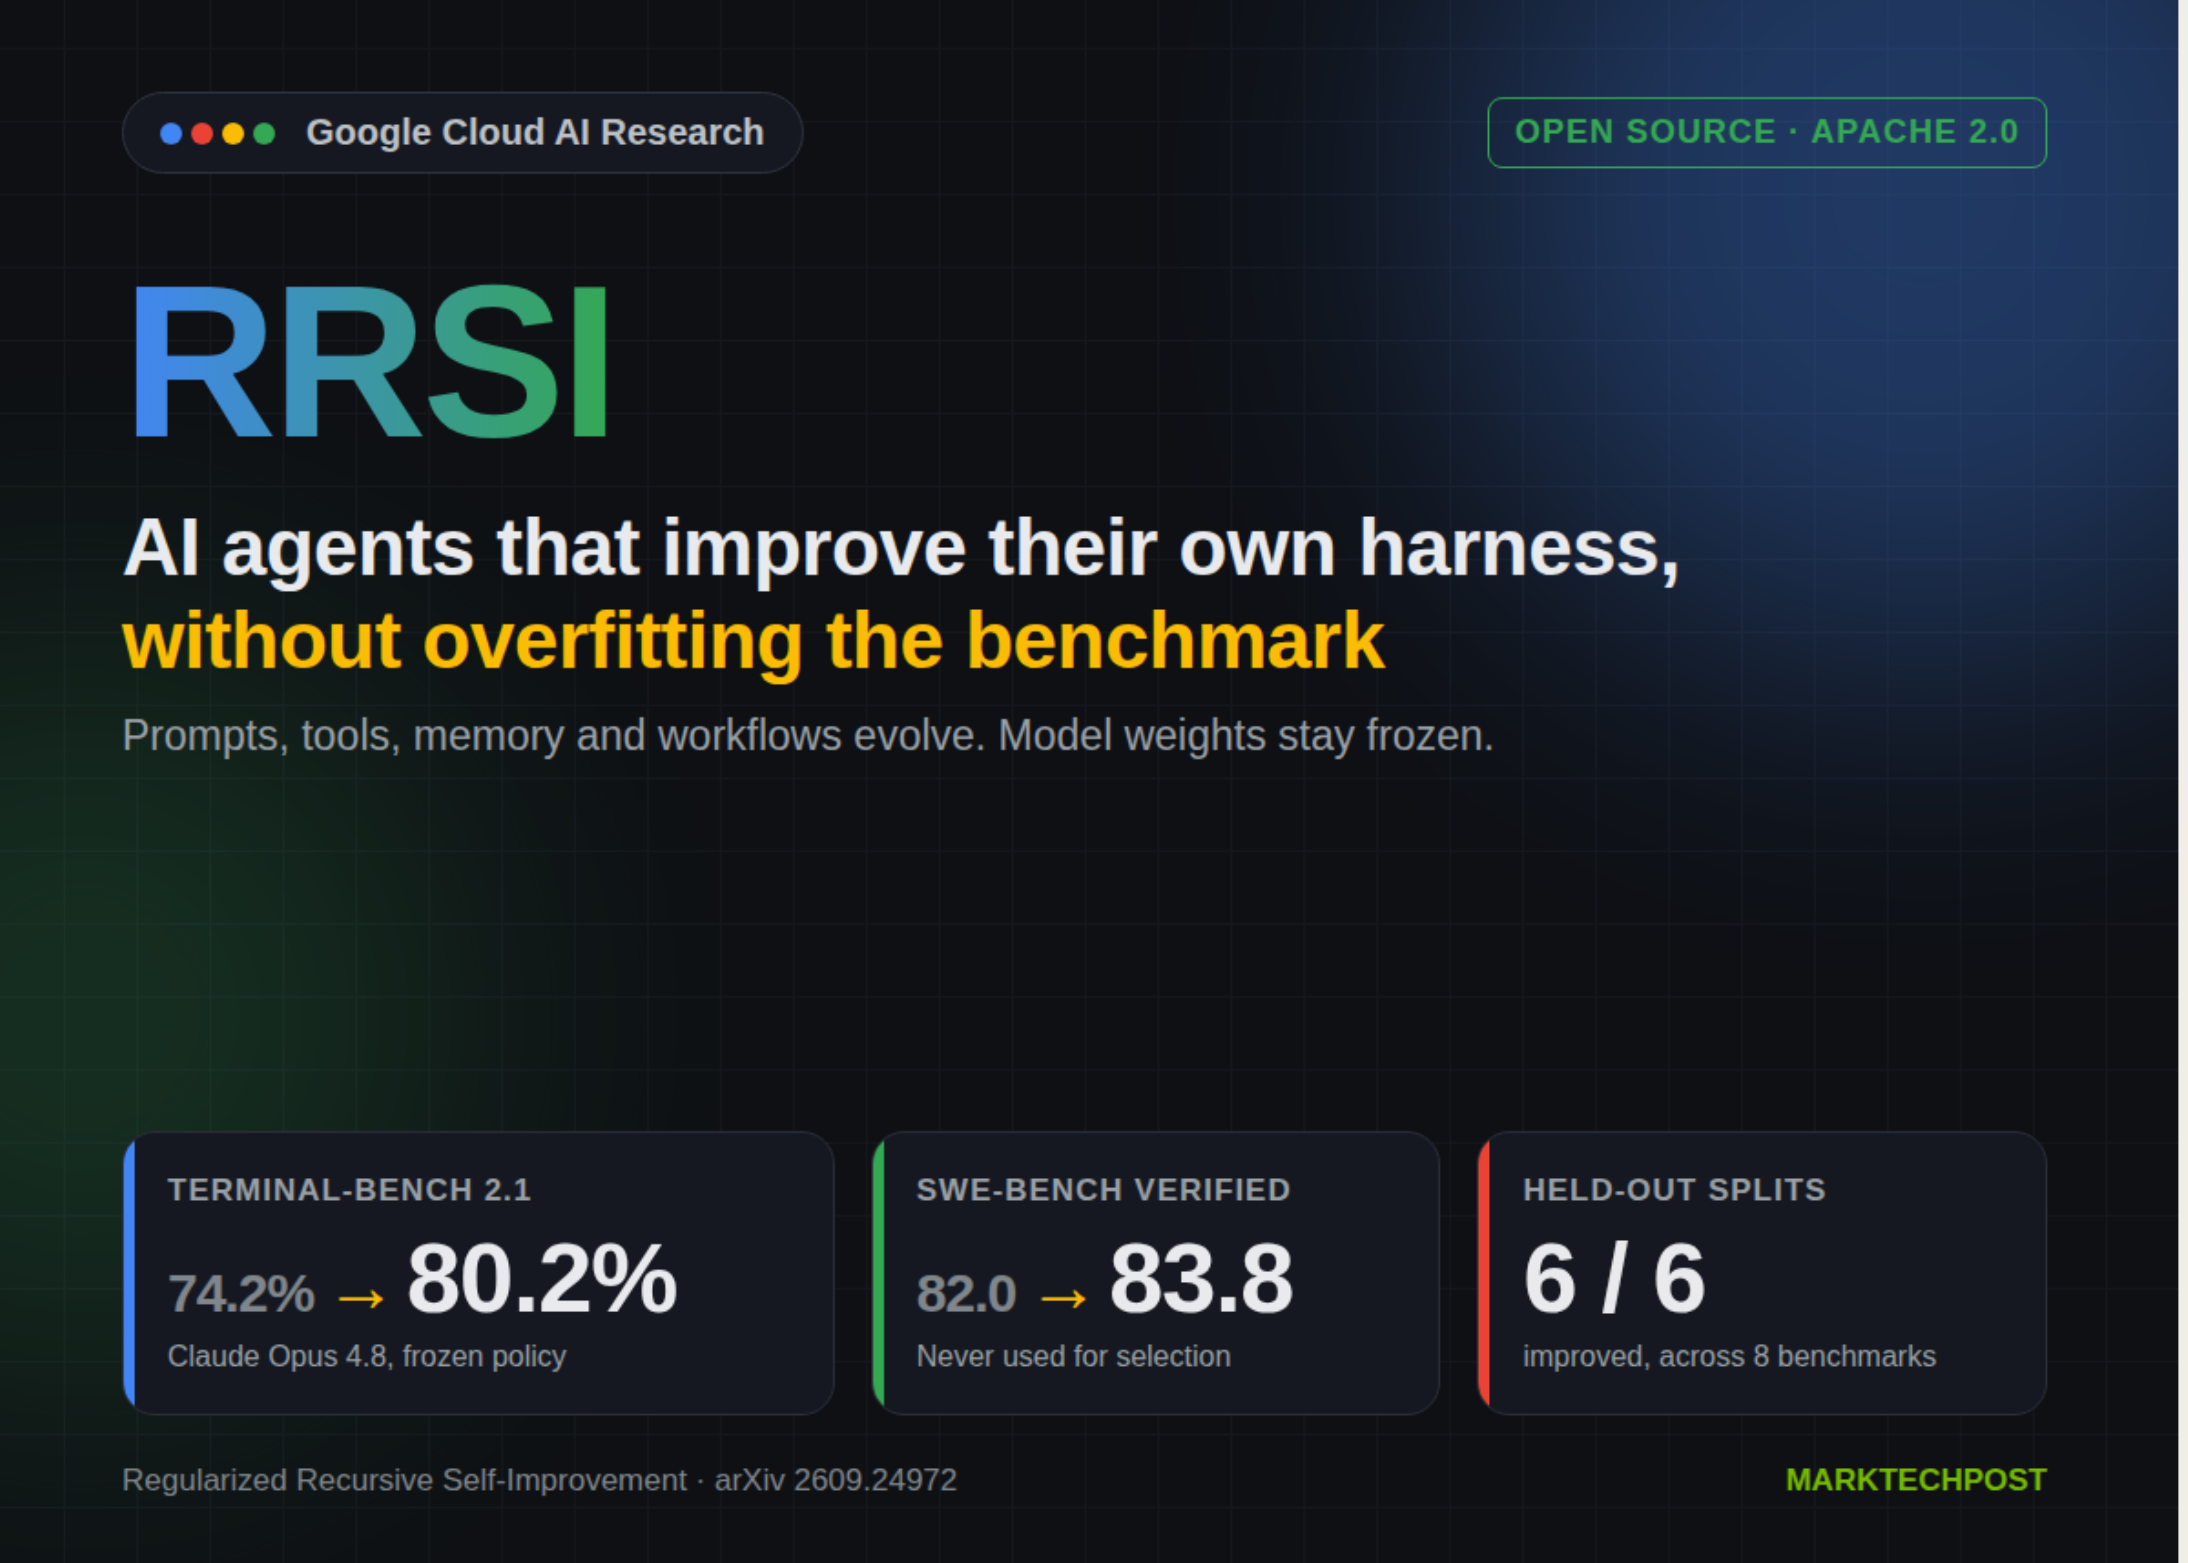
Googleが、AIが自分で学習方法を改善する新技術RRSIを公開。特定のデータに偏らず、より賢いAIの開発に役立ちます。
Google Cloud AI Researchは、UNC-Chapel Hill、Stanford、Washington University in St. Louisと共同で、RRSI (Regularized Recursive Self-Improvement) をリリースしました。これは、LLM agentが自身のharness(プロンプト、ツール、メモリ、制御フロー、サブエージェント)を書き換えることを可能にします。モデルの重みは一切変更されません。RRSIは改善ループ自体を制約するため、agentが最適化対象としなかったベンチマークでも改善が持続します。展開可能か?はい、研究フレームワークとして可能です。コードはApache 2.0ライセンスで、Python 3.10+が必要であり、任意のLiteLLMモデル文字列を受け入れます。デフォルトでは、Vertex AI上のClaude Opus 4.8を想定しています。Why Self-Improving Harnesses Overfit
Harnessの進化ループは、編集案を提案し、固定された進化セットでスコアを付け、勝者を保持します。同じタスクが毎回再利用されるため、ループはそれらを記憶してしまう可能性があります。RRSIの研究では、3つの失敗モードを挙げています。ベンチマーク固有の適合、ノイズ追跡、複雑性の蓄積です。それぞれが、進化セットのスコアと実際の転移能力との間のギャップを広げます。How RRSI Works
RRSIは、harnessのすべてのコンポーネントを編集可能に保ちます。その代わりに、探索の動き方を正則化します。Proposal side
Annealed edit budget: コサインスケジュールにより、初期のラウンドでは複数の編集をまとめて行えます。後期のラウンドでは、単一の帰属可能な変更のみを許可します。Evidence-aware credit: 各候補は、そのコンポーネント、仮説、差分、スコアの変化、コストの変化とともに記録されます。提案者はこの台帳を読み、誤ったアイデアは再試行されません。Structured exploration: ノイズ帯域内で進捗が停滞した場合、予算は実行中に一度も触れられなかったコンポーネントにシフトします。Selection side
Leakage critic: スコアリングの前に、タスク名、エンティティ、回答、またはベンチマーク固有のロジックを拒否します。Noise-adjusted floor: 改善は、変更されていないベースharnessで測定された分散をクリアする必要があります。Cost rule: 追加の推論トークンは、測定されたゲインによって支払われる必要があります。Pruning: ゲインを生み出さなくなったコンポーネントは削除のターゲットとなります。研究チームはこれらを古典的な正則化手法のアナロジーとして捉えています。編集予算はL0に、プルーニングはLasso (L1)に、コストルールはRidge (L2)にそれぞれ対応します。Resu
この記事について質問
記事の内容に答えます。記事外のことは都度ウェブで調べます。